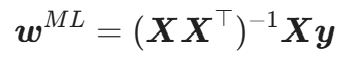在 Day 3 中,我们学习了机器学习算法的优化算法与评价指标,今天通过简单的线性回归模型来具体了解机器学习的一般过程,以及不同学习准则(经验风险最小化、结构风险最小化、最大似然估计、 最大后验估计)之间的关系。
1. 线性回归
线性回归是一种对自变量和因变量之间关系进行建模的回归分析。自变量数量为 1 时称为简单回归,自变量数量大于 1 时称为多元回归。
从机器学习的角度来看,自变量就是样本的特征向量 𝒙 ∈ ℝ𝐷(每一维对应一个自变量),因变量是标签 𝑦 ,这里 𝑦 ∈ ℝ 是连续值(实数或连续整数)。假设空间是一组参数化的线性函数:
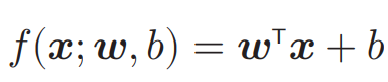
其中权重向量 𝒘 ∈ ℝ𝐷 和偏置 𝑏 ∈ ℝ 都是可学习的参数,函数 𝑓(𝒙; 𝒘, 𝑏) ∈ ℝ 也称为线性模型。
上述线性模型可以用更简单的形式表达:
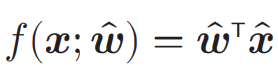
其中 𝒘̂ 和 𝒙̂ 分别称为增广权重向量和增广特征向量:
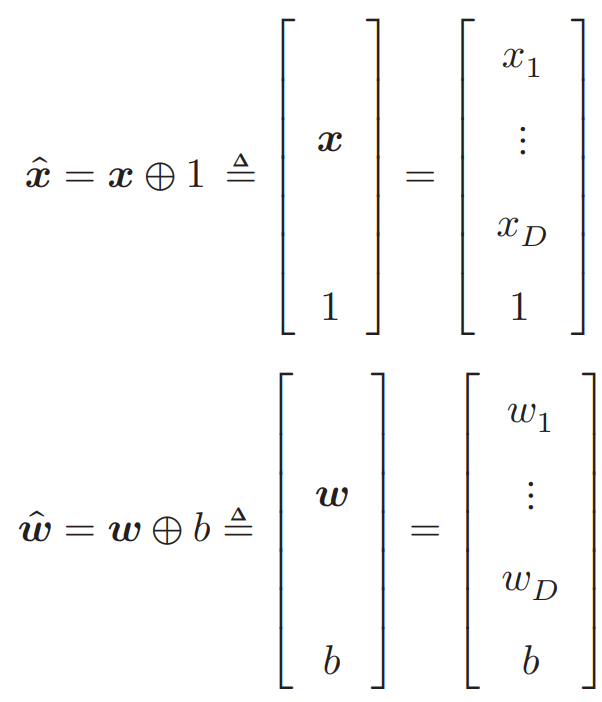
其中⊕定义为两个向量的拼接操作。
不失一般性,后面直接用 𝒘 和 𝒙 分别表示增广权重向量和增广特征向量。这样,线性回归的模型简写为 𝑓(𝒙;𝒘) = 𝒘T𝒙 。
2. 参数学习
给定一组包含 𝑁 个训练样本的训练集:
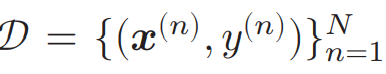
我们希望能够学习一个最优的线性回归的模型参数 𝒘 。通常有如下四种不同的参数估计方法:
经验风险最小化
结构风险最小化
最大似然估计
最大后验估计
经验风险最小化
由于线性回归的标签 𝑦 和模型输出都为连续的实数值,因此平方损失函数非常合适衡量真实标签和模型预测之间的差异。根据经验风险最小化准则,训练集 𝒟 上的经验风险定义为:
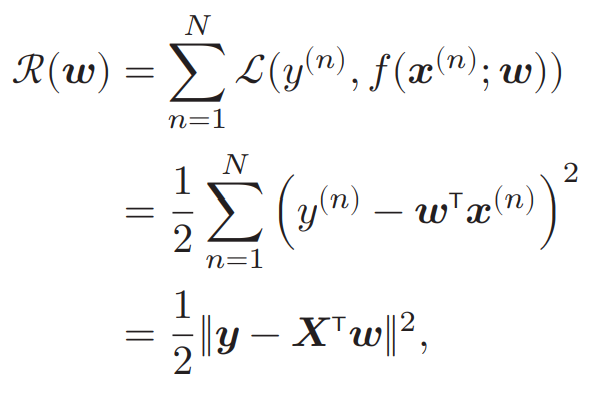
其中 𝒚 ∈ ℝ𝑁 是由所有样本的真实标签组成的列向量,而 𝑿 ∈ ℝ(𝐷+1)×𝑁 是由所有样本的输入特征 𝒙(1), ⋯ , 𝒙(𝑁) 组成的矩阵。
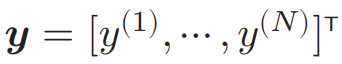
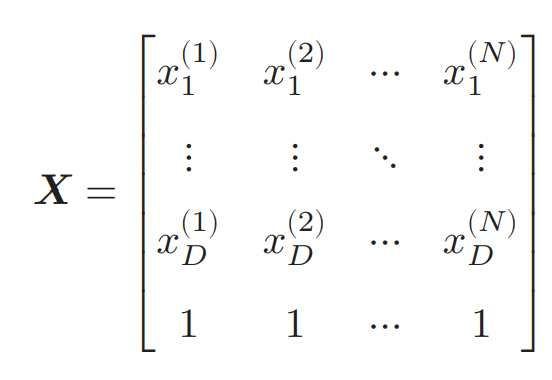
风险函数 ℛ(𝒘) 是关于 𝒘 的凸函数,其对 𝒘 的偏导数为
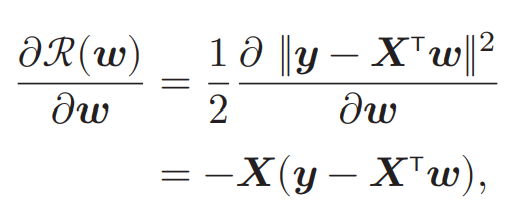
令上式为 0 ,得到最优的参数 𝒘* 为:
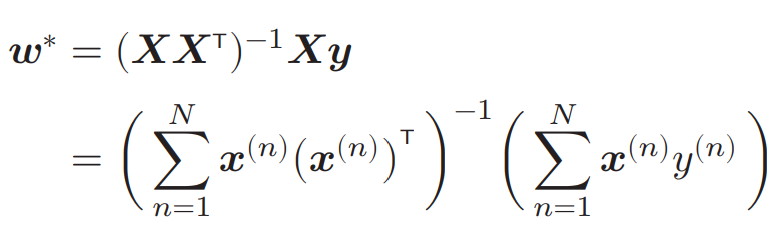
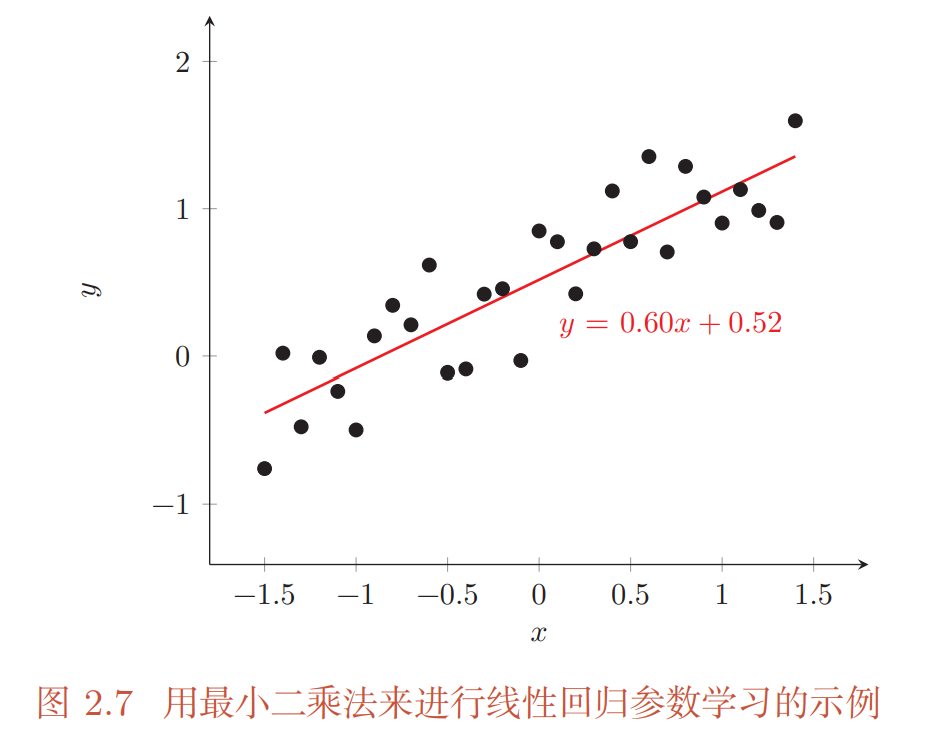
这种求解线性回归参数的方法也叫最小二乘法(Least Square Method,LSM)。下图给出了一个用最小二乘法来进行线性回归参数学习的示例:
这里需要注意,在上述最优的参数 𝒘* 的推导过程中,𝑿𝑿T 需要是满秩的。这就是说,𝑿 中的行向量之间是线性无关的,即 𝑿 的各行向量(各特征维度)之间线性无关。显然这个条件有时候可能不成立。例如,当样本数量 𝑁 小于特征数量 (𝐷 + 1 ) 时,𝑿𝑿T 的秩至多为 𝑁 ,这时会存在很多解 𝒘* ,可以使得偏导为 0 。
当 𝑿𝑿T 不可逆时,可以通过下面两种方法来估计参数:
先使用主成分分析(PCA)等方法来预处理数据,消除不同特征之间的相关性,然后再使用最小二乘法来估计参数。
使用梯度下降法来估计参数。先初始化 𝒘 = 0 ,然后通过下面公式进行迭代:
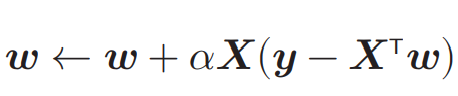
其中 𝛼 是学习率。这种利用梯度下降法来求解的方法也称为最小均方(Least Mean Squares,LMS)算法。
结构风险最小化
最小二乘法的基本要求是各个特征之间要互相独立,即 𝑿𝑿T 可逆。但是,即使 𝑿𝑿T 可逆,如果特征之间有较大的多重共线性,也可能使得 𝑿𝑿T 的逆在数值上无法准确计算。在数据集 𝑿 上的一些小的扰动就会导致 (𝑿𝑿T)−1 发生大的改变,进而使得最小二乘法的计算变得很不稳定。
注:共线性指的是,一个特征可以通过其他特征的线性组合来较准确地预测。
一个比较好的解决方案是岭回归。岭回归的思想是,给 𝑿𝑿T 的对角线元素都加上一个常数 𝜆 使得 (𝑿𝑿T + 𝜆𝐼) 满秩。最优参数 𝒘* 为:
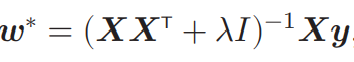
其中 𝜆 > 0 为预先设置的超参数,𝐼 为单位矩阵。
岭回归的解 𝒘* 可以看作结构风险最小化准则下的最小二乘法估计,其目标函数可以写为:
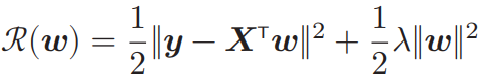
其中 𝜆 > 0 为正则化系数。
最大似然估计
上述两个采用最小二乘法的参数估计方法,相当于是建模了特征 𝒙 和标签 𝑦 之间的函数关系。我们也可以考虑建模条件概率 𝑝(𝑦|𝒙) 的概率分布。从这个意义上,我们认为真实条件概率分布是未知但确定的。
假设标签 𝑦 为一个随机变量,并由函数 𝑓(𝒙;𝒘) = 𝒘T𝒙 加上一个随机噪声 𝜖 决定,即
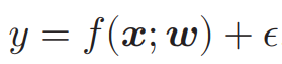
需要注意的是,这里我们认为 𝒙 是一个具备确定值的参数(这是因为在条件概率 𝑝(𝑦|𝒙) 中,𝒙 已经被条件化了)。假设 𝜖 服从均值为 0 、方差为 𝜎2 的高斯分布(即正态分布),那么根据高斯分布的性质:
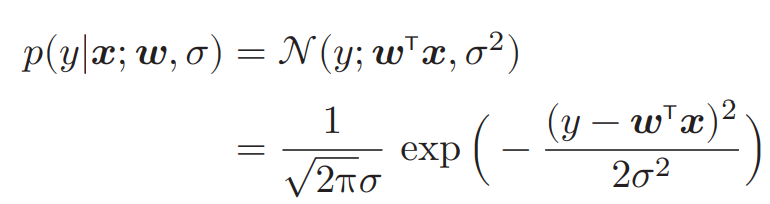
于是参数 𝒘 在训练集 𝒟 上的似然函数为(似然函数研究的是,在给定样本空间 𝑦 和 𝑿 时,不同的模型参数 𝒘 对条件概率分布的影响):
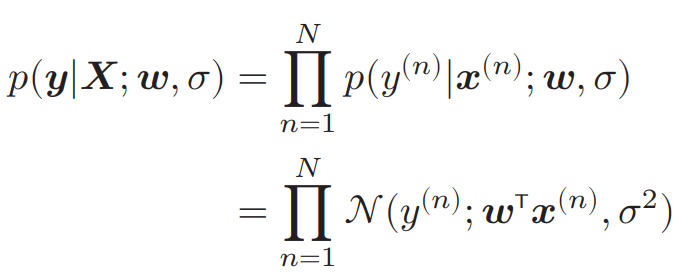
这里 𝒚 = [𝑦(1), ⋯ , 𝑦(𝑁)]T 为所有样本标签组成的向量,𝑿 = [𝒙(1), ⋯ , 𝒙(𝑁)]为所 有样本特征向量组成的矩阵。
为了方便计算,对似然函数取对数得到对数似然函数:
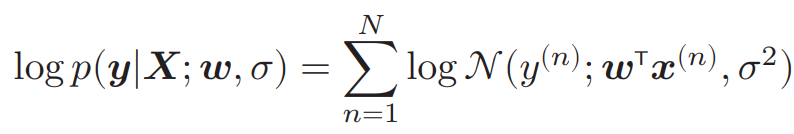
对上述对数似然函数采用最大似然估计方法,即寻找参数 𝒘 使得对数似然函数最大。令对数似然函数对参数 𝒘 的偏导为 0 ,可以得到最优的参数 𝒘𝑀𝐿 为:
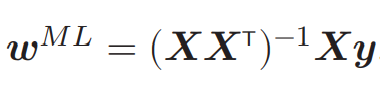
可以看出,最大似然估计的解和最小二乘法的解相同。
具体推导过程见本笔记最后一节。
最大后验估计
最大似然估计的一个缺点是当训练数据比较少时会发生过拟合,估计的参数可能不准确。为了避免过拟合,我们可以给参数加上一些先验知识。
我们可以假设参数 𝒘 并非像最大似然估计中一样是一个点,而是服从一个先验分布 𝑝(𝒘;𝜈) 的随机变量。先验分布一般是根据我们的经验设定的。简单起见,可以假设 𝑝(𝒘;𝜈) 服从一个各向同性的高维高斯分布:
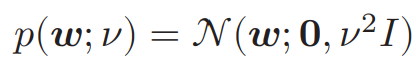
其中 𝜈2 为每一维上的方差。
在见到训练集后,我们可以根据贝叶斯公式来计算参数 𝒘 的后验概率分布,即:
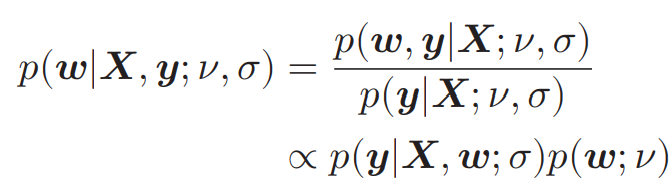
其中 𝑝(𝒚|𝑿,𝒘;𝜎) 为 𝒘 的似然函数,𝑝(𝒘;𝜈) 为 𝒘 的先验。
这种估计参数 𝒘 的后验概率分布的方法称为贝叶斯估计,是一种统计推断问题。采用贝叶斯估计的线性回归也称为贝叶斯线性回归。
贝叶斯估计最终输出的不是一个确定的参数值,而是一整条概率密度曲线。我们可以求出参数落在某个置信区间内的概率(即“区间估计”与不确定性量化)。如果我们希望得到一个最优的参数值(即点估计),可以使用最大后验估计(MAP),即选取后验分布中概率密度最高的参数 𝒘 :
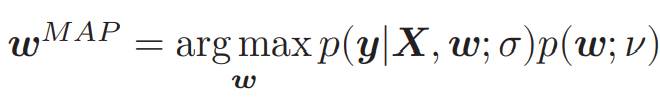
如果我们假设上式中 𝒘 的似然函数就是最大似然估计中讨论的似然函数,可以计算得到后验分布的对数为:
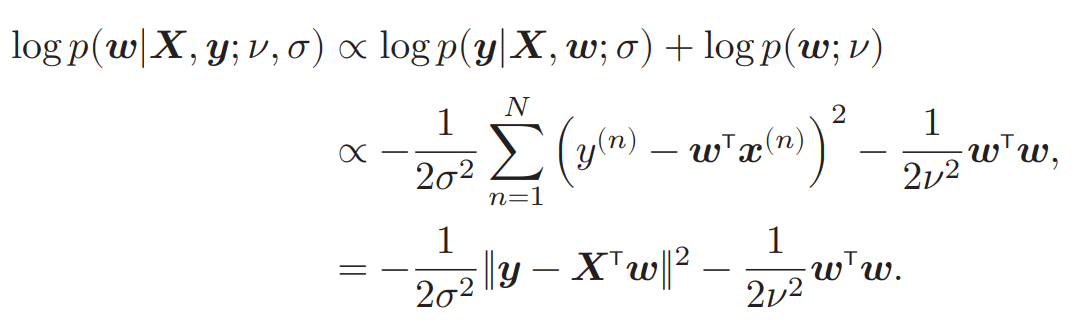
由上式可知,最大后验概率等价于平方损失的结构风险最小化,其中正则化系数 𝜆 = 𝜎2/𝜈2 。
最大似然估计和贝叶斯估计可以分别看作频率学派和贝叶斯学派对需要估计的参数 𝒘 的不同解释。当 𝜈 → ∞ 时,先验分布 𝑝(𝒘;𝜈) 退化为均匀分布,称为无信息先验,最大后验估计退化为最大似然估计。
3. 我的思考
最大似然估计中最优参数的计算
本节中,我来尝试推导一下最大似然估计的解。
一维高斯分布的概率密度为:
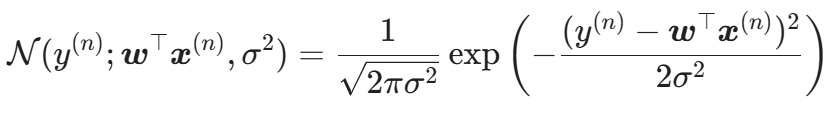
两边取对数:
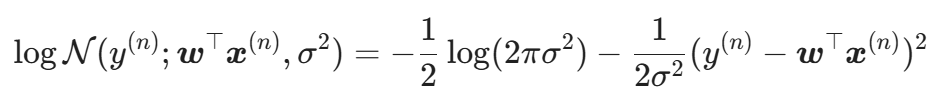
将所有 N 个独立样本累加,得到对数似然函数:
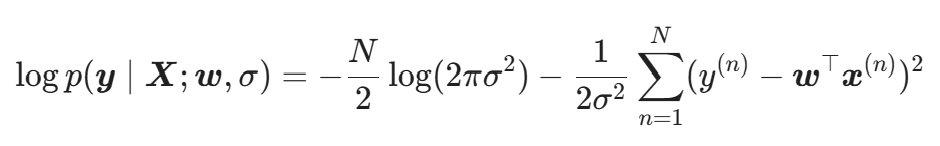
我们的目标是求解出使对数似然函数最大的参数 𝒘 。显然上式中,第一项与 𝒘 无关,第二项的系数 1 / (2σ2) 也与 𝒘 无关。
利用求导的线性性质与链式法则,仅需对求和项内的二次项求偏导:
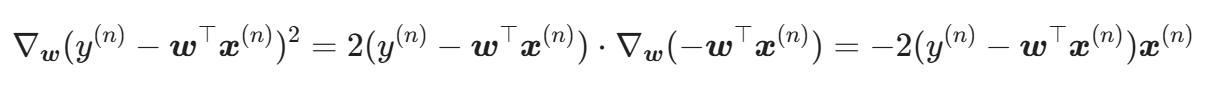
代入对数似然函数中:
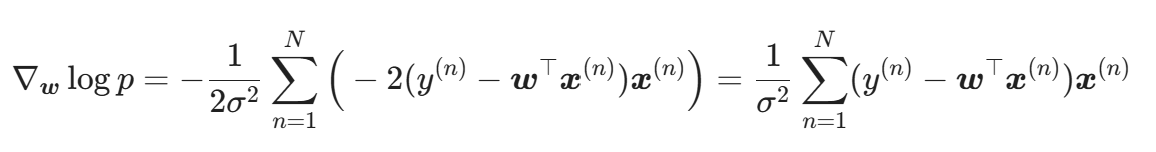
令上述偏导项为 0 ,得到:
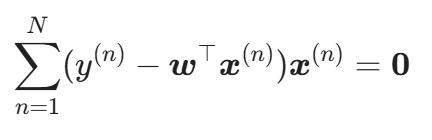
拆开括号并移项:
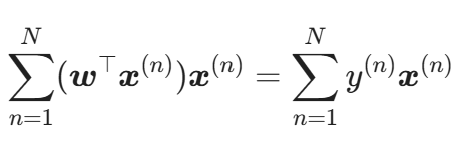
上式可以写作:
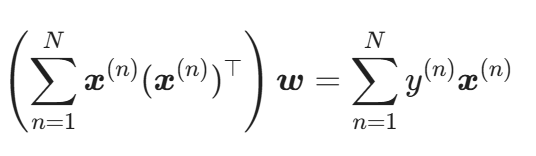
按照我们之前所说的定义:
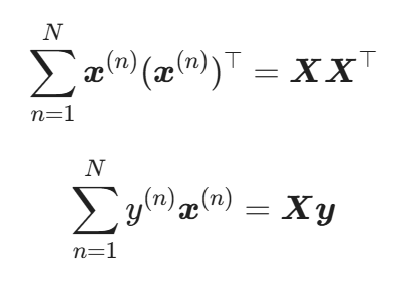
于是待回方程可得:
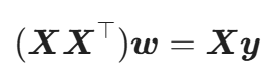
当 𝑿𝑿T 可逆时,两边左乘逆矩阵即可解得极大似然估计值: