

在 Day 6 中学习了机器学习算法的类型与数据的特征表示,今天来学习一些机器学习领域中比较有指导性的理论。
1. PAC 学习理论
计算学习理论是一套能够分析问题难度、计算模型能力,为学习算法提供理论保证,并指导机器学习模型和学习算法的设计的理论。其中最基础的是可能近似正确(Probably Approximately Correct,PAC)学习理论。
机器学习中有一个重要的研究对象:期望错误和经验错误之间的差异,即泛化错误。泛化错误可以衡量一个机器学习模型 𝑓 是否可以很好地泛化到未知数据。
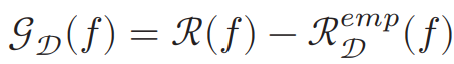
在有些文献中,将上述定义称为 “泛化差距” ,将期望错误称为 “泛化错误” 。需要具体语境具体分析。
由大数定律,当训练集大小 |𝒟| 趋向于无穷大时,经验错误趋近于期望错误,即:
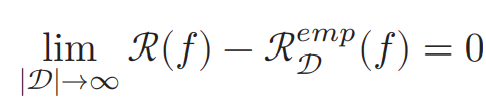
由于训练样本是有限的,我们不能希望从中学习到一个泛化错误为 0 的模型。不过,我们可以降低一些希望,只要求学习算法可以以一定的概率学习到一个近似正确的假设,即 PAC 学习。一个 PAC 可学习的算法是指该学习算法能够在多项式时间内从合理数量的训练数据中学习到一个近似正确的 𝑓(𝒙) 。
顾名思义,PAC 学习包含两个部分:
近似正确:一个 “近似正确” 的假设 𝑓 ,是指 𝑓 的泛化错误存在一个上界 𝜖(一般 0 < 𝜖 < 0.5)
可能:一个学习算法 𝒜 有 “可能” 以至少 1 − 𝛿 的概率学习到这样一个 “近似正确” 的假设。一般 0 < 𝛿 < 0.5 。
形式化地来表述,就是:
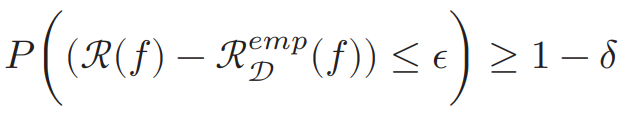
其中 𝜖、𝛿 是和样本数量 𝑁 以及假设空间 ℱ 相关的变量。如果我们固定 𝜖、𝛿 ,可以反过来计算出需要的样本数量:
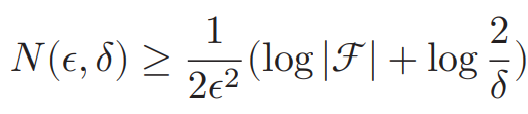
其中 |ℱ| 为假设空间的大小。不难发现,随着模型复杂度提升(|ℱ| 增大),为了达到相同的泛化能力(𝜖 不变),我们往往需要更多的训练样本数。如果我们无法做到提供更充足的训练样本,就需要通过正则化手段限制模型复杂度。
需要注意的是:上述样本复杂度仅针对有限假设空间;对于连续参数的无穷假设空间,需用 VC 维或 Rademacher 复杂度进行容量替代。
2. 没有免费午餐定理
没有免费午餐定理(NFL)是最优化理论中的一个定理,它证明了一件事:对于基于迭代的最优化算法,不存在某种算法对所有问题(有限的搜索空间内)都有效。
NFL 在机器学习中也适用,它告诉我们:不存在一种机器学习算法适合于任何领域或任务。
我们可以举一个简单的例子。对于一个几千样本数的表格式数据集上的分类任务,往往传统的决策树方法(如 GBDT )比神经网络方法(如 MLP )表现更佳;对于一个百万样本数的生成式推荐任务,往往基于大参数量 Transformer 的方法表现更优。
3. 奥卡姆剃刀原理
奥卡姆剃刀原理:“如无必要,勿增实体”。放到机器学习中来说就是:如果有两个性能相近的模型,我们应该选择更简单的那个。因为简单的模型泛化能力也更好。
奥卡姆剃刀的一种形式化是最小描述长度 (Minimum Description Length,MDL)原则,即对一个数据集 𝒟,最好的模型 𝑓 ∈ ℱ 会使得数据集的压缩效果最好,即编码长度最小。
有关奥卡姆剃刀的 MDL 解释,参见“我的思考”一节。
4. 丑小鸭定理
丑小鸭定理是一个很有意思的定理,它说的是:丑小鸭与白天鹅之间的区别和两只白天鹅之间的区别一样大。这里的丑小鸭说的是白天鹅的幼崽。
仔细思考之后,这个定理确实有它的道理:从外貌体型来看,两只白天鹅更像;但从血缘关系来看,丑小鸭与它父母的差别确实小于它父母与其它陌生白天鹅之间的差别。
形式化地来说,就是:如果不加任何先验偏好地考虑所有可能的谓词(属性),任意两个物体之间的相似程度在数学上是完全相等的。
有关丑小鸭定理对机器学习的指导意义,参见“我的思考”一节。
5. 归纳偏置
在机器学习中,很多学习算法经常会对学习的问题做一些假设,这就是归纳偏置(在贝叶斯学习中也常被称为先验)。比如在最近邻分类器中,我们会假设在特征空间中,一个小的局部区域中的大部分样本同属一类。在朴素贝叶斯分类器中,我们会假设每个特征的条件概率是互相独立的。
深度学习的许多模型也包含了归纳偏置:
卷积神经网络假设数据具有局部性和平移不变性
循环神经网络假设数据具有序列依赖性
Transformer 假设序列中任意位置之间都可能存在依赖关系
图神经网络假设节点的表示应当受邻居影响
选择合适的归纳偏置是模型设计的重要环节。
我的思考
奥卡姆剃刀的 MDL 解释
最小描述长度(MDL)原则的核心思想是:学习的本质就是数据压缩,而最好的模型就是能用最少的信息量把数据完整记录下来的那个模型。
例如,我们需要把手头 1000 条带噪声的观测数据(x, y)通过一条数据线发送给远方的协作者。我们有两种发送方式:
直接把这 1,000 个点的原始坐标数据一个一个发送过去。这种传输的数据量非常庞大。
我们从这 1000 条观测数据中发现了一些规律,比如存在一个拟合函数 𝑓(x) 能很好地描述这批数据。在这种情况下:
先把模型的描述信息发送过去
再把每个数据点的真实值相对于拟合值的偏差发送过去。
根据上面的例子,我们得到了一个公式:总传输信息量 = 描述模型需要的比特数 + 描述模型残差需要的比特数。
最小描述长度(MDL)原则就是:寻找一个最优的模型 𝑓 ,使得这两部分加起来的总长度最小。
香农在信息论中告诉我们:一个概率为 p 的事件发生时,它所包含的信息量(以及用二进制对其进行无损编码所需的最小理想比特数)为 -log2p 。因此,结合贝叶斯学习的思想,我们就能用 MDL 来解释奥卡姆剃刀原则。
考虑模型 𝑓 在数据集 𝒟 上的对数后验概率为:
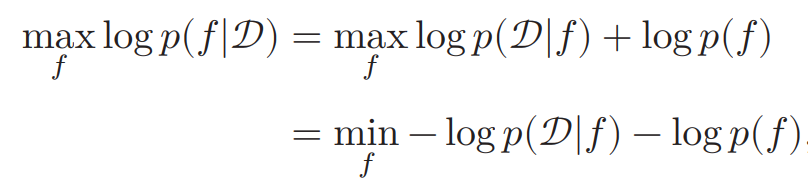
对于第二项,𝑝(𝑓) 指的是模型的先验概率。我们一般假设简单平滑的函数发生的先验概率更大。𝑝(𝑓) 较大的模型,− log 𝑝(𝑓) 就较小。因此,我们可以用较短的编码长度来描述一个简单的模型。
对于第一项,− log 𝑝(𝒟|𝑓) 就可以理解为:在给定模型后,描述数据的编码长度。如果模型对数据拟合得很好,拟合值与真实值误差极小,那么记录这批残差所需的信息量就很小。因此,我们可以用较短的编码长度来描述一个对数据集拟合良好的模型。
综合以上两点,我们可以发现:MDL 原则的本质就是,我们应当寻找一个既能良好拟合数据集,又比较简单的模型。这与奥卡姆剃刀的思想不谋而合。如果用 Day 5 中学习的偏差-方差分解的语言来说,就是:最优模型既应该偏差小(良好拟合数据集),又应该方差小(比较简单)。
丑小鸭定理对机器学习的指导意义
丑小鸭定理告诉我们,不存在一种完全客观、通用的数据相似度衡量原则。
特征选择与特征加权的必然性
拒绝无差别的属性堆叠:构建模型不能指望“特征越多越好”。包含过多与任务无关的冗余或噪声属性,会稀释核心模式,导致样本在几何空间中趋向等距(维度灾难)。
主观注入任务目标:选择哪些特征、赋予多大权重,必须由下游任务或业务目标反向决定。所谓“好的特征表示”,从来不是还原客观物理全貌,而是精准放大任务关心的差异、过滤不关心的扰动。
“归纳偏置” 的意义
纯客观聚类是不可能的:不存在任何一个算法能在不引入任何先验假设的前提下,将一堆数据“客观地”聚成几类。算法选用了欧氏距离、余弦相似度还是曼哈顿距离,本质上就已经把人类对特定几何空间的主观偏好强加给了模型。
模型结构的偏置注入:例如卷积神经网络(CNN)假定空间局部平移不变性,图神经网络(GNN)假定拓扑置换不变性。这些网络拓扑结构本身就是为了打破“丑小鸭与白天鹅等距”而人为注入的强归纳偏置。
“度量学习” 的基石
既然天然空间中没有客观相似度,现代深度学习便将重点转移到了学习一个由任务驱动的度量空间。
表示学习的目的:把输入映射到一个低维流形空间,使该空间中的距离能够表示任务所需的语义相似度。
对比学习的本质:SimCLR、CLIP 等前沿自监督范式,通过“数据增强”(裁剪、旋转、掩码)显式告诉模型:哪些变化算作“同一类”(正样本对),哪些变化算作“不同类”(负样本对)。这种通过数据增强构造监督信号的过程,正是在人为向模型灌输“看待丑小鸭与白天鹅的眼光”。