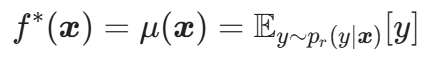在 Day 4 中,我们以简单的线性回归为例,学习了四种机器学习中最常见的参数估计方法。今天来一起学习偏差-方差分解。
1. 偏差-方差分解概述
我们经常会遇到一个问题:拟合能力强的模型一般复杂度会比较高,容易导致过拟合;相反,如果限制模型的复杂度,降低其拟合能力,又可能会导致欠拟合。因此,机器学习算法要解决的一个重要问题是,如何在模型的拟合能力和复杂度之间取得一个较好的平衡。
偏差-方差分解就是针对这个问题的一个很好的分析和指导工具。下面以回归问题为例来学习这个思想,但是结论也同样适用于分类问题。
2. 期望错误分解
假设样本的真实分布为 𝑝𝑟(𝒙,𝑦),并采用平方损失函数,模型 𝑓(𝒙) 的期望错误为:
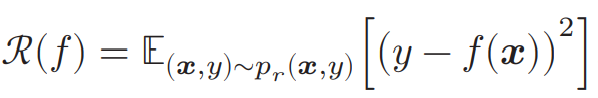
因此,最优的模型是:
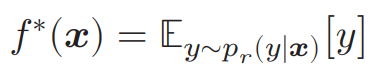
其中 𝑝𝑟(𝑦|𝒙) 为样本的真实条件分布,𝑓*(𝒙) 为使用平方损失作为优化目标的最优模型,其损失为:
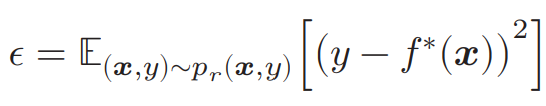
这里的损失 𝜖 通常是由于样本分布以及噪声引起的,无法通过优化模型来减少。
进一步地,期望错误可以分解为:
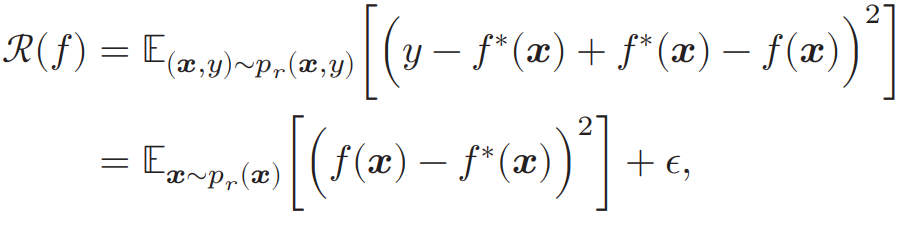
由我的思考部分的推导过程可以得到上述分解。
其中第一项是当前模型和最优模型之间的差距,是机器学习算法可以优化的真实目标。
3. 引入训练集后的建模(偏差-方差分解)
在第 2 节中,我们假设模型是在样本真实分布上训练的。但实际上,我们使用的训练集 𝒟 只是从真实分布 𝑝𝑟(𝒙,𝑦) 上独立同分布地采样出来的有限样本集合。不同的训练集会得到不同的模型。
令 𝑓𝒟(𝒙) 表示在训练集𝒟上学习到的模型,一个机器学习算法(包括模型以及优化算法)的能力可以用不同训练集上的模型的平均性能来评价。
对于单个样本 𝒙 ,不同训练集 𝒟 得到模型 𝑓𝒟(𝒙) 和最优模型 𝑓*(𝒙) 的期望差距为:
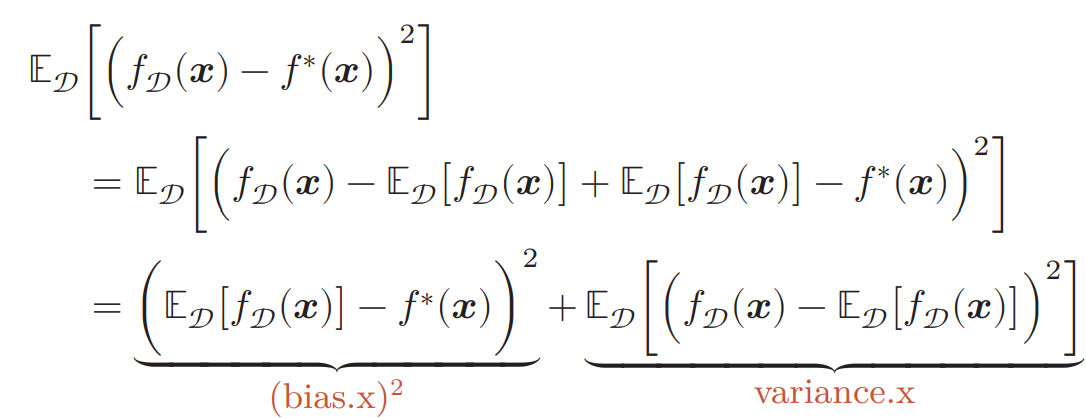
其中第一项为偏差(Bias),是指一个模型在不同训练集上的平均性能和最优模型的差异,可以用来衡量一个模型的拟合能力。第二项是方差(Variance),是指一个模型在不同训练集上的差异,可以用来衡量一个模型是否容易过拟合。
注:这里交叉项的期望是 0 ,证明该结论的思想在我的思考部分的推导过程中已经展示。
于是我们可以考虑用 𝔼𝒟[(𝑓𝒟(𝒙) − 𝑓*(𝒙))2] 来代替第 2 节中的 (𝑓(𝒙) − 𝑓*(𝒙))2 ,这就得到了:
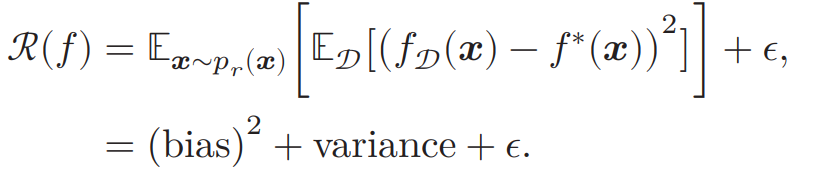
其中,
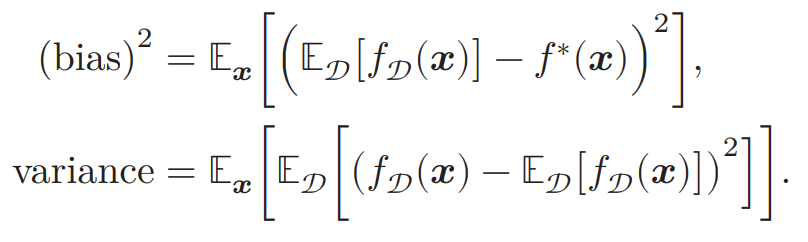
因此,最小化期望错误等价于最小化偏差(的平方)和方差之和。
用一个等式来描述,就是:全局期望误差 = 平均偏差平方 + 平均方差 + 不可约噪声。
4. 总结
下图展示了机器学习模型的四种偏差和方差组合情况:
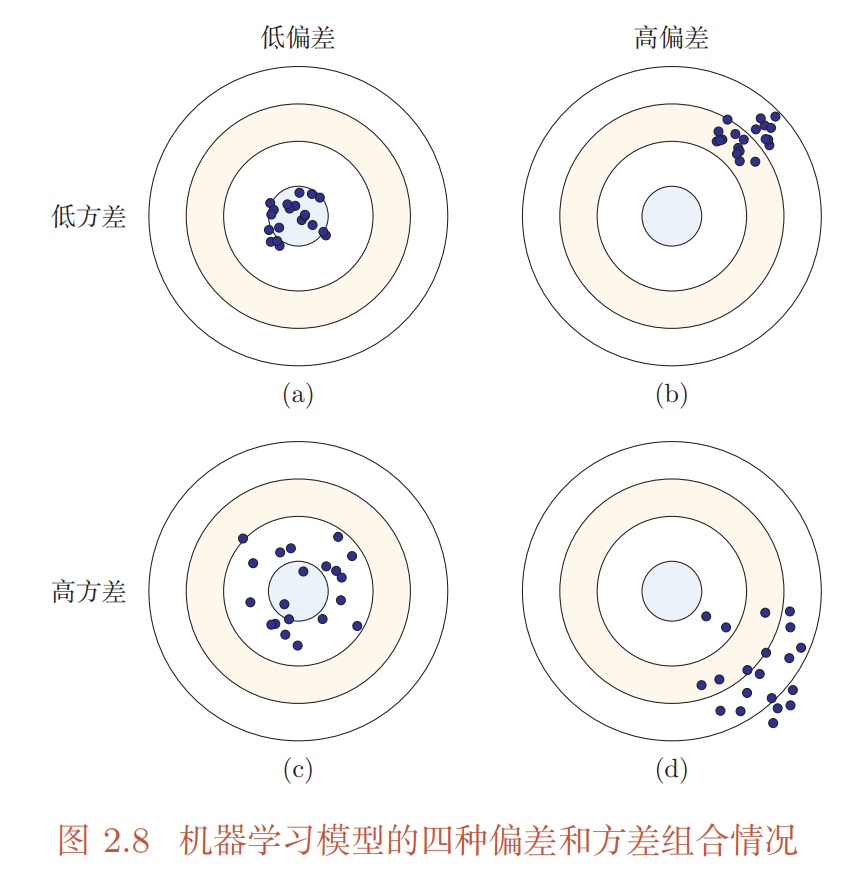
偏差低的模型拟合能力强;方差低的模型泛化能力强。
方差一般会随着训练样本的增加而减少。当样本比较多时,方差比较少,这时可以选择能力强的模型来减少偏差。然而在很多机器学习任务上,训练集往往都比较有限,最优的偏差和最优的方差就无法兼顾。
此外,随着模型复杂度的增加,模型的拟合能力变强,偏差减少而方差增大,从而可能导致过拟合。这个时候需要调整正则化系数 𝜆 来控制模型的复杂度。当 𝜆 变大时,模型复杂度会降低,可以有效地减少方差,避免过拟合,但此时偏差会上升。当 𝜆 过大时,总的期望错误反而会上升。因此,一个好的正则化系数 𝜆 需要在偏差和方差之间取得比较好的平衡。
下图就展示了这样一种权衡:
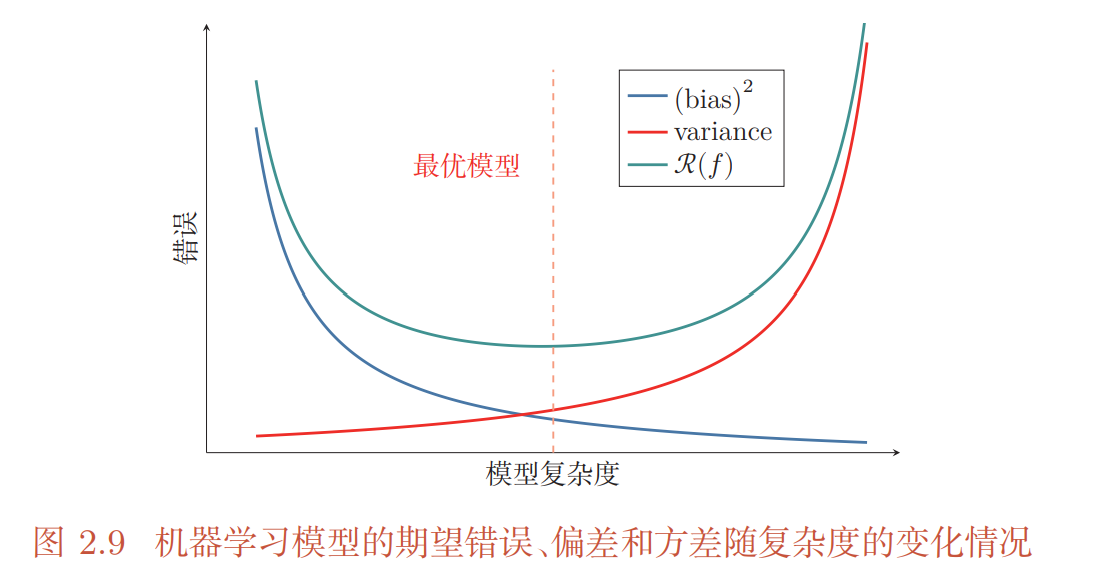
偏差和方差分解给机器学习模型提供了一种分析途径,但在实际操作中难以直接衡量。一般来说,当一个模型在训练集上的错误率比较高时,说明模型的拟合能力不够,偏差比较高。这种情况可以通过增加数据特征、提高模型复杂度、 减小正则化系数等操作来改进。当模型在训练集上的错误率比较低,但验证集上的错误率比较高时,说明模型过拟合,方差比较高。这种情况可以通过降低模型复杂度、加大正则化系数、引入先验等方法来缓解。此外,还有一种有效降低方差的方法为集成模型,即通过多个高方差模型的平均来降低方差。
5. 我的思考
对第 2 节中最优模型的推导
根据全期望公式,联合分布上的期望可以分解为对边缘分布 𝑝𝑟(𝒙) 和条件分布 𝑝𝑟(𝑦|𝒙) 的两层期望:
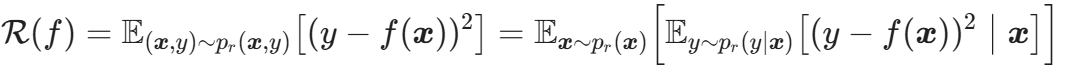
记条件期望简记为:
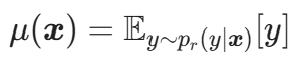
对于给定的输入 𝒙 ,将内层平方项通过“加一项减一项”展开配方:
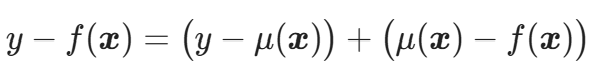
对上式两边平方:
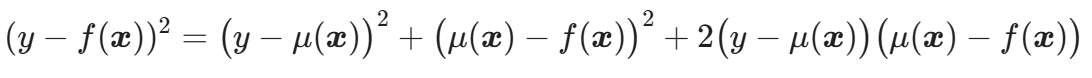
计算内层关于条件分布 𝑝𝑟(𝑦|𝒙) 的期望:
第一项:
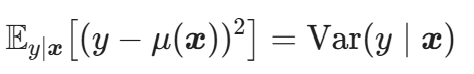
显然,这是给定 𝒙 时标签 y 的条件方差。
第二项:
给定 𝒙 时,这一项是与 y 无关的常数,因此期望就等于其自身:
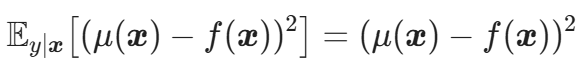
第三项(交叉乘积项):
提取出与 y 无关的确定项:
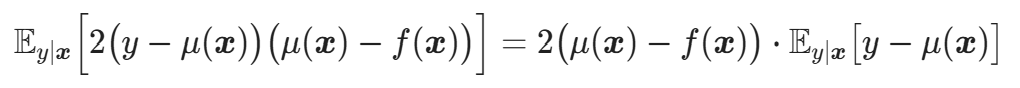
根据条件期望的线性性质:
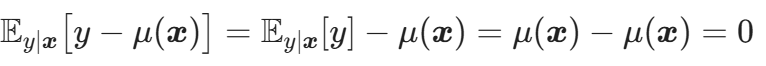
因此,交叉项严格恒等于 0 。
最后,将三项相加并代回外层的全期望中,得到:
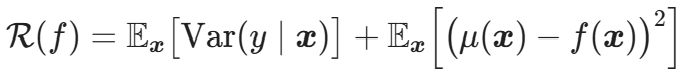
我们的目标是找到最优的 𝑓 ,使得上述期望错误最小。注意到第一项与 𝑓 无关;第二项中的 μ 也与 𝑓 无关。
因此,要使期望错误 ℛ(𝑓) 达到最小值,当且仅当第二项为 0,即: