

今天来做第二章的习题。

我的思考:
训练集的作用是进行参数学习;验证集的作用是选择合适的模型以及超参数组合;测试集的作用是完成模型的最终评估,衡量其在未见样本上的表现。
测试集不参与模型选择和超参数调节的原因是:避免数据泄露,防止模型提前学习到测试集中的一些信息(如数据分布特征等),造成测试结果过于乐观。
需要注意的是:
并不是所有机器学习模型都是基于参数的,例如朴素贝叶斯、决策树、KNN 等。因此,对训练集作用更准确的描述应该是 “在给定的假设空间 ℱ 下,通过参数数值优化、经验概率统计或拓扑规则归纳,将未定型的模型结构实例化为一个具体的预测映射函数 𝑓 ∈ ℱ ”
超参数选择与模型挑选本质上也是一个优化过程。若使用测试集评估并据此挑选超参数,人类或搜索算法就充当了外层优化器,导致测试集的信息隐式泄露至调参循环中,使模型在超参数层面对测试集的特有样本噪声产生过拟合(即测试集退化为验证集)。这会导致最终评估结果过于乐观,无法真实反映模型在未来完全未知数据上的泛化能力。

我的思考:
这有可能是模型复杂度过高,在训练集上过拟合导致的。改进方法如下所述:
在训练时用结构风险最小化目标替代经验风险最小化。添加正则化惩罚项限制模型复杂度。
在验证集验证过程中添加早停机制,识别过拟合模式并及时停止训练过程。
增大训练集样本数(或基于数据增强手段人为制造扰动)。
采用推理期 ensemble 的方式来降低模型方差,增强泛化能力。
补充:事实上题面所述情形还存在一种原因,即训练集与验证集的数据分布本身不满足独立同分布假设。例如,在一个图像分类任务中,训练集 90% 是猫的图像,而验证集 90% 是狗的图像。对于这种情况,可以对训练集和验证集做探索性数据分析(EDA),充分挖掘数据分布情形,并针对性制定措施。(例如,对于上述的类别不均衡情形,可以重新分层抽样或采用 Focal loss 来加大模型对长尾类别的关注度)

我的思考:我在 Day 2 中详细讨论过这个问题。核心思想就是:平方损失函数要求真值标签与模型预测需要处在一个连续的度量空间之中,然而分类问题并不直接满足这个前提。我们不能说第 1 类与第 3 类之间的距离比第 1 类与第 2 类之间的距离更长,也不能说第 3 类减去第 1 类等于第 2 类。

我的思考(下面默认只在句子的开端和结尾处至多添加一个 $ 和 # 作为文本的开始符与结束符,且基于单字粒度来做分词):
一元模型
词表 V 包含:我、帮、了、张、三,共 5 个 token ,于是“我帮了张三”表示为 [1, 1, 1, 1, 1] ;“张三帮了我” 表示为 [1 ,1, 1, 1, 1]
二元模型
词表 V 包含:$我、我帮、帮了、了张、张三、三#、$张、三帮、了我、我#, 共 10 个 token ,于是“我帮了张三”表示为 [1, 1, 1, 1, 1, 1, 0, 0, 0, 0] ,“张三帮了我”表示为 [0, 0, 1, 0, 1, 0, 1, 1, 1, 1]
三元模型
词表 V 包含:$我帮、我帮了、帮了张、了张三、张三#、$张三、张三帮、三帮了、帮了我、了我# 共 10 个 token ,于是“我帮了张三”表示为 [1, 1, 1, 1, 1, 0, 0, 0, 0, 0] ,“张三帮了我”表示为 [0, 0, 0, 0, 0, 1, 1, 1, 1, 1]
不难发现,当模型考虑的连续词序关系较短时,优点是特征维数比较低,计算开销与存储开销小,模型简单,缺点是特征区分度也比较差,且不能建模较长程的词序关系;当模型考虑的连续词序关系较长时,优点是特征区分度比较高,缺点是特征维度也高,可能增大计算开销与存储开销,并引发维度灾难。
补充:我们还可以发现,无论 n-gram 词袋模型的 n 是较大还是较小,都存在一个问题,即无法很好地衡量两个自然语言句子的语义相似度。当 n 比较低时,文本退化为了“无序的字词集合”,不含有语义信息的理解(例如上面的例子中,一元模型对两个句子不存在任何区分能力);当 n 比较高时,虽然考虑了词序关系,但是很容易受到表达方式不同的影响,进而导致特征表示非常稀疏且近似正交,也无法正确表示语义信息。(例如,上述例子中,虽然“我帮了张三”和“张三帮了我”在语义主题上是很相关的,但在三元模型编码之后,特征表示向量的余弦相似度是 0 )

我的思考:
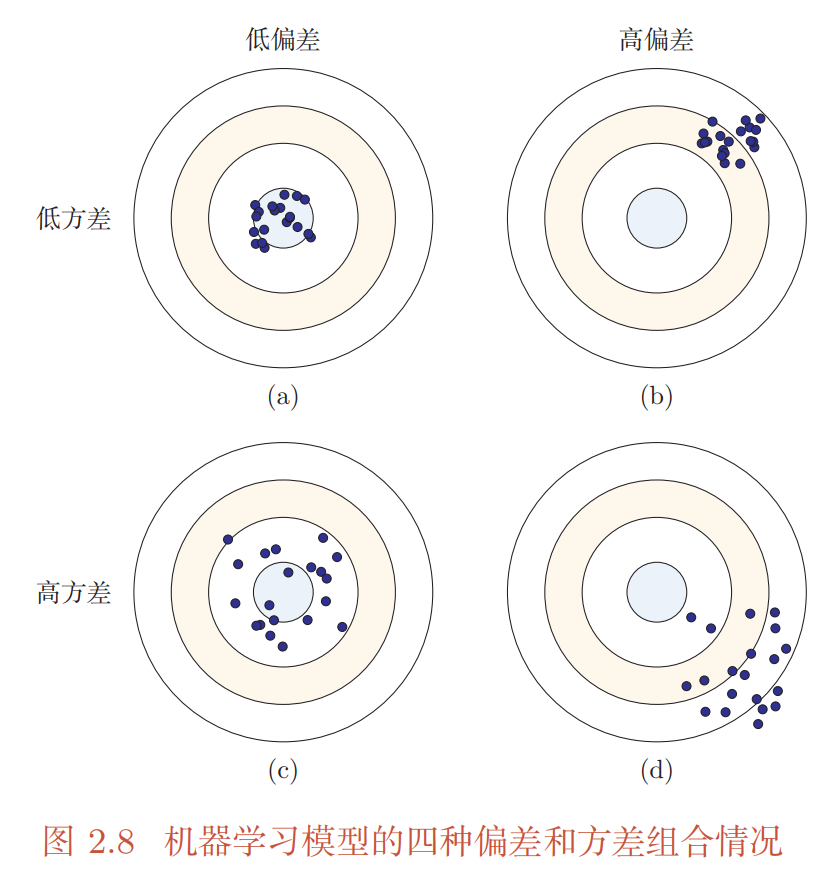
模型复杂度比较高,且训练不充分或由于超参设置不合理导致训练发散时,可能高偏差 + 高方差。
数据集样本数小或存在较多噪声时,训练出的模型可能高偏差 + 高方差。
如果原始特征数量很多,且冗余度高、噪声多,在不做表示学习前提下直接参与机器学习模型的训练,也会导致这种情况。
归纳偏置不适配。例如使用高度自由的高次多项式去拟合一个具有周期性跳变的方波信号。
我的思考:
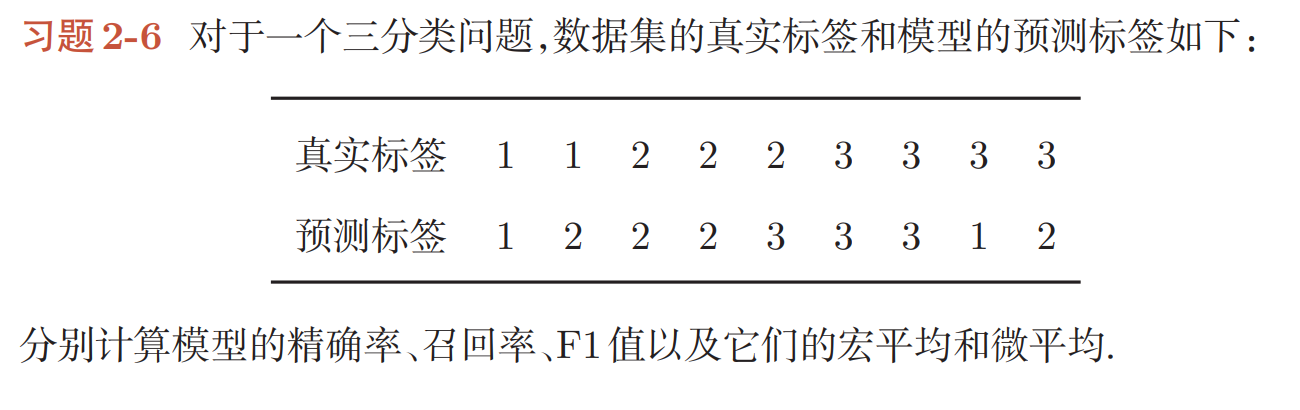
下面用 c 来表示目标类别。
精确率
Pre(c = 1) = 1 / 2 = 0.5 ; Pre(c = 2) = 2 / 4 = 0.5 ; Pre(c = 3) = 2 / 3
召回率
Rec(c = 1) = 1 / 2 = 0.5 ' Rec(c = 2) = 2 / 3 ; Rec(c = 3) = 2 / 4 = 0.5
F1值
F1(c = 1) = 0.5 ; F1(c = 2) = 4 / 7 ; F1(c = 3) = 4 / 7
宏平均
Macro-Precision(c) = (0.5 + 0.5 + 2 / 3) / 3 = 5 / 9
Macro-Recall(c) =5 / 9
Macro-F1 有两种理解方式:
F1的算数平均:(0.5 + 4 / 7 + 4 / 7) / 3 = 23 / 42
宏 Precision 与宏 Recall 的调和平均:2 / (9 / 5 + 9 / 5) = 5 / 9
微平均
Micro-Precision(c) = 5 / 9 ; Micro-Recall(c) = 5 / 9 ; Micro-F1(c) = 5 / 9
注:Day 3 中证明了,对于单标签多分类任务,精确率、召回率和 F1 值的微平均相同且均等于准确率。
我的思考:
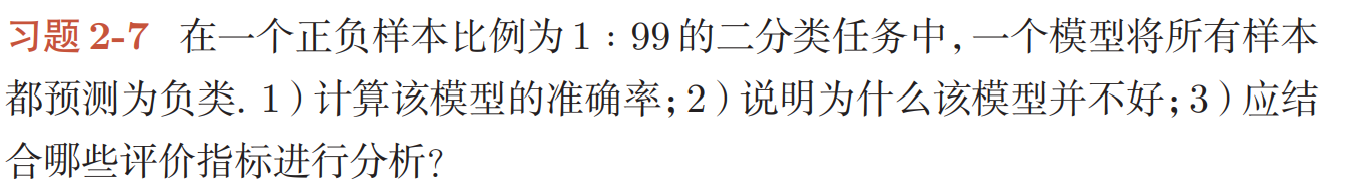
ACC = (TP + TN) / (TP + FP + TN + FN) = (0 + 99) / 100 = 99%
显然模型完全处于欠拟合状态,没有学习到足够有用的分类函数。对于未来未见的样本,模型将会对其中的的正类样本完全丧失正确分类的能力。
这是非常典型的类别不均衡情形。应当基于 Precision、Recall、F1-score 等指标来分析。
我的思考:
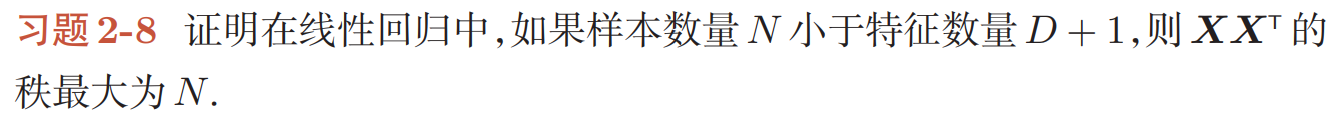
在线性回归中,设增广特征矩阵 X 的维度为 (D + 1) * N(其中 D 为特征维度,+1 为偏置项维度,N 为样本数量)。
两个矩阵相乘,其结果矩阵的秩不会超过其中任意一个矩阵的秩,即:
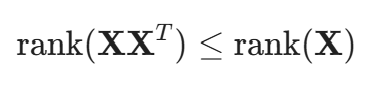
任意矩阵的秩不可能超过其行数与列数的较小值,因此:
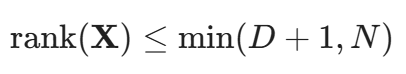
根据题面信息,
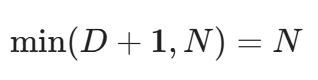
于是得到结论。
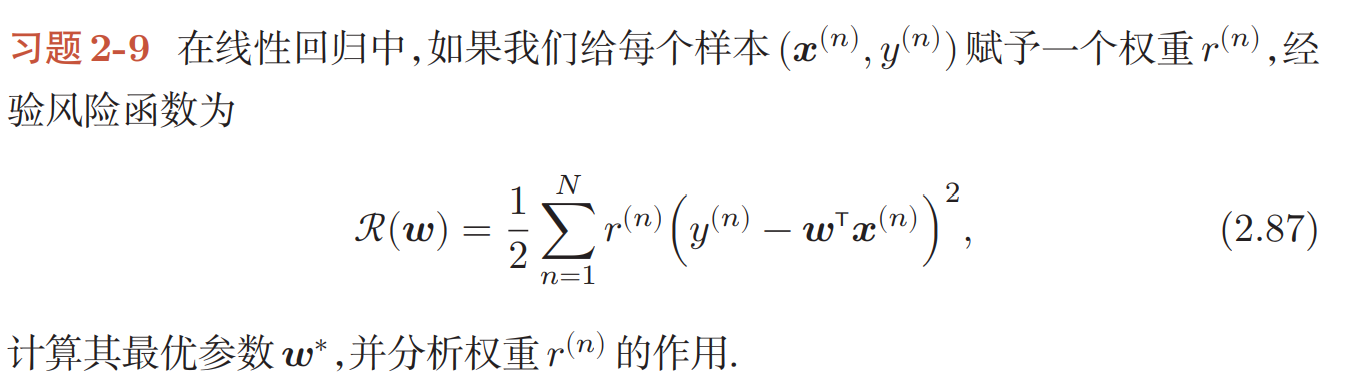
我的思考:
对 w 求梯度:
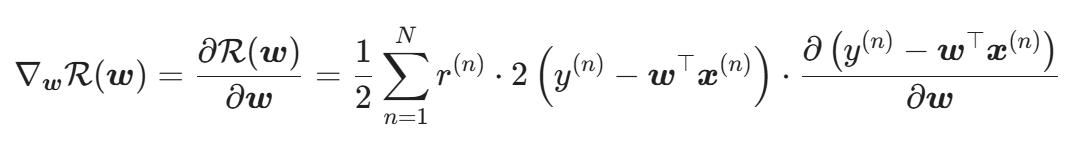
化简后:
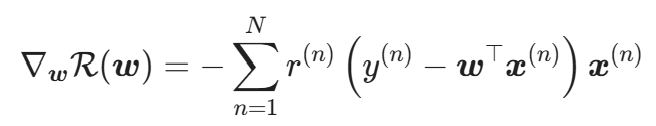
令梯度为 0 ,得:
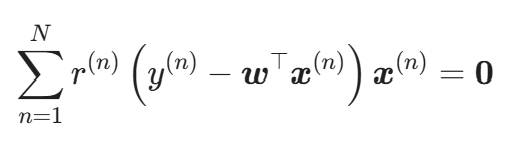
即:
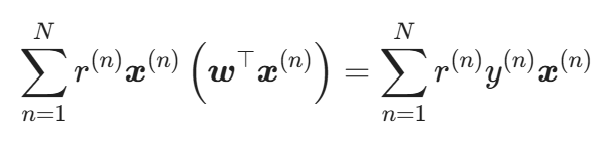
可以将参数 w 作为公共项提出到求和号右侧:
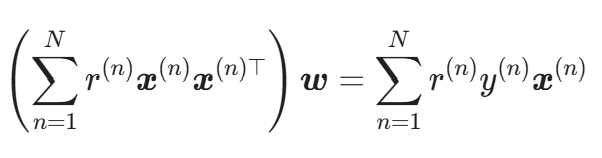
假设左边的加权协方差矩阵可逆,那么就有 w 的闭式解:
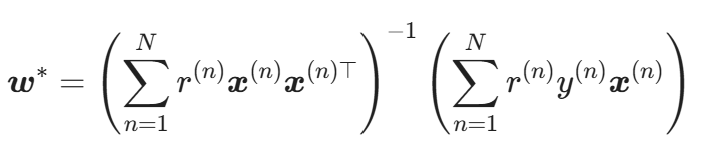
权重 𝑟(𝑛) 本质上控制了训练集中每一个样本点的预测偏差对损失函数的“重要性程度”。
权重 𝑟(𝑛) 在实际场景中有许多应用。例如,考虑一个具有类别长尾分布效应的训练集。我们可以通过提高稀缺类别样本的权重 𝑟(𝑛) ,来平衡常见类别样本与稀有类别样本对损失函数的贡献。