

在 Day 5 中,我们一起学习了偏差-方差分解的思想。今天来学习机器学习算法的类型与数据的特征表示。
1. 机器学习算法的类型
我们可以依据训练样本中提供的信息以及学习过程中的反馈形式来区分不同范式。
监督学习
监督学习指的是如下这种机器学习范式:
目标是建模样本特征 𝒙 和标签 𝑦 之间的关系(包括函数关系与条件概率关系)
训练集中每个样本都带有标签。
根据标签类型的不同,监督学习又可以分为回归问题、分类问题和结构化学习问题:
回归:标签 𝑦 是连续值,模型输出也是连续值。
分类:标签 𝑦 是离散类别。分类问题根据类别数量又可分为二分类和多分类问题。
结构化学习:输出通常是序列、树或图等结构化对象。由于输出空间通常很大,一般定义联合特征 𝜙(𝒙, 𝒚) ,并通过
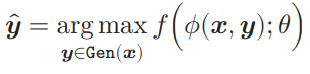
来预测输出,其中 Gen(𝒙) 表示输入 𝒙 的所有候选输出集合。计算 argmax 的过程也称为解码。
无监督学习
无监督学习是指从不包含目标标签的训练样本中自动学习有价值的信息。典型任务包括聚类、密度估计、降维以及表示学习等。与监督学习相比,无监督学习更强调发现数据内部结构,而不是直接预测给定标签。
强化学习
强化学习是一类通过交互来学习的机器学习方法。在强化学习中,智能体根据环境状态采取动作,并从环境中获得即时或延时的奖励;学习目标是通过不断试错,找到能够最大化期望总回报的策略。
半监督学习
在很多实际问题中,含有标注的数据较少。此时可以采用半监督学习,即同时利用少量标注样本和大量无标注样本进行学习。半监督学习位于监督学习与无监督学习之间,核心目标是在降低标注成本的同时提升模型性能。
自监督学习
自监督学习通过数据自身构造监督信号,而不依赖人工标注。例如,在自然语言处理中,可以通过“预测被遮蔽的词元”或“预测下一个词元”来学习文本表示;在视觉任务中,也可以通过图像重建、对比学习等方式学习通用表示。自监督学习已成为大规模预训练的重要范式。
迁移学习
迁移学习强调将一个任务或领域中学习到的知识迁移到另一个相关任务中。现代机器学习中常见的 “预训练 — 微调” 流程就属于迁移学习:先在大规模数据上预训练学习通用表示,再在具体下游任务上做微调适配。很多实际系统都会同时结合监督学习、自监督学习和迁移学习。
2. 数据的特征表示
在实际场景中,不同类型的数据,其原始特征空间是不同的。例如,一个长度为 𝐿 的自然语言句子,其离散符号空间可以表示为 𝒱𝐿 ,其中 𝒱 为词表集合;再比如,一张灰度图像(像素数量为 𝐷 )的原始空间可以表示为 [0, 255]𝐷 。
然而,许多机器学习算法希望输入是可计算的数值表示。因此在学习之前通常需要把这些不同类型的数据转换为向量、矩阵或张量形式。例如:
图像特征:可以将大小为 𝑀 × 𝑁 的图像直接展开为 𝑀𝑁 维向量,每一维对应一个像素值。当然,为了提升模型效果,也可以人工加入直方图、宽高比、纹理、边缘以及局部描述子等特征。假设最终抽取了 𝐷 个特征,则一个图像样本可以表示为特征向量 𝒙 ∈ ℝ𝐷 。
文本特征:考虑将自然语言文本 𝑥 转换为向量形式。一种最简单的方法是使用词袋(Bag-of-Words,BoW)模型。假设训练集合中的词都来自一个词表 𝒱,大小为 |𝒱| ,则每个样本可以表示为一个 |𝒱| 维向量 𝒙 ∈ ℝ|𝒱| 。向量 𝒙 中第 𝑖 维的值表示词表中的第 𝑖 个词是否在 𝑥 中出现。
不难发现,词袋模型是一元特征模型(即:将文本看作词的集合,不考虑词序信息)。在处理文本特征时,我们可以采取更高级的方式,如采取 N 元特征,每 𝑁 个连续词构成一个基本单元。随着 𝑁 的增长,N 元特征的数量会快速上升。因此,传统文本表示往往具有高维、稀疏和难以表达相似性的特点。
此外还需要注意的是,上述介绍的词袋模型只衡量 Token “是否出现” ,而不考虑其数值频率,因此通常被称为二值词袋。我们可以更进一步地引入 Token 的词频信息来为词袋表示添加更多信息,例如 TF-IDF 。
直接使用原始特征来进行预测,对机器学习模型的能力要求通常较高。这是因为原始特征往往具备一些缺点:
表达能力有限,需要复杂的非线性组合数据的特征表示才能发挥作用
特征之间冗余较高
并非所有特征都与目标预测相关
特征容易受噪声和表面变化影响
为了提高模型能力,我们希望自动学习出更有效、更稳定的表示,这就是表示学习。
2.1 传统的表示学习
传统的表示学习一般通过人工设计准则来选择或构造特征,可以分为特征选择和特征抽取。
特征选择
特征选择是在原始特征集合中选取一个有效子集,使得基于该子集训练出的模型性能较好。简单地说,特征选择就是保留有用特征,移除冗余或无关特征。。
一种直接的特征选择方法为子集搜索:假设原始特征数为 𝐷,则共有 2𝐷 个候选子集。直接穷举所有候选子集往往代价过高,因此实际中经常采用贪心策略:由空集合开始逐步加入最优特征,称为前向搜索;或者由全体特征开始逐步删除最无用的特征,称为反向搜索。
子集搜索方法又可以分为以下几种:
过滤式方法:不依赖具体机器学习模型,而是根据特征与标签的相关性或信息量进行筛选。
包裹式方法:直接使用后续模型的性能作为评价标准,在特征选择的过程中把模型训练“包裹”在内部。
此外,我们还可以通过 ℓ1 正则化来实现特征选择。由于 ℓ1 正则化倾向于得到稀疏解,因此可以间接实现特征筛选。
注:可以将 ℓ1 正则化理解为一种“嵌入到模型训练过程的特征选择”。模型在最优化学习参数的同时,自动完成了特征筛选。
特征抽取
特征抽取是构造一个新的特征空间,并将原始特征投影到新的特征空间中得到新的表示。以线性投影为例,令 𝒙 ∈ ℝ𝐷 为原始特征向量,𝒙′ ∈ ℝ𝐾 为新空间中的特征向量,则有:
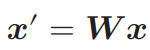
其中 𝑾 ∈ ℝ𝐾×𝐷 为映射矩阵。
特征抽取又可以分为监督和无监督两类:
监督式特征抽取:希望抽取对某个特定预测任务最有用的特征,比如线性判别分析。
无监督式特征抽取:更强调去除冗余、压缩信息和发现潜在结构, 比如主成分分析和自编码器。
下表汇总了监督学习和无监督学习范式下的特征选择与特征抽取代表性方法或思想。
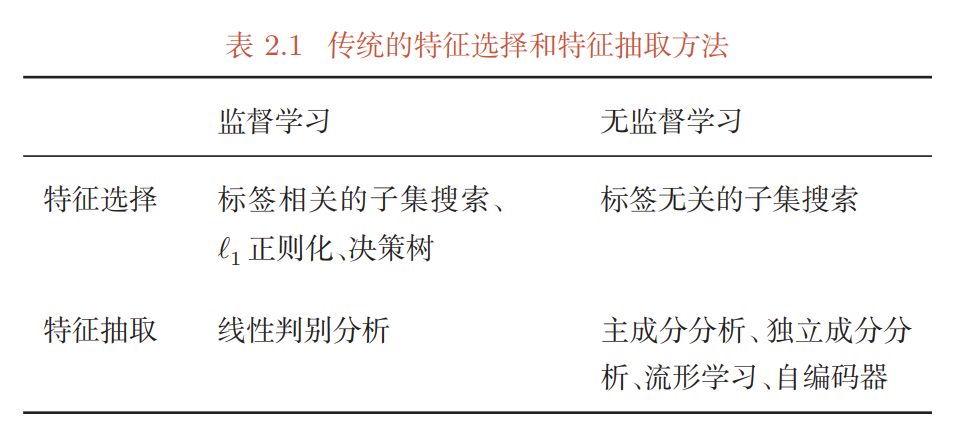
特征选择和特征抽取的优点是可以用较少的特征保留原始特征中的主要相关信息,去掉部分噪声,并提高计算效率、缓解维度灾难。因此,它们也经常被统称为维数约减或降维。
2.2 分布式表示
传统特征工程(如 one-hot 表示、BoW 模型)往往依赖人工设计规则,难以充分表达复杂语义。现代机器学习更常使用分布式表示,即用一个低维、稠密、可学习的向量来表示对象。分布式表示能够更自然地表达“相似对象在表示空间中更接近”这一性质。
利用分布式特征表示的一个最典型的方法是深度学习方法。传统特征抽取一般与预测模型的学习分离:先通过主成分分析或线性判别分析等方法抽取特征,再基于这些特征训练具体模型。深度学习则倾向于将表示学习和预测学习统一到同一个端到端模型中,使得中间表示能够直接服务于最终任务。例如,在一个多层神经网络中,可以认为除了输出层以外的每一层,其输出结果都是一种对输入数据的“表示”。而且,越靠近输入层的表示往往更偏向局部和通用信息,越靠近输出层的表示通常越任务相关。
事实上,现代大规模机器学习系统常采用预训练在海量数据上通过自监督目标学习通用表示,再在具体下游任务上进行微调。这种 “预训练 — 微调” 的流程,本质上就是将表示学习与迁移学习结合起来,从而进一步提升表示能力。
下表展示了机器学习中特征表示方法的演化:
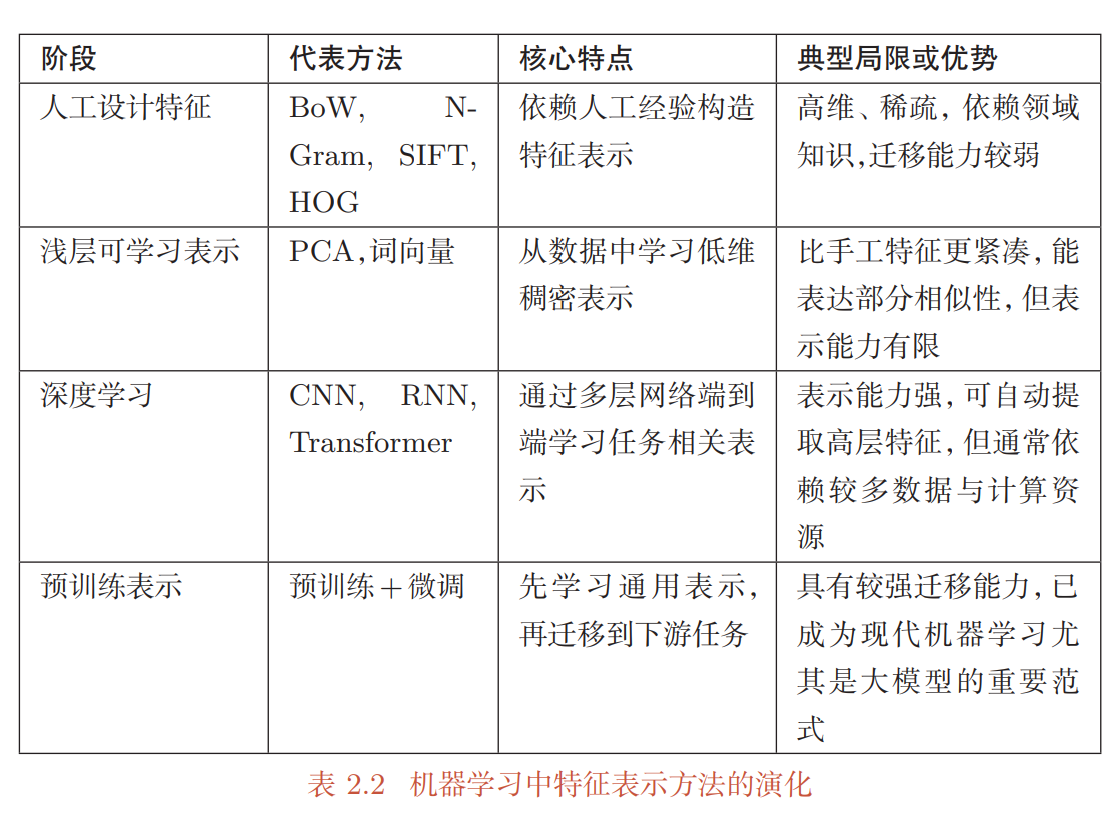
注:上表中展示的方法我都会研读到并撰写笔记分享。