

本系列是学校《模式识别与机器学习》专业课 + 邱锡鹏老师《神经网络与深度学习》一书的学习笔记。
1. 什么是机器学习?
机器学习就是让计算机从观测数据(样本)中进行自动学习,得到某种知识或规律,并将学习到的规律应用于未知或无法观测的数据的预测中。
例如,人们能很轻易地识别出手写体数字图像中的数字到底是什么。但是如果想要编写一套确定性的识别算法来将这种能力赋予计算机,却是几乎不可能实现的。因为我们并不能确切地知道自己“到底是怎么知道的”。此外,我们很难总结出一套规则来确定性地区分不同的手写体数字。
于是人们尝试用“机器学习”的方式来解决这个问题。具体来说,让计算机“看”大量的手写体数字样本,并从中学习到一些经验,然后用这些经验来识别新的样本。这个方式就像是我们教小孩学数字的过程,因此可以被视作一种“让机器自己学习”的方法。
2. 从一个芒果的例子出发
假设我们要到市场上购买芒果,但是之前毫无挑选芒果的经验,那么如何通过学习来获取这些知识?
我们可以随机选取一些芒果,记录每个芒果的特征(或属性),比如颜色、大小、形状、产地和品牌等,并给出我们关心的标签。标签可以是连续值(比如关于芒果甜度、水分和成熟度的综合打分),也可以是离散值 (比如“好”“坏”两类标签)。一个同时包含特征和标签的芒果样本就称为样本或示例。
一个芒果样本的所有特征可以组成一个 D 维的向量,即特征向量:
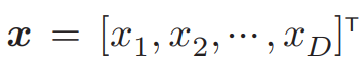
在上面的特征向量里,每一维都表示一个特征。需要注意的是,并不是所有的样本特征都是数值型,需要通过转换表示为特征向量。
此外,芒果的标签通常用标量 𝑦 来表示。
于是我们就得到了一个 N 个样本组成的训练集 D :
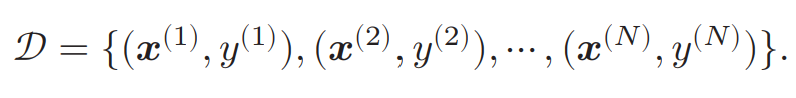
给定训练集 D ,我们希望让计算机从如下函数集合
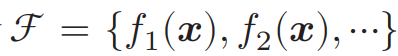
中自动寻找一个“最优”的函数 𝑓*(𝒙) ,来近似特征向量 𝒙 和标签 𝑦 之间的真实关系。对于一个样本 𝒙 ,我们可以通过函数 𝑓*(𝒙) 来预测其标签值:
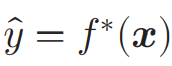
或者预测从 𝒙 到 𝑦 的条件概率:
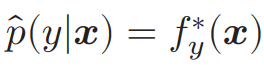
从函数集合 ℱ 中找到合适的函数 𝑓*(𝒙) 一般需要通过学习算法(或学习器) 𝒜 来完成。学习算法利用训练数据不断调整模型参数,使模型不仅在训练样本上表现良好,而且在新样本上也具有较好的泛化能力。
当模型训练完成后,我们再用独立的测试集 𝒟′ 来评估模型性能。比如对于分类问题,可以在测试集上计算预测准确率:
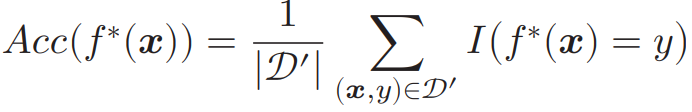
可以用下图来展示机器学习的基本流程:
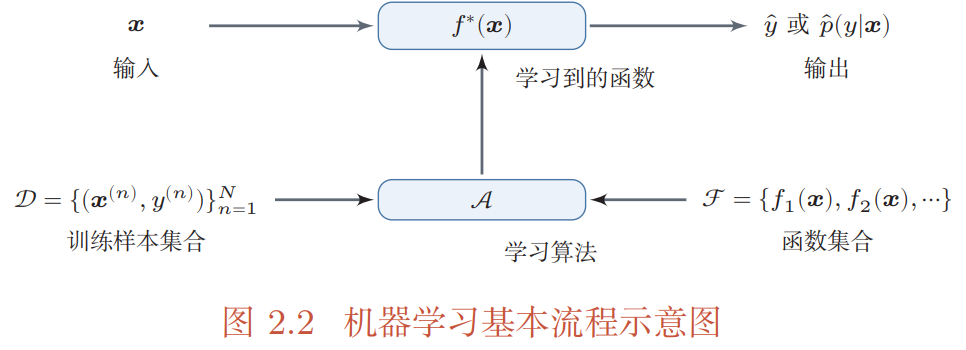
对于一个机器学习模型,输入为 𝒙 ,输出为 𝑦 。 按照经验,我们假设了一个函数集合 ℱ 。根据学习算法与训练样本集合,模型学习到了一个函数 𝑓*(𝒙) 。此后,模型可以利用 𝑓*(𝒙) 来对新的输入进行预测。这样,我们就能较为可靠地学会如何挑选芒果了。
注:如果还需要进行模型选择或超参数调整,则通常再引入一个验证集。
3. 机器学习的几个基本要素
根据上面挑选芒果的例子,可以从以下几个方面描述机器学习过程。
数据集
数据集是一组样本构成的集合,也称为语料库。一般划分为训练集、验证集、测试集:
训练集:用于学习模型参数。
验证集:用于模型选择、超参数调整以及提前停止。
测试集:仅用于最终评估模型的泛化性能,不参与模型设计过程。
注意,若测试集被反复用于调参,就会造成数据泄露(Data Leakage),从而使测试结果过于乐观。
在经典监督学习中,通常假设这些样本是独立同分布的(IID),即独立地从相同的数据分布中抽取的。不过,对于时间序列、领域迁移以及分布漂移等真实场景任务未必成立 IID 假设,因此往往需要额外处理。
模型
对于一个机器学习任务,首先要确定其输入空间(样本的特征空间) 𝒳 和输出空间 𝒴 。不同的机器学习任务主要是 𝒴 不同。在二分类问题中 𝒴 = {+1, −1},在 𝐶 分类问题(即有 C 个分类类别的分类问题)中 𝒴 = {1, 2, ⋯ , 𝐶},而在回归问题中 𝒴 = ℝ 。
考虑样本空间中的一个样本 (𝒙, 𝑦) ,假定输入特征与标签之间存在某个未知的真实映射函数 𝑦 = 𝑔(𝒙) 或真实条件概率分布 𝑝𝑟 (𝑦|𝒙) 。机器学习的目标是找到一个模型来近似它。
但由于我们事先并不知道真实映射函数或真实条件概率分布的形式,因此只能根据经验来假设一个函数集合 ℱ,称为假设空间。然后通过观测其在训练集 𝒟 上的特性,从中选择一个理想的假设 𝑓* ∈ ℱ 。
假设空间 ℱ 通常为一个参数化的函数族:
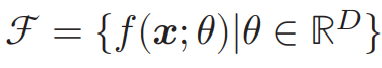
其中 𝑓(𝒙; 𝜃) 是参数为 𝜃 的函数,也称为模型,𝐷 为参数的数量。
假设空间可以分为线性和非线性,对应的模型 𝑓 也分别称为线性模型和非线性模型。
线性模型
线性模型的假设空间为一个参数化的线性函数族:
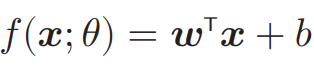
其中参数 𝜃 包含了权重向量 𝒘 和偏置 𝑏 。
非线性模型
广义的非线性模型可以写为多个非线性基函数 𝜙(𝒙) 的线性组合:
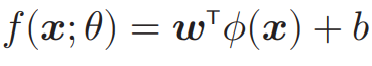
其中 𝜙(𝒙) 是 𝐾 个非线性基函数组成的向量:
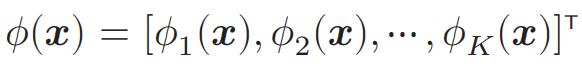
同样地,参数 𝜃 包含了权重向量 𝒘 和偏置 𝑏 。
这里需要注意,如果 𝜙(𝒙) 本身为可学习的基函数,比如
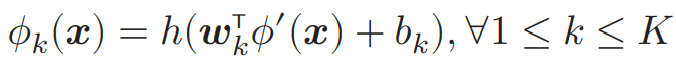
其中 ℎ(⋅) 为非线性函数,𝜙′(𝒙) 为另一组基函数,𝒘𝑘 和 𝑏𝑘 为可学习的参数,则 𝑓(𝒙;𝜃) 就等价于神经网络模型。
我对这一段的理解:把 𝜙′(𝒙) 视为前一层神经网络的输出,通过参数为 𝒘𝑘 和 𝑏𝑘 的线性变换,得到本层第 k 个神经单元的净输入。通过激活函数 ℎ(⋅) ,最终得到的 𝜙𝑘(𝒙) 就是该神经单元的输出。此外,𝒘𝑘 和 𝑏𝑘 的可学习性很重要,因为神经网络的训练过程就是在学习这些参数。换言之,一个经过训练的神经网络,其知识都内化在了 𝒘𝑘 和 𝑏𝑘 等参数中。
剩下几个要素:学习准则、优化算法以及评价指标,放到后面几节中继续整理。
4. 我的进一步思考
表示学习
“非线性模型”部分中指出,基函数可学习即等价于神经网络。这正是经典统计学习与深度学习的区别所在:
经典非线性模型(如 SVM 核方法、多项式回归、RBF 网络):基函数是人为手工设计或预先选定的。此时优化目标只针对最外层的线性权重 w ,数学性质通常很好(通常是凸优化问题,有全局最优解),但受限于人工特征工程的瓶颈,选取出的特征未必对最终的预测任务足够有效。
深度神经网络:通过复合多层 ℎ(W𝒙 + 𝑏),让基函数本身也由可学习参数表示。这就意味着,整个神经网络模型是端到端可学习的。这虽然打破了凸优化的优良性质(变成了非凸优化、存在局部极小值与鞍点),但赋予了模型自动从原始信号中逐层抽取抽象特征的强大能力。
归纳偏置
我们是根据自己的经验来假设函数空间 ℱ 的。而现实中可能与训练集拟合的函数有无穷多个,学习算法必须依靠某种偏好或先验假设来挑选函数,这种对假设空间的约束或偏好就是归纳偏置。例如:
线性模型偏置为“特征与目标满足线性关系”;
深度学习中的 CNN 引入了“局部连接”和“权值共享”(偏置为图像具有空间局部性与平移不变性);RNN 引入了“时间序列的马尔可夫性/平移不变性”。