

今天研读《Think-on-Graph: Deep and Responsible Reasoning of Large Language Model on Knowledge Graph》
开源实现:ToG
1. 为什么要引入 ToG ?
单纯的预训练 LLM 在知识推理任务中存在以下几个问题:
LLM 对于一些预训练数据集中并没有包含的知识或者需要长逻辑链或者多跳推理的问题无法做出良好的回答。
LLM 的回答缺乏可靠性、可解释性与透明性,因此可能产生一些不好的回答,比如幻觉或有害文本。
LLM 的训练阶段既耗时又耗钱,因此仅依靠预训练技术来让 LLM 持续拥有最新知识将是非常困难的。
为了解决这种问题,一个自然的想法诞生了:给 LLM 接入外部知识库,比如知识图谱(KG)。知识图谱提供清晰且结构化的知识表示,能有效弥补 LLM 的上述缺陷。传统研究基于 LLM ⊕ KG 的耦合范式:
在这种范式下,系统首先在 KG 上做检索,然后用检索到的信息填充入 prompt ,最后用信息增强过的 prompt 输入 LLM 给出 response 。可以认为 LLM 在这种范式下起到了两个作用。其一是作为用户 Query 的翻译官,将 Query 翻译为机器可理解可执行的 KG 查询语句;其二是作为生成器,接收信息增强 prompt 并给出 response 。
但我们容易看到,上述范式下,LLM 并没介入 KG 部分的信息检索。因此这种松耦合的范式非常依赖 KG 本身的质量。KG 本身的低质量会导致 LLM 生成的结果也低质量(比如信息不完全,模棱两可甚至产生幻觉)。
因此,作者提出了 LLM ⊗ KG 的耦合范式。这是一种紧耦合的范式,LLM 和 KG 会在图谱推理的每一步都进行紧密的协作,用图谱检索到的可靠知识约束 LLM,同时用 LLM 的常识/推理能力弥补图谱的不完备性。作者将该方法命名为 ToG(Think-on-Graph 的缩写),意为 LLM 沿着知识图谱上的推理路径一步一步进行“思考”。ToG 采用束搜索(Beam Search)算法来管理多条探索路径,整体执行流程分为以下几个阶段:
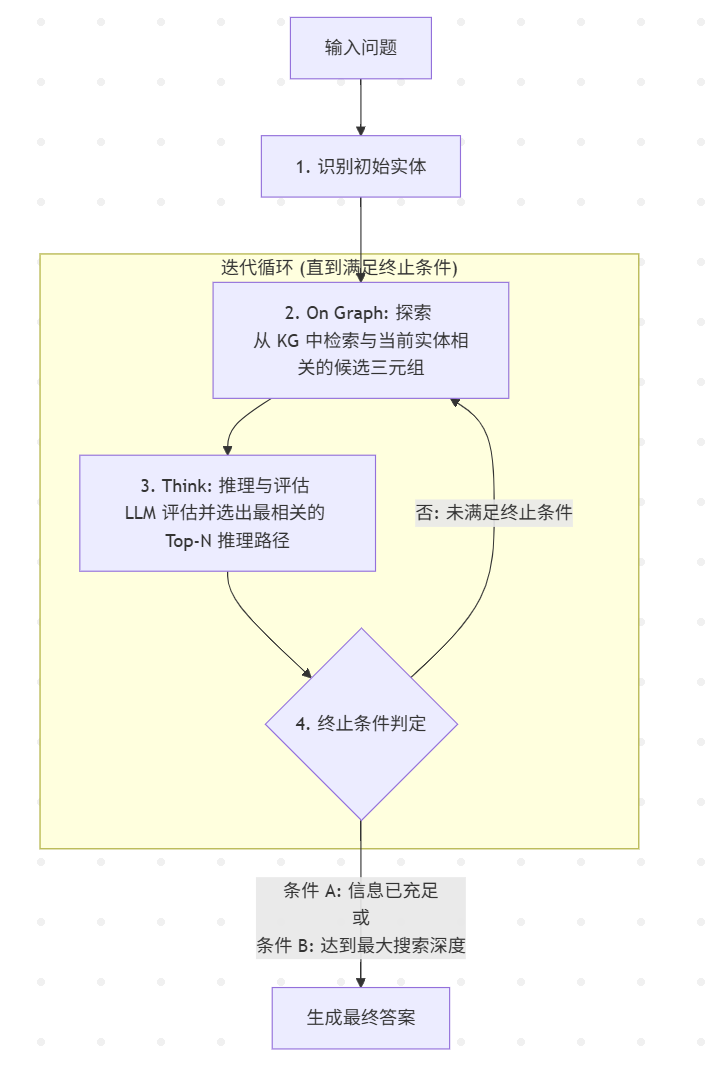
ToG 优势如下所述:
深度推理能力:
多跳路径抽取:ToG 从知识图谱中提取多样化且多跳的推理路径,作为 LLM 进行推理的坚实依据。
攻克知识密集型任务:通过结构化的图谱路径支持,显著增强了 LLM 在复杂、知识密集型任务中的深度推理表现。
可靠推理能力:
提升解释性:形成显式且可编辑的推理路径,使 LLM 的推理全流程具备透明的可解释性。
溯源与纠偏:使得模型输出的来源追溯与事实修正成为可能。
灵活性与高效性:
即插即用:通用框架设计,可以无缝适配不同的 LLM 基座与各种类型的知识图谱。
低成本知识高频更新:知识的更新与扩充直接在 KG 端完成,无需承担重新训练或微调 LLM 的巨大成本与时间开销。
小模型性能跃迁:显著增强较小规模开源 LLM(如 LLaMA2-70B)的推理能力,使其在特定场景下能够与超大模型(如 GPT-4)有相当的竞争力,降低了计算与部署门槛。
2. ToG 建模
ToG 通过 prompting LLM 在知识图谱上执行束搜索:
针对输入问题 x ,系统在每一轮迭代后持续更新并维护一个 Top-N 推理路径集合:P = {p1, p2, . . . , pN} ,其中 N 代表束搜索的束宽。
LLM 会在探索过程中持续评估,直到判定基于当前的推理路径集合已足以回答问题 x 或已达到最大搜索深度。
ToG 分为三个阶段:初始化阶段、探索阶段、推理阶段。
2.1 初始化阶段
在这一阶段,ToG 会针对用户问询来确定 KG 推理路径的初始实体。这可以视作是对于 Top-N 推理路径集合 P 的初始化工作。
具体而言,ToG 系统在这一阶段会首先利用 LLM 对用户的自然语言问询中识别出核心的文本实体,然后将抽取的实体对齐到知识图谱中已有的具体实体节点上(称为主题词实体),并取 Top-N 个主题词实体作为束搜索的起始点集合:
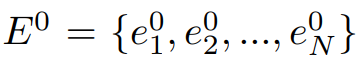
这里需要注意的是,有可能存在一种情况,即 LLM 从用户问询中提取并对齐的主题词实体总数不足 N 个。这种情况下只需将全部的主题词实体作为束搜索起始点即可。
2.2 探索阶段
在第 D 轮迭代开始之前,每一条推理路径 pn 有 D-1 个三元组,也就是说:
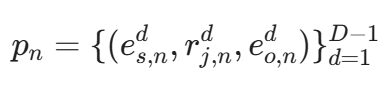
符号描述:
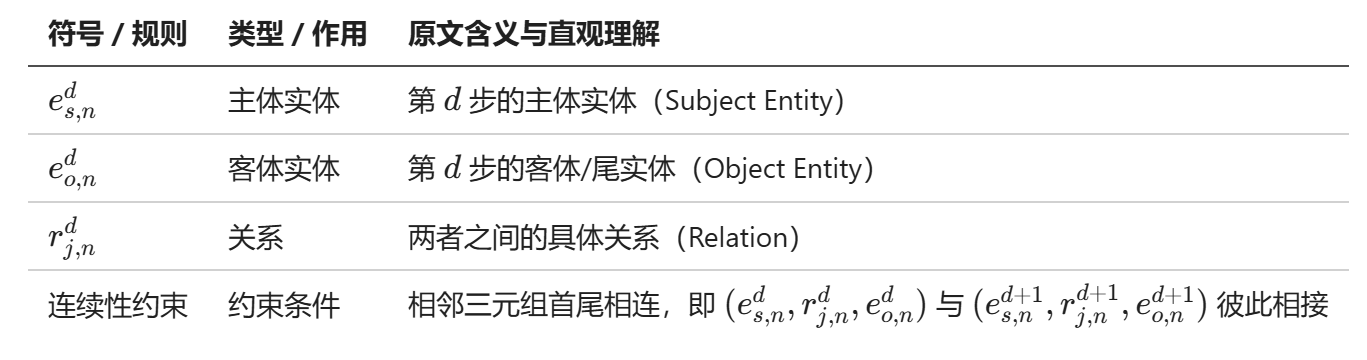
维护两个前沿集合:
尾实体集合:
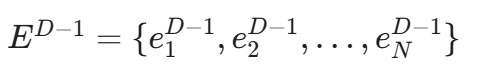
末步关系集合:
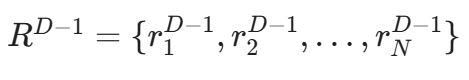
探索阶段的目标就是:
核心目标:利用 LLM 从当前尾实体集合 ED−1 的邻居实体中,结合原始问题 x ,识别出最相关的 Top-N 新实体集合 ED 。
路径更新:将选出的 ED 拼接并扩充到原有的 Top-N 推理路径集合 P 中。
此外,知识图谱中单个实体的相邻实体数量可能极多,如果直接把所有邻居实体全部输入给 LLM,会导致上下文过长、Token 消耗过大以及计算复杂度失控。作者采取两步骤解决策略:
第一步(关系探索):先探索并筛选出与问题显著相关的关系;
第二步(实体探索):利用筛选出的有效关系,反过来定向检索和引导实体的探索与扩展。
关系探索
关系探索是一个从前一轮尾实体集合 ED - 1 向当前轮关系集合 RD 扩展的束搜索过程,其搜索深度为 1,束宽为 N 。LLM 充当 Agent ,通过搜索与剪枝两个子步骤,完成关系探索过程。
搜索(Search):在第 D 轮迭代开始时,针对每条推理路径 pn 的末端实体 enD-1 ,检索出与之直接相连的候选关系集合 Rcand,nD 。然后将所有路径扩展出的候选关系汇总为总候选关系集 RcandD 。需要注意以下两点:
该搜索操作仅需执行两个预定义的简单形式化查询即可完成(包含所有指向该实体或从该实体指出的入向/出向边)。
这种设计使 ToG 能够无缝适配不同的知识图谱,且没有任何训练成本。
剪枝(Prune):获取候选关系集 RcandD 以及扩展出的候选推理路径集 Pcand 之后,需要调用 LLM 进行筛选。具体而言,LLM 结合输入问题 x 的字面语义信息与候选关系 RcandD ,从 Pcand 中挑选出新的 Top-N 推理路径 P ,这些路径均以新的末端关系集合 RD 结尾。
下面的例子直观展示了关系探索过程:
初始状态:首轮迭代中仅有一个主题实体 E0 = {Canberra} 。
搜索阶段:检索出所有与 Canberra 相连的入向和出向关系集合 Rcand1 。
LLM 剪枝:LLM 从中选出 Top-3 关系(假设 N=3 ):{capital of, country, territory} 。
路径状态更新:Top-3 候选推理路径更新为:{(Canberra, capital of), (Canberra, country), (Canberra, territory)}
实体探索
实体探索同样是一个由 LLM 驱动的束搜索过程,用于将搜索前沿从当前轮的关系集合 RD 推进到新的尾实体集合 ED 。这一过程同样包含搜索与剪枝两个子步骤。
搜索(Search):利用关系探索阶段选出的 Top-N 关系路径 P 及其末端关系集 RD 。针对每条关系路径 pn ∈ P ,使用三元组模式发起查询:
正向查询:(enD-1 , rnD, ?)
反向查询:(? , rnD, enD-1)
从而获得对应的候选实体集合 Ecand,nD 。然后,将所有候选集合汇总为总候选实体集:
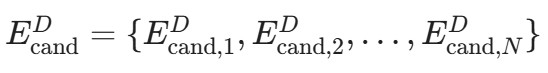
并将推理路径集合 P 扩充为包含这些候选尾实体的 Pcand 。
剪枝(Prune):因为候选集合中的实体均以自然语言形式表达,所以需要利用 LLM 对 Pcand 中的候选路径进行评分与筛选。最终,LLM 选出以新尾实体集合 ED 结尾的 Top-N 推理路径 P 。
下面的例子直观展示了实体探索过程:
延续之前的案例,已有的路径集合 P = {(Canberra, capital of), (Canberra, country), (Canberra, territory)}
进一步,在实体探索阶段,检索得到的候选实体集合表示为 Ecand1 = {Australia, Australia, Australian Capital Territory}
在该案例中,设 capital of、country 和 territory 这三个关系各自仅连接了一个尾实体,Australia 和 Australian Capital Territory 的得分均为 1。
因此,最终第 1 轮迭代完成后的推理路径集合更新为:P = {(Canberra, capital of, Australia), (Canberra, country, Australia), (Canberra, territory, Australian Capital Territory)}
在完成一轮关系探索 + 实体探索之后,系统就构造出了 Top-N 条长度增加 1 的推理路径。每一个剪枝阶段最多需要 N 次 LLM 调用。
2.3 推理阶段
在每一轮探索得到当前推理路径集合 P 后,系统会 prompt LLM 以评估当前路径中的信息是否已足以生成问题的最终答案。
评估结果为“正”:直接调用 LLM,以用户 Query 和当前提取到的 Top-N 推理路径作为输入上下文,生成最终答案并结束流程。
评估结果为“负”:继续进入下一轮的“探索”与“推理”循环。
如果迭代持续进行直到预设的最大搜索深度 Dmax ,评估依然为负,表明 ToG 无法仅凭在图谱上探索到的路径解决该问题。在此场景下,ToG 降级为直接完全依赖 LLM 自身的内在知识来生成答案。
此外,整个推理过程最多包含 D 轮探索阶段、 D 次评估步骤以及 1 次最终生成步骤。
在探索阶段中,每一轮迭代包含:
关系剪枝:针对路径打分调用 LLM;
实体剪枝:针对候选实体打分调用 LLM;
束宽为 N 时,两步剪枝在单轮中最多产生 2 * N 次 LLM 调用。
因此,整个 ToG 流程中 LLM 调用的理论最大上限为:
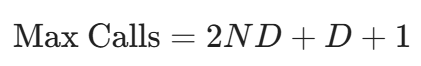
2.4 ToG-R
本节介绍了 ToG 的一个轻量化变体:基于关系链的 Think-on-Graph(ToG-R)。ToG-R 借鉴传统基于语义解析的 KBQA 方法中主要依靠问题中的关系信息来生成查询的思想。目标是从起始实体开始探索 Top-N 关系链:
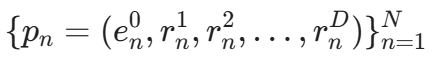
执行流程简述:
前序步骤一致:在每一轮迭代中,ToG-R 同样依次执行关系搜索、关系剪枝与实体搜索。
候选路径推理评估:基于实体搜索得到的全部候选路径(以 EcandD 结尾),由 LLM 判断信息是否已充足。
随机剪枝替代 LLM 实体剪枝:
假设前提:假设同一候选集合 Ecand,nD 中的实体通常属于同一种类别,且拥有相似的邻居关系。
机制:若当前信息不足以回答问题,系统不再调用 LLM 来对实体进行打分筛选,而是直接从候选实体 EcandD 中随机采样 N 个实体作为下一轮的起点。
ToG-R 省去了实体剪枝阶段的 LLM 调用,调用上限降至 ND + D + 1 次,大幅降低了整体 Token 成本和推理响应时间。此外,当图谱中的中间实体信息缺失或属于 LLM 不熟悉的冷门实体时,避免了 LLM 因无法识别中间实体而做出错误的剪枝判断。
3. 实验结果
3.1 实验基础设置
数据集
对比 Baseline
基础 Prompting 基线:
IO Prompting:标准输入输出 Prompting。
CoT Prompting:思维链 Prompting。
Self-Consistency:采用 6 个上下文示例及“分步推理”链条。
两类 SOTA 标杆对比:
基于 Prompting 的 SOTA :在不进行权重训练的前提下进行公平对比。
全局 SOTA :包含专门在目标数据集上微调的方法。
实验超参数与环境配置
3.2 实验结果分析
3.2.1 对比实验
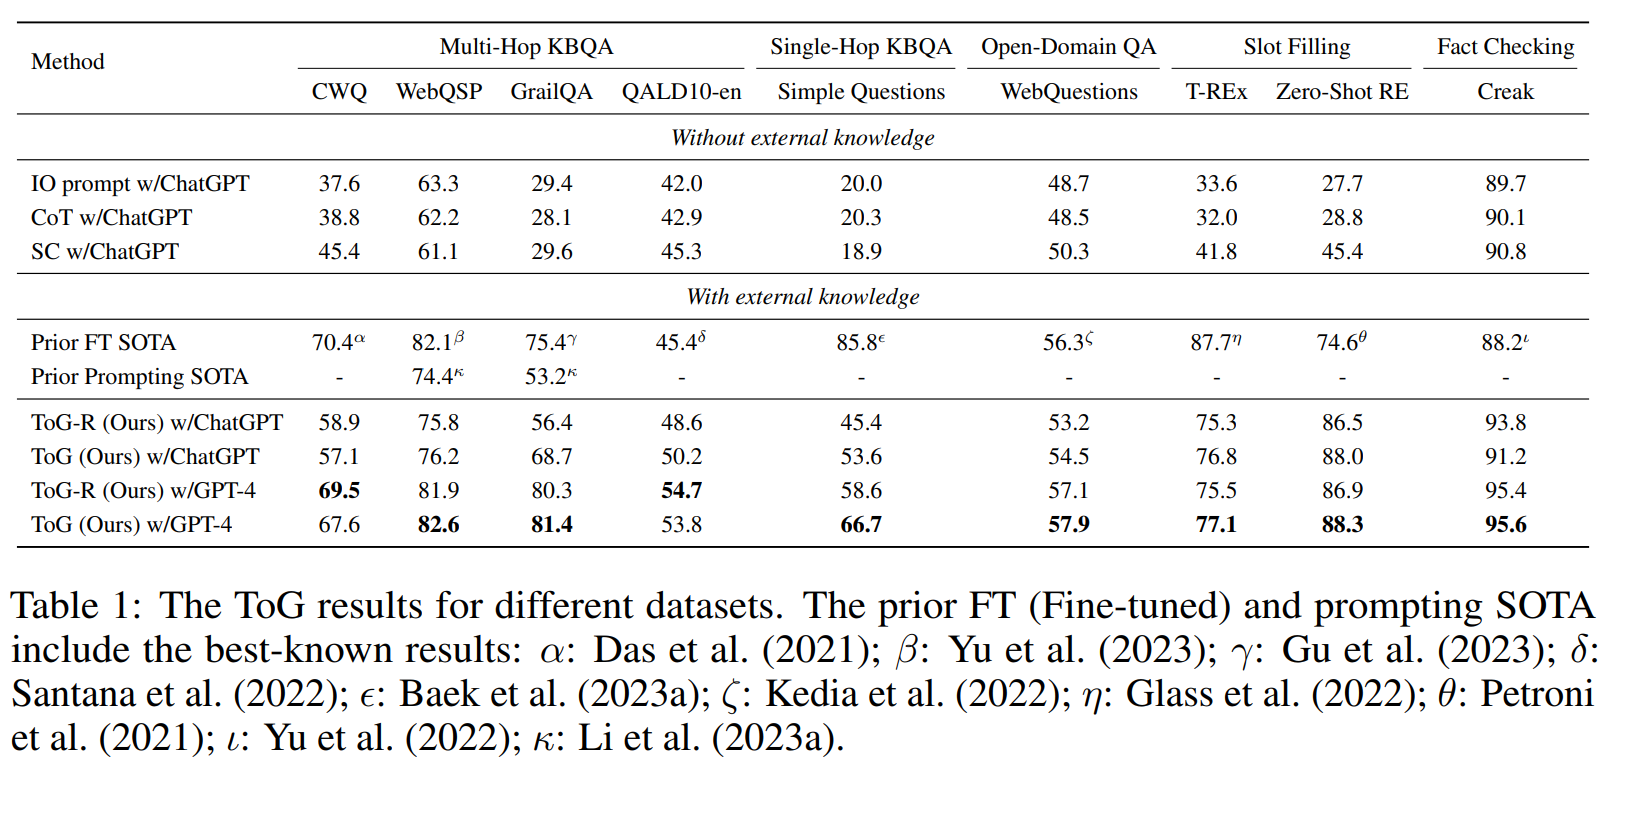
与引入外部知识的基线方法对比
对比全局 SOTA(包含微调方法):
尽管 ToG 是无须训练的 Prompting 方法,先天在指标上相较于在评测集上微调的方法处于劣势,但 ToG (GPT-4) 仍在 9 个数据集中的 6 个上取得了新的全局 SOTA(分别为 WebQSP, GrailQA, QALD10-en, WebQuestions, Zero-Shot RE, Creak)。
在未达 SOTA 的数据集中(如 CWQ),其表现已非常接近此前微调的 SOTA(69.5% 对比 70.4%)。
对比基于 Prompting 的方法:
无论使用 GPT-4 还是相对较弱的 ChatGPT 作为基座,ToG 在全部 9 个数据集上均取得了同类 Prompting 方法的最好成绩。
通用性与多跳推理表现:
在开放域问答数据集 WebQuestions 上取得了 1.6% 的提升,证明了方法在开放域问答任务中的通用性。
ToG 在单跳数据集上的提升不及多跳数据集明显,这表明 ToG 对多跳推理场景更有效,支撑了其增强 LLM 深度推理能力的论点。
与无外部知识的纯 LLM 提示方法对比
相较于纯 LLM 基础方法(如 IO、CoT、Self-Consistency 等不使用外部知识的方法),ToG 展现出更显著的性能优势:
大幅度提升示例:在 GrailQA 上性能提升了 51.8%,在 Zero-Shot RE 上提升了 42.9%。
结论:验证了在深度推理任务中,引入外部知识图谱能带来不可忽视的收益。
标准 ToG 与轻量变体 ToG-R 的对比
表现对比:在多数数据集上,标准 ToG 表现优于 ToG-R。
原因分析:标准 ToG 基于三元组的推理路径保留了中间实体的具体信息,而 ToG-R 仅保留关系链并随机采样实体,因此标准 ToG 能为 LLM 提供更充分且准确的上下文支撑。
3.2.2 LLM 基座的影响
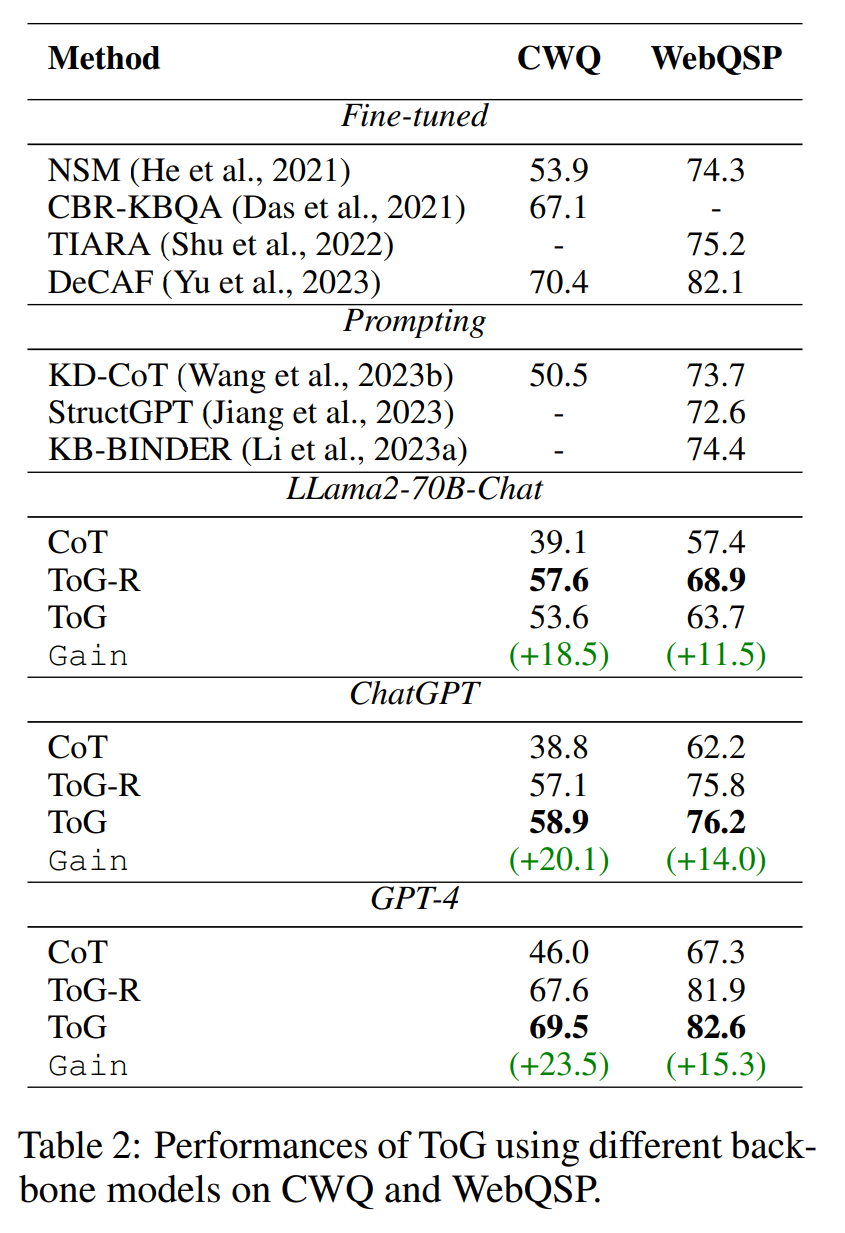
作者在 CWQ 和 WebQSP 两个数据集上切换不同的 LLM 基座(GPT-4、ChatGPT、LLaMA2-70B),验证了 ToG 的即插即用灵活性及基座能力对图谱推理的影响。
基座模型能力与性能正相关
CoT 基准表现:随着基座模型参数规模和推理能力的提升( GPT-4 > ChatGPT > LLaMA-2 ),CoT 的基础表现同步提高。
放大模型收益:基座模型越强,ToG 相较于 CoT 的提升幅度(Gap)越大:
在 CWQ 上:ToG 带来的增益从 LLaMA-2 的 18.5% 扩大到 GPT-4 的 23.5%;
在 WebQSP 上:增益从 LLaMA-2 的 11.5% 扩大到 GPT-4 的 15.3%。
核心结论:这表明更强大的 LLM 能够更充分地挖掘外部知识图谱的潜力,做出更精准的剪枝与推理决策。
小模型搭配 ToG 反超大模型
跨级别对比:即使使用测试中参数量最小的模型 LLaMA2-70B,搭配 ToG 后的表现仍然超过了使用纯 GPT-4 的 CoT。
落地与部署启示:
该结果提供了一条成本更低的 LLM 落地技术路径:“小参数开源 LLM + ToG + 外部知识图谱” 有望成为昂贵闭源超大模型的有效替代方案。
尤其在外部 KG 覆盖度较高的垂直行业场景中,这种架构具有显著的性价比与实用价值。
3.2.3 消融实验
作者在 CWQ 和 WebQSP 这两个数据集上各随机采用 1000 道问题,形成两个测试集,用于开展消融实验。
搜索宽度与深度的影响
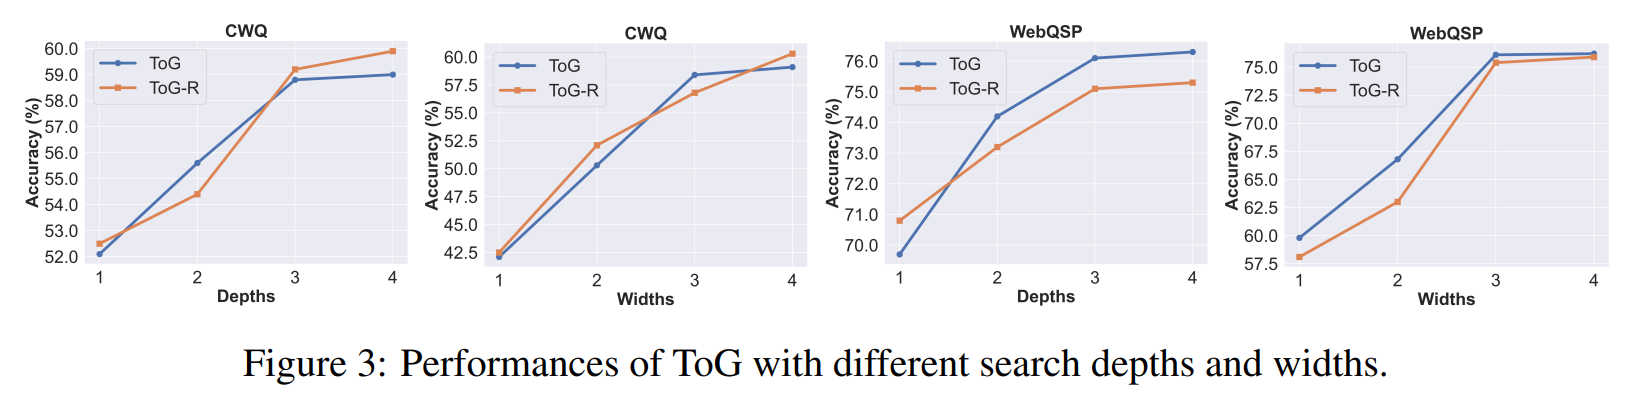
在深度(1 到 4)与宽度(1 到 4)的网格测试中,ToG 的表现整体随着搜索深度和宽度的增加而提升。这一趋势表明,扩大探索的深度与广度有望进一步挖掘系统的性能上限。
不过,当搜索深度超过 3 时,性能增长明显放缓。作者发现,基于 SPARQL 关系数量的统计显示,测试集中仅有极少部分问题的真实推理深度会大于 3 。因此,盲目增加深度并不能为绝大多数样本带来额外增益。
由于计算开销会随着搜索深度的增加呈线性增长,综合考虑推理性能收益与实际计算开销,作者最终将默认的束宽 N 与最大深度 Dmax 均统一设定为 3 。
不同知识图谱对 ToG 系统性能的影响
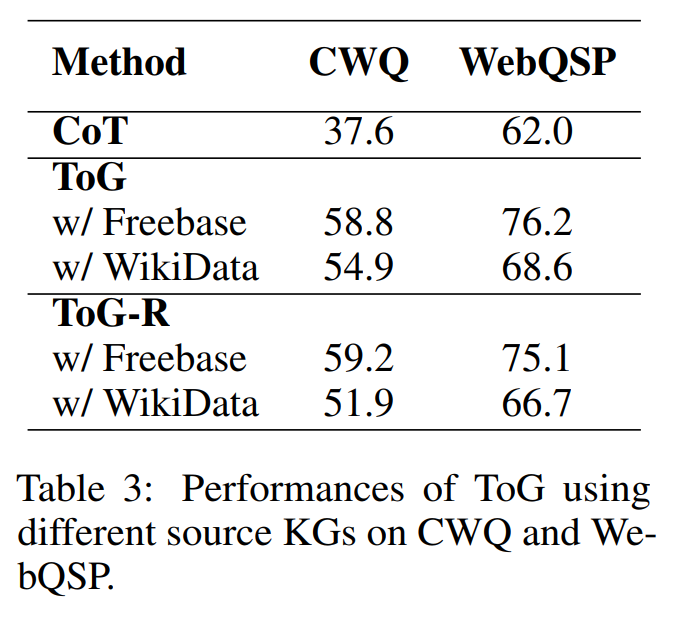
无论接入哪种外部知识图谱,ToG 在 CWQ 和 WebQSP 两个数据集上的表现相较于基线 CoT 均取得了显著提升。这验证了 ToG 具备良好的即插即用能力,不依赖于某一个特定的图谱结构。
不过,不同图谱源对 ToG 带来的性能提升幅度存在差异,作者指出了两个主要原因:
数据集原生构建基准的适配度:
Freebase 带来的提升明显高于 Wikidata。
成因:CWQ 和 WebQSP 两个数据集在最初构建时就是基于 Freebase 的实体与关系模式,因此在 Freebase 上探索能够更直接地匹配标准答案路径。
超大规模图谱的搜索与剪枝难度:
在类似 Wikidata 这种规模极其庞大的图谱中,单个节点所连接的关系和邻居实体密度更高、语义更为复杂,导致 LLM 在搜索与剪枝阶段面临更大的决策挑战。
提示词设计带来的影响
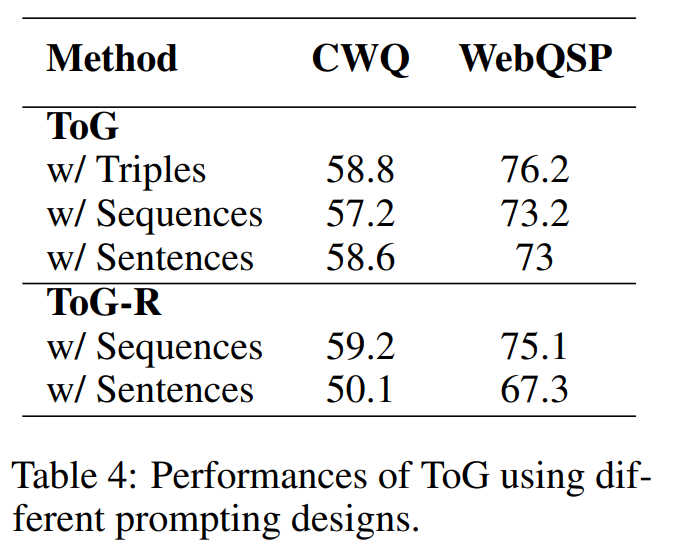
作者研究了以下三种 Prompt 格式对 ToG 系统的性能影响:
三元组格式(Triples):直接使用三元组形式拼接多条路径,例如: "(Canberra, capital of, Australia), (Australia, prime minister, Anthony Albanese)"
序列格式(Sequences):将一条完整的连续推理路径,用连字符或箭头连接成单条链式序列。例如:“Canberra -- capital of -- Australia -- prime minister -- Anthony Albanese -- political party -- Labor Party”
自然语言句子(Sentences):将三元组显式转化为完整的自然语言句子,例如将 "(Canberra, capital of, Australia)" 转换为 "The capital of Canberra is Australia."
实验结果表明,采用三元组格式来表示推理路径取得了最高的高效性与最优的性能。这是因为三元组格式结构清晰、冗余 Token 较少,便于 LLM 高效捕捉实体与关系之间的图拓扑逻辑。
对于 ToG-R 而言,由于其推理路径是从主题实体出发的关系链(省略了中间实体的确定性绑定),导致其无法直接适配标准的三元组格式。当尝试将 ToG-R 转换为自然语言句式输入时,会生成过长的 Prompt ,最终导致性能出现显著下滑。
不同剪枝工具的作用影响
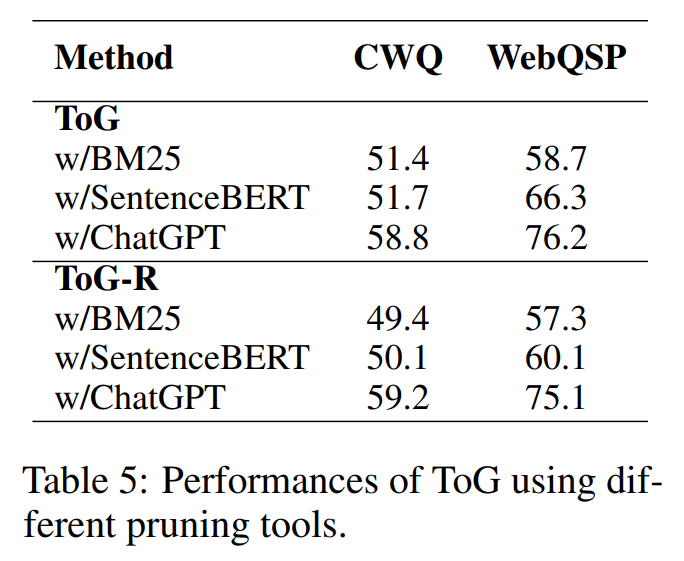
在探索阶段,尝试使用 BM25(基于词面重合度)或 SentenceBERT(基于语义向量相似度)来替代 LLM 作为剪枝工具。根据候选实体/关系与输入问题之间的字面或语义相似度,直接选取 Top-N 项。
实验结果表明,使用 BM25 或 SentenceBERT 替换 LLM 剪枝后,ToG 的准确率出现明显下滑:
在 CWQ 数据集上平均下降了 8.4%
在 WebQSP 数据集上平均下降了 15.1%
这表明,在保证推理有效性方面,LLM 作为剪枝工具的表现远优于传统的轻量相似度匹配模型。这表明多跳推理中的边筛选需要深层的逻辑理解,而非单纯的字面或语义匹配。
不过,当剪枝步骤完全由 BM25 或 SentenceBERT 接管后,探索阶段不再产生 LLM 调用。因此,原本全流程所需的最多 2ND + D + 1 次调用,大幅减少为仅需 D 次充分性评估 + 1 次最终答案生成。虽然牺牲了部分准确率,但这为计算资源受限、追求极致推理效率的场景提供了一种极轻量的备选方案。
3.3 知识可溯源性与可修正性分析
ToG 在推理过程中生成显式的推理路径,可完整呈现给用户或专家。这就使得双向增强成为可能:
常规方向:利用外部知识图谱增强大语言模型的推理能力;
反哺方向:借助 LLM 的反思能力与专家反馈来定位并修正 KG 中的错误/过时知识,从而用 ToG 自身降低知识图谱构建与维护的成本。
溯源与纠偏闭环流程
错误发现:人类专家或评估 LLM 发现 ToG 生成的答案存在异常。
路径回溯(Trace Back):ToG 沿生成的推理路径逐步倒查,定位可疑的三元组。
根因分析(Root Cause):分析实体命名变更、过时信息或关系错误。
修正与重新生成:用户依据提示指示 LLM 修正该错误,并基于更新后的正确事实重新回答问题。
案例分析
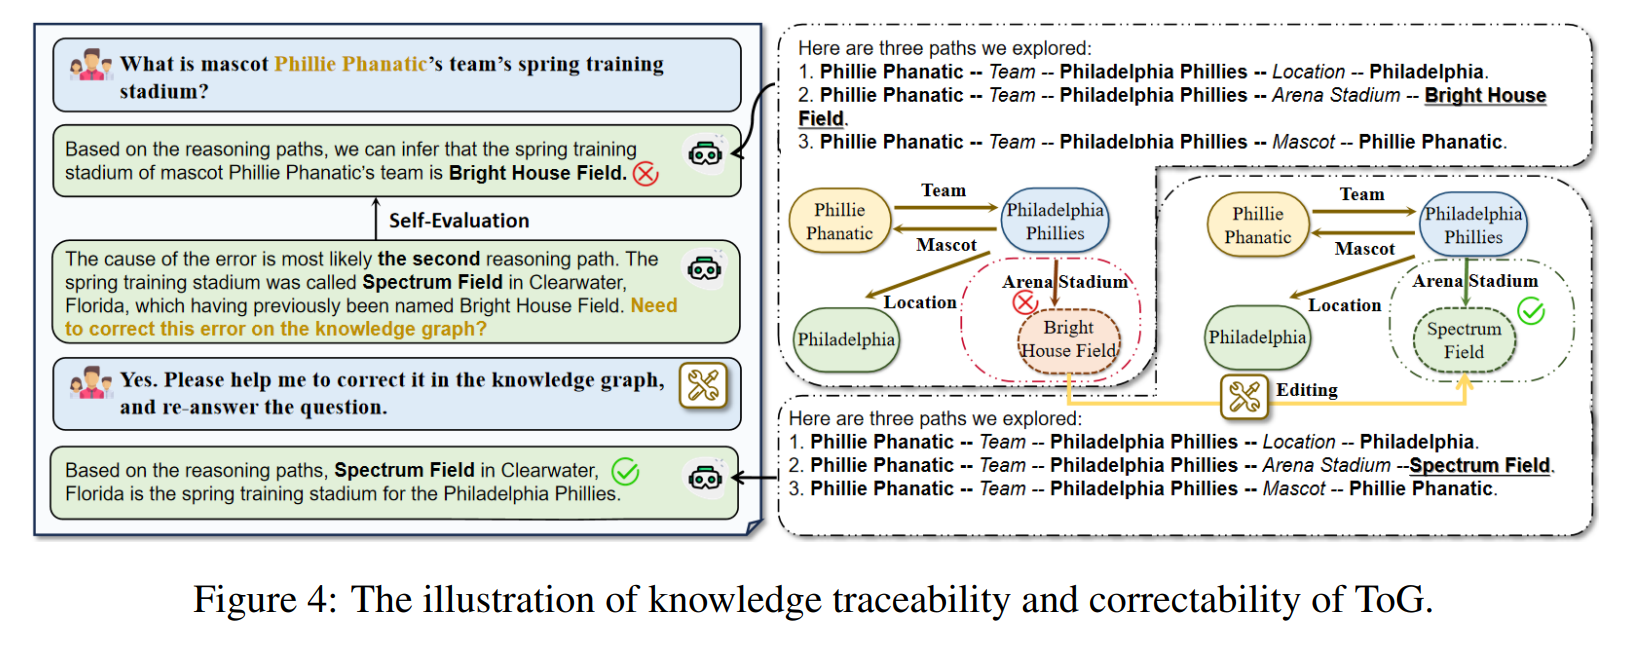
问题:“吉祥物 Phillie Phanatic 所在球队的春训球场是什么?”
ToG 第一轮输出了旧名称 "Bright House Field"。发现错误后,ToG 回溯第二条推理路径:
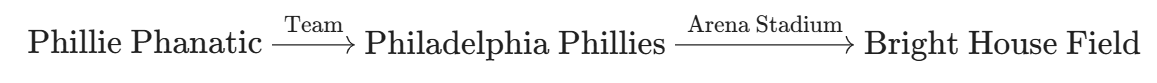
发现图谱中的三元组 (Philadelphia Phillies, Arena Stadium, Bright House Field) 使用了过时历史名称(Bright House Field 现已更名为 Spectrum Field)。
根据该定位提示纠正过时三元组后,ToG 成功输出最新且正确的球场名称。
4. 结论
作者提出了用于整合大语言模型(LLM)与知识图谱(KG)的 LLM ⊗ KG 范式,并提出了 Think-on-Graph(ToG)框架。该框架将 LLM 作为一个智能体(Agent)参与到知识图谱的推理过程中,以做出更优的决策。实验结果表明,ToG 在无需额外训练成本的前提下,表现优于现有的基于微调的方法以及基于提示(Prompting)的方法,并有效缓解了大语言模型的幻觉问题。