

今天研读《Reasoning on Graphs: Faithful and Interpretable Large Language Model Reasoning》
开源实现:RoG
1. 为什么要引入 RoG ?
目前 LLM 在许多复杂的 NLP 任务中展现出了强大的推理能力。为了进一步激发 LLM 的推理能力,传统研究提出了规划求解范式,即让大模型先生成一个规划,然后逐步执行各个推理步骤,从而将复杂的推理任务分解为一系列子任务并逐一解决。
然而,LLM 受限于知识储备不足,且在推理过程中容易产生幻觉,进而引发推理过程中的错误。这些问题削弱了模型在法律判决、医疗诊断等高风险场景中的性能与可信度。下图展示了 LLM 在推理中可能出现缺乏最新知识或者生成了不正确的推理步骤等现象:
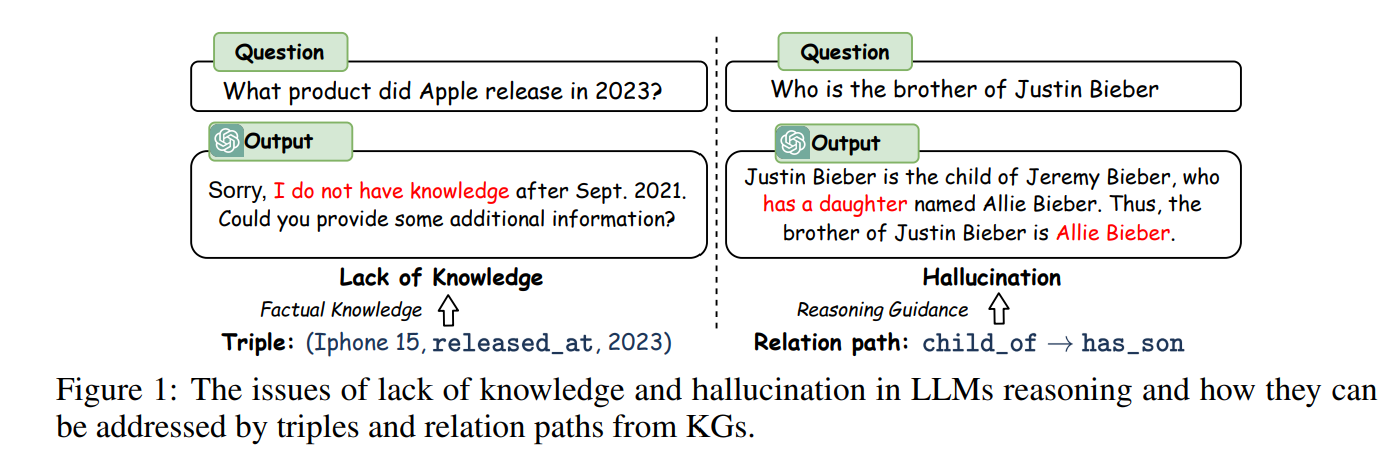
为了解决上述问题,研究者引入了知识图谱(KG)。在知识图谱问答(KGQA)任务中,以往结合 KG 与 LLM 的方法主要分为两类:
基于现有两类方法的不足,作者认为,使大语言模型能够直接在知识图谱上展开推理,对于实现忠实且可解释的推理是十分必要的。
因此,作者提出 RoG(Reasoning on Graphs)方法:
目标:通过 LLM 与知识图谱的协同,实现忠实且可解释的推理,以缓解大模型的知识缺失与幻觉问题。
解决思路:提出 Planning-Retrieval-Reasoning(规划-检索-推理) 框架,不仅从知识图谱中检索最新知识,而且利用知识图谱的结构信息来引导推理与生成解释。
其中,
规划模块:
生成以知识图谱为依托的关系路径,并将其作为推理的忠实规划。
检索-推理模块:
利用规划好的关系路径,从知识图谱中检索出有效的推理路径。
基于检索到的实体与关系路径,由大模型展开忠实推理并得出最终答案。
为了使框架具备上述能力,作者为 RoG 设计了两个训练优化任务:
在推理阶段,RoG 的规划模块可以与不同的外部大语言模型灵活搭配使用,从而提升其他模型的推理表现。
此外,在两个基准 KGQA 数据集上的实验结果表明,RoG 在知识图谱推理任务上取得了当前 SOTA 的表现,并生成了忠实且可解释的推理结果。
2. RoG 建模
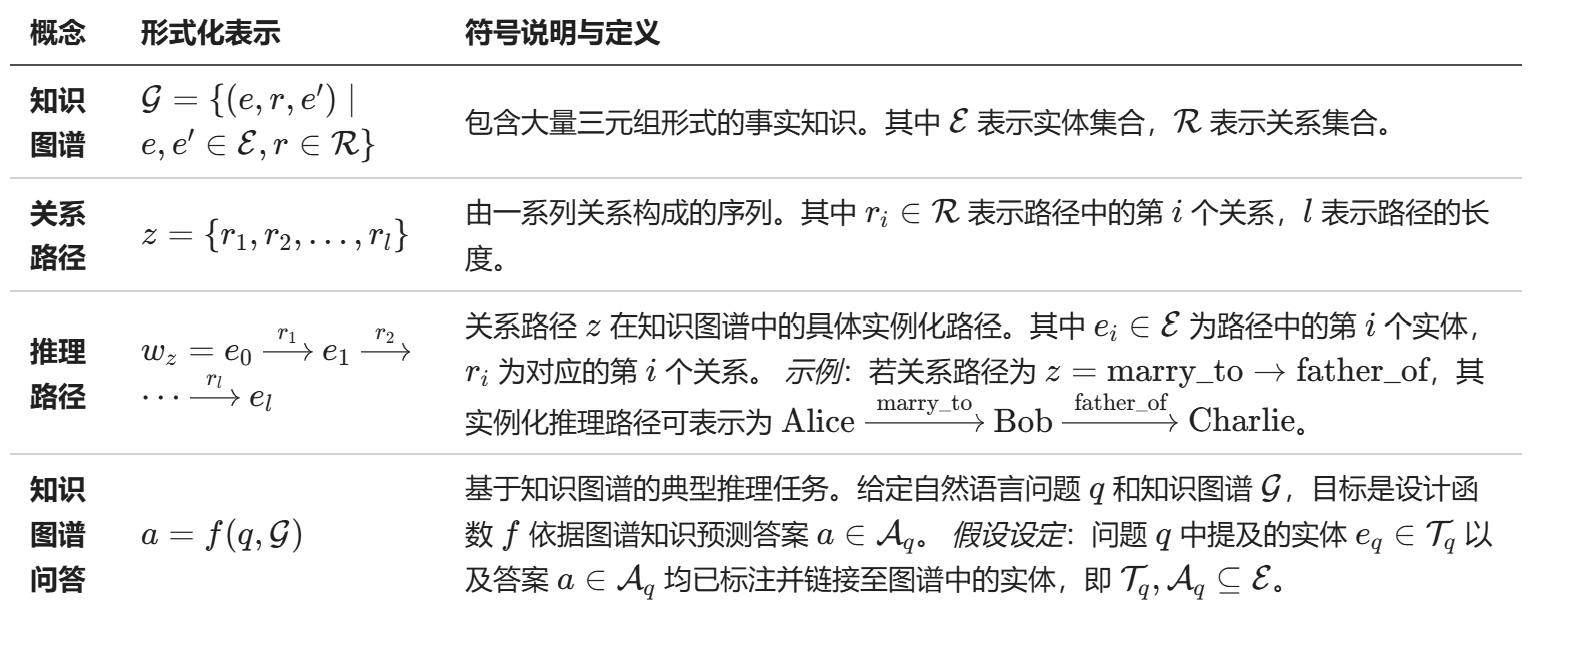
以下是符号定义与说明:
2.1 RoG 架构概述
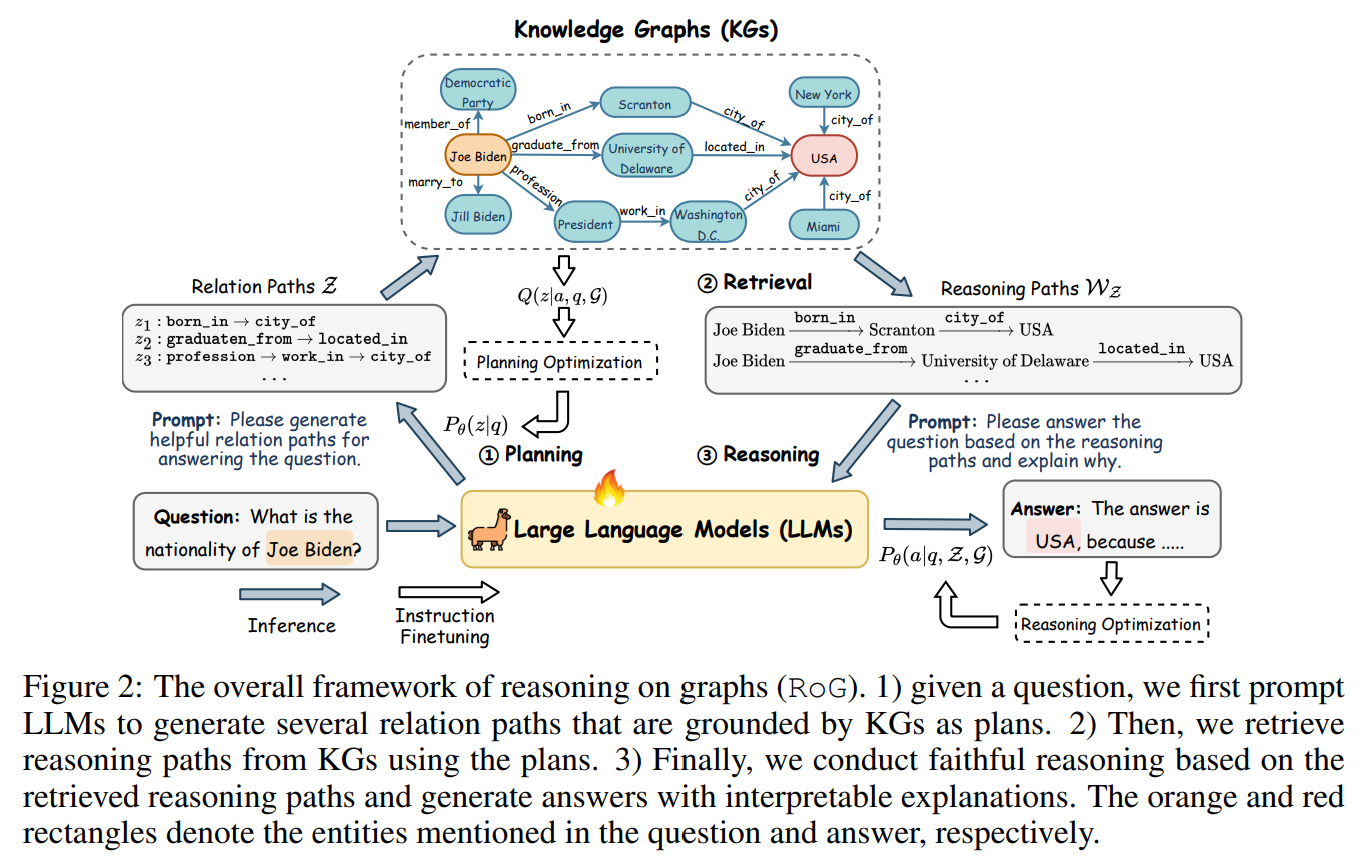
近期许多研究通过“先 LLM 生成规划、再基于规划推理”的方式提升其推理能力。但由于大模型存在幻觉问题,容易生成错误的规划,进而得出错误答案。因此,作者提出“规划-检索-推理”框架,让推理规划以知识图谱为依托,随后从图谱中检索出忠实的推理路径供大模型开展推理。
选择“关系路径”作为规划方案的原因:
语义关联性:关系路径能够捕捉实体之间的语义关系,在知识图谱的多类推理任务中已被广泛采用。
稳定性更高:相较于动态更新的实体,知识图谱中的“关系”更加稳定。
支持获取最新知识:利用相对稳定的关系路径,能够随时从知识图谱中检索出最新的知识实例用于推理。
基于上述特性,关系路径能够作为知识图谱问答(KGQA)任务中忠实可靠的规划。
下面通过一个例子来直观展示 RoG 的运行过程:
问题:Who is the child of Alice ?(谁是 Alice 的孩子?)
规划生成:
模型生成关系路径 z = marry_to ->father_of 。该路径表达了两步规划:
找到与 Alice 结婚的人;
找到该人的孩子。
规划执行与检索:
在知识图谱中执行该规划,检索得到具体的实例化推理路径:
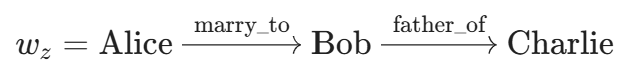
得出答案:
依据推理路径确定最终答案为 Charlie 。
2.2 形式化建模
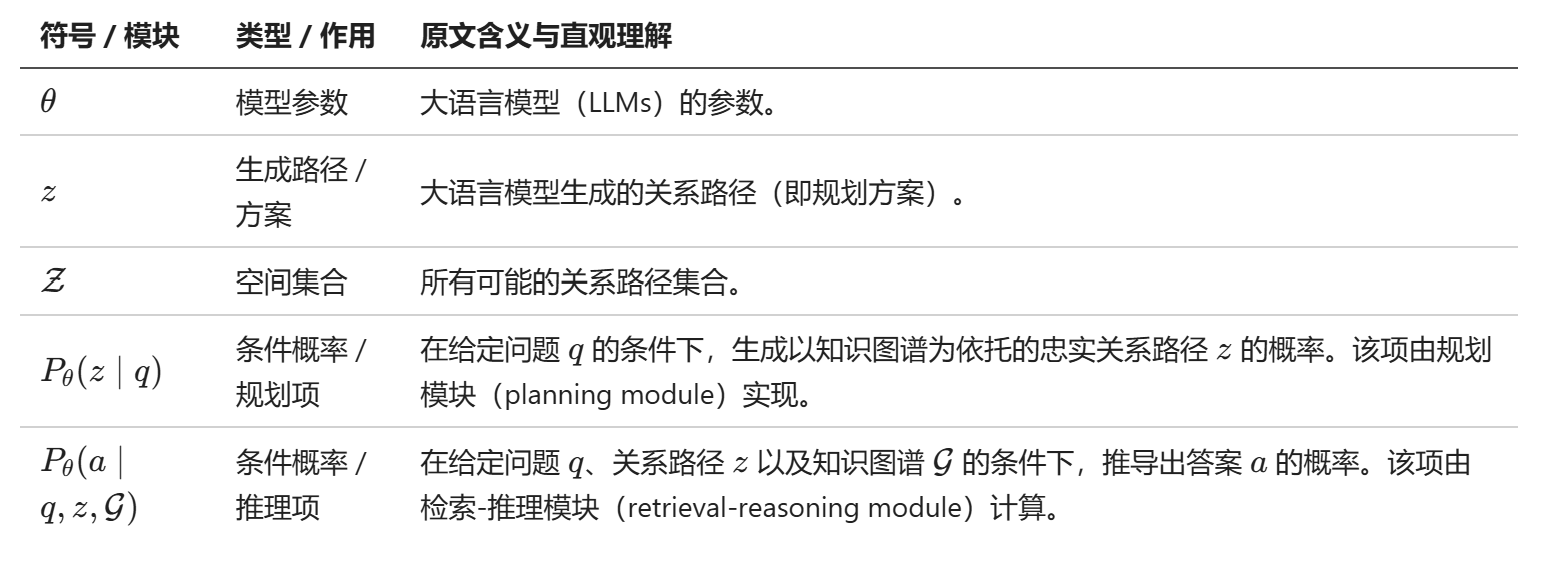
RoG 将整个推理过程建模为一个优化问题,目标是在给定问题 q 和知识图谱 G 的条件下,通过生成关系路径 z 作为规划,最大化推导出正确答案 a 的概率:
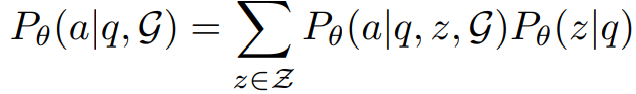
公式中各项参数与概率项定义如下:
优化框架概述
未经微调的 LLM 在图推理任务中存在两个固有局限:
对图谱关系零认知:预训练 LLM 对知识图谱中的具体关系集合没有先验概念,无法凭空生成符合特定知识图谱结构的关系路径。
推理路径理解力不足:LLM 在接收到图谱检索出的推理路径后,不一定能够正确理解其图结构语义并据此推导出正确答案。
为了解决这两个问题,作者设计了规划优化与检索-推理优化两个指令微调任务。
作者利用变分推断,将上述优化目标转化为最大化证据下界(ELBO):
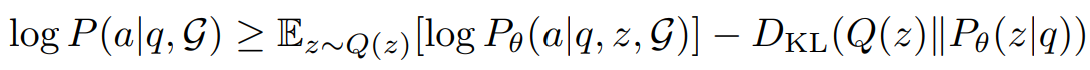
其中,Q(z) 表示以知识图谱为依托的忠实关系路径的后验分布。
该不等式右侧清晰地拆解为了两个优化部分:
规划优化 —— 对应 KL 散度项:
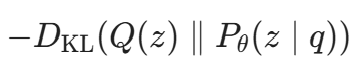
目标:最小化真实后验分布 Q(z) 与模型生成分布 Pθ(z | q) 之间的 KL 散度。
作用:将知识图谱中实际存在的有效关系路径分布蒸馏给大模型,使大模型学会仅根据问题 q 就生成忠实可行的关系路径 z 。
检索-推理优化 —— 对应期望项:
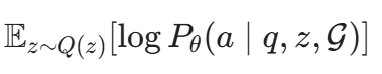
目标:最大化检索-推理模块在采样自 Q(z) 的关系路径及图谱 G 支持下生成正确答案 a 的条件对数似然期望。
作用:训练大模型依据检索出的具体推理路径 wz 准确完成答案推导。
规划优化
在训练阶段,由于问题 q 和正确答案 a 都是已知的,作者首先在知识图谱 G 中寻找连接问题实体 eq 与答案实体 ea 的具体路径实例:
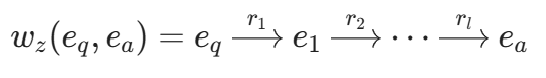
抽取出来的关系序列 z = {r1, r2, . . . , rl} 即为有效的规划。作者假设所有有效关系路径服从均匀分布,从而将后验分布形式化近似为:
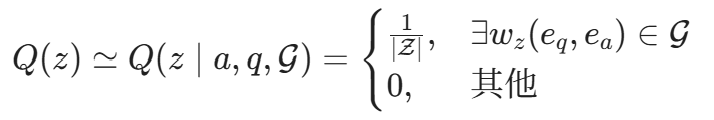
即:只要在图谱中存在连接 eq 和 ea 的实例化路径,该关系路径 z 就被视为有效路径,并赋予相同的概率权重 1 / | Z | 。其中 Z 是所有有效路径组成的集合。
为了让大模型学会生成上述有效路径,模型需要最小化真实后验分布 Q(z) 与模型生成分布 Pθ(z | q) 之间的 KL 散度。具体损失函数展开如下:
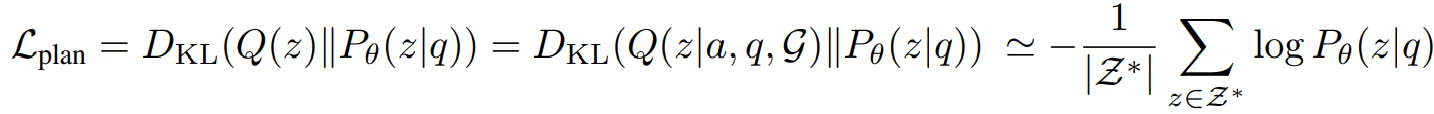
在具体实现中,作者采用了最短路径集合 Z* ⊆ Z 作为监督信号:
知识图谱中连接 eq 和 ea 的路径可能非常多,选择最短路径可以保留最紧凑、最直接的推理逻辑。
优化该损失函数,在工程实现上等价于以最短关系路径作为标签,对大模型进行标准负对数似然(交叉熵)监督微调。
通过优化参数 θ ,将知识图谱中的先验结构逻辑蒸馏内化进模型权重中,使大模型在仅输入问题 q 时,便能预测出符合图谱规范的关系路径规划。
检索-推理优化
优化目标:使大语言模型学会基于知识图谱中检索到的多条推理路径进行准确推理。
检索-推理模块参考了 Fusion-in-Decoder(FiD)框架的设计,支持模型在多条检索到的推理路径上进行综合推理。给定规划路径集合 Z ,答案的生成概率建模为各单路径生成概率的乘积:
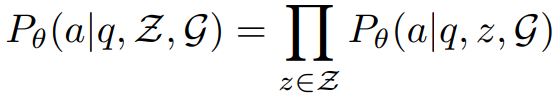
在训练计算时,直接对全量后验分布计算期望计算量较大,作者从真实最短路径集合 Z* 中采样 K 个规划路径构成子集来近似期望:
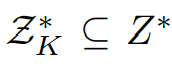
推理优化目标函数定义为:
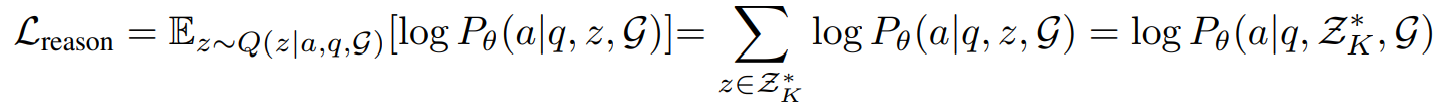
该目标旨在最大化 LLM 在给定问题、采样规划路径及图谱实例条件下输出正确答案的对数概率。
结合上述两个优化目标,得到 RoG 的整体训练目标函数:
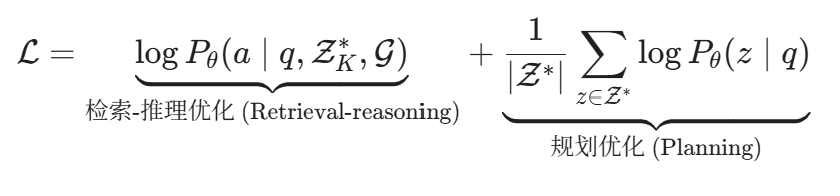
RoG 采用同一个大语言模型(参数均为 θ )同时承担“规划”与“推理”两个角色。因此可以通过构建规划任务(输入问题 -> 输出关系路径规划)与检索推理任务(输入问题 + 检索到的图路径 -> 输出最终答案与解释)两类指令微调数据,对同一个大模型进行多任务联合训练。
2.3 两大模块的具体实现
规划模块
为了利用 LLM 的指令遵循能力,作者设计了如下简单的提示词模板:
Please generate a valid relation path that can be helpful for answering the following question: <Question>
其中 <Question> 会被替换为具体的自然语言问题 q 。
LLM 接收到“提示词 + 问题”后,生成格式化的关系路径文本。该文本使用特殊标记进行界定:

<PATH>:表示关系路径的起始。
<SEP>:关系与关系之间的分隔符。
</PATH>:表示关系路径的结束。
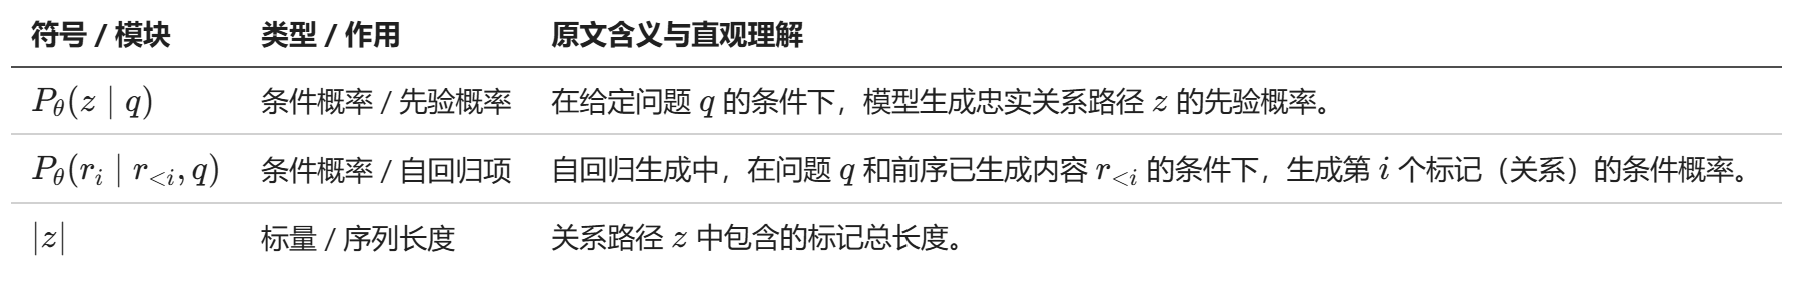
规划模块的优化目标是将图谱中提取的最短关系路径 Z* 作为标准目标,通过标准的自回归语言建模方式最大化似然概率:
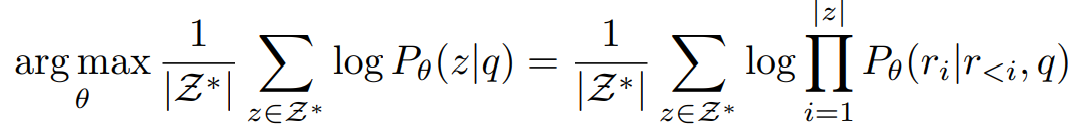
符号解释:
检索-推理模块
路径检索机制(Retrieval)
给定问题 q 和规划好的关系路径 z={r1, r2, ..., rl} ,检索模块的目标是从知识图谱 G 中找出所有从问题实体 eq 出发、并严格沿着关系序列 z 延伸的具体推理路径集合 Wz :
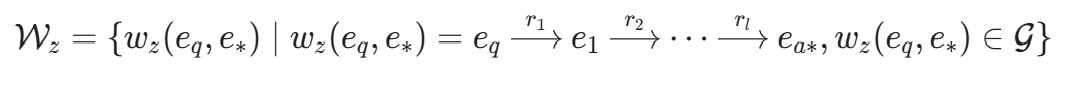
这里采用受限广度优先搜索算法从知识图谱中检索实例化路径 wz 。“受限”体现在搜索的每一步都必须严格受到关系序列 {r1, r2, ..., rl} 的约束,只沿着指定的关系类型向外扩展,从而将图谱搜索空间限制在规划好的路径拓扑之内。
推理模块
从图谱检索出的推理路径实例可能存在噪声,或者存在与问题不相关的分支路径,如果直接对路径终点实体进行简单的多数投票,容易得到错误答案。
因此,论文提出利用 LLM 的语义理解能力:
由 LLM 对检索到的多条推理路径进行辨识,筛选出关键路径;
结合具体问题上下文排除噪声干扰,从而推导出准确答案。
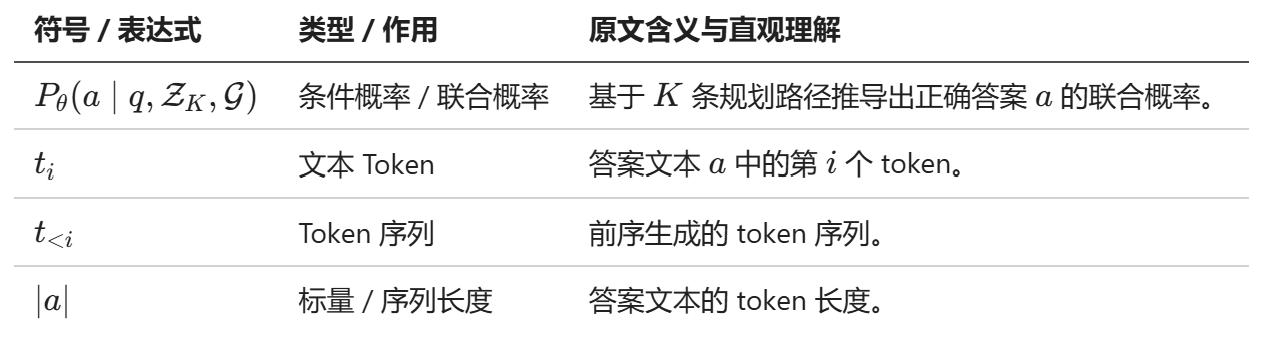
具体而言,将问题 q 与检索到的推理路径集合 Wz 整理为一系列结构化的文本句子,填入专门设计的推理提示词中。然后,在采样得到的 K 条规划路径 Z*K 及其对应的推理路径实例 Wz 下,以自回归的方式最大化答案 token 序列的生成概率:
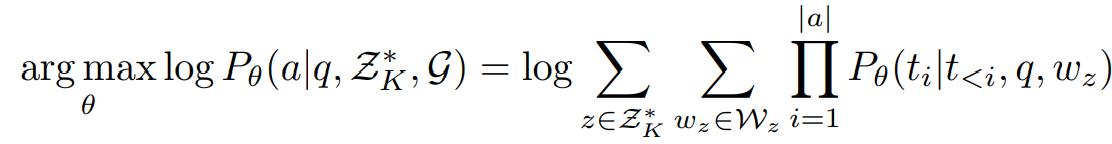
符号解释:
3. 实验与结果
3.1 基础配置
3.2 实验结果
知识图谱问答任务上的对比实验
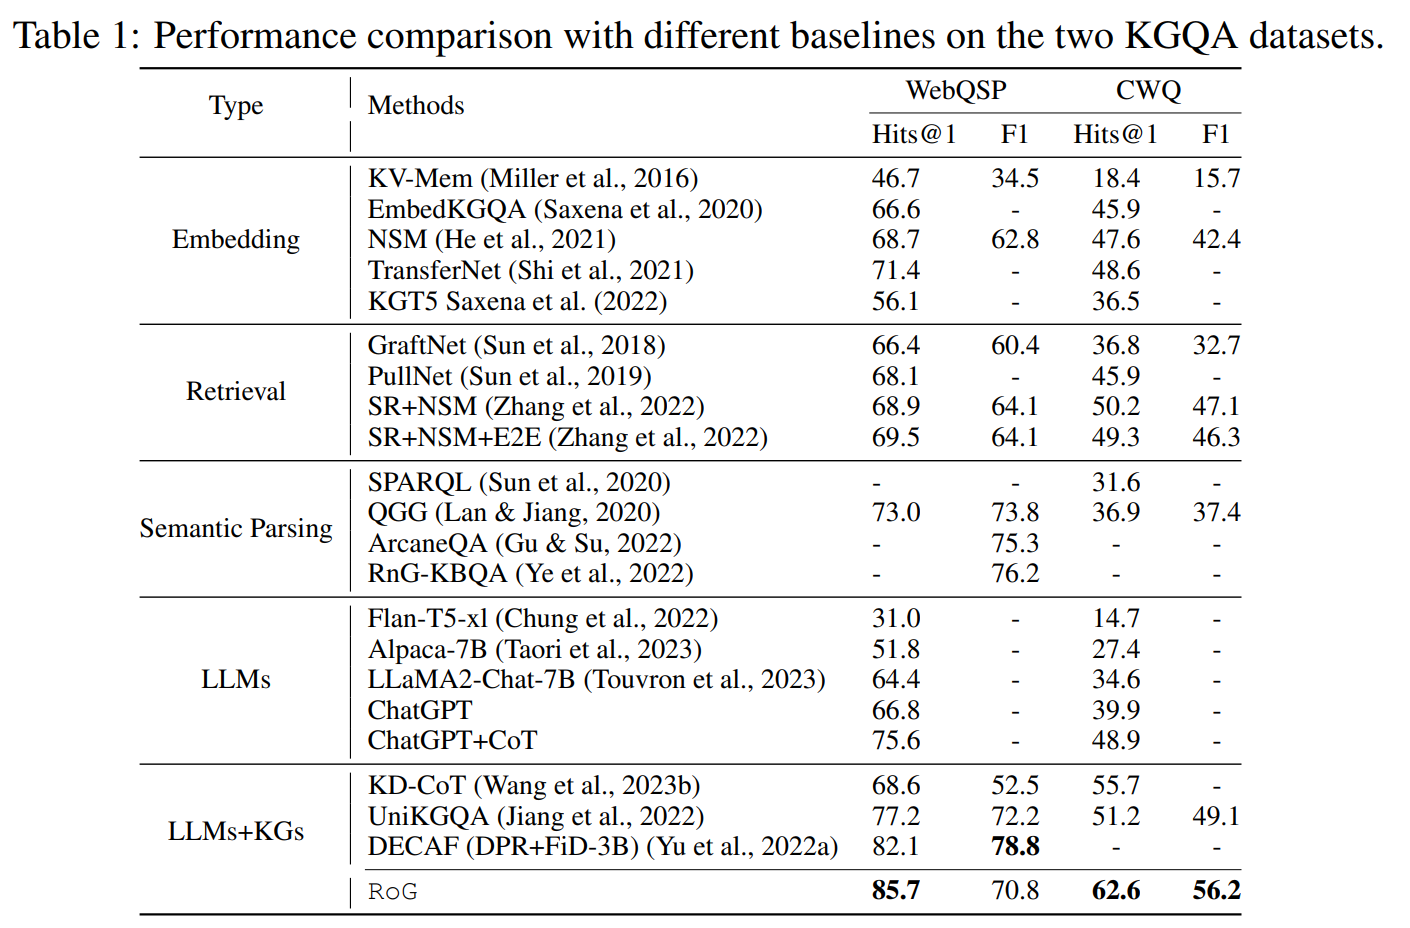
整体表现:RoG 在两个数据集的大多数评估指标上均取得了 SOTA 的结果。
对比分析:
检索增强方法 vs. 基于嵌入的方法:
检索增强方法优于传统的基于嵌入的方法,原因在于其能够从知识图谱中检索出相关子图,从而降低了推理复杂度。
关系路径检索的有效性:
基线中的 SR+NSM 与 SR+NSM+E2E 采用了基于关系路径的检索方式,取得了更优的表现,体现出关系路径对推理任务的重要作用。
语义解析方法的跨数据集表现分化:
语义解析方法在 WebQSP 上的表现优于检索增强方法,但在 CWQ 上的表现出现下滑。原因在于 CWQ 中问题的复杂性增加,使得生成可执行的逻辑查询语句难度增大。
纯大语言模型方法:
纯 LLM 方案取得了相当的(comparable)表现,但受限于模型固有的幻觉问题以及知识储备的匮乏。
大模型与图谱结合方法:
该类方法取得了第二好的成绩,印证了将知识图谱与大语言模型协同用于推理路线的有效性。
消融实验
实验变体设计:
w/o planning(移除规划模块):去除关系路径规划,不进行路径检索,模型仅依据输入的问题直接进行推理。
w/o reasoning(移除推理模块):去除大模型推理步骤,直接将检索到的所有推理路径的末端实体作为最终答案集合。
w/ random plans(随机规划路径):不使用规划模块生成的关系路径,而是从知识图谱中随机抽取推理路径并输入给推理模块。
w/ vote reasoning(多数投票推理):不用大模型处理检索路径,而是通过多数投票机制,从检索出的推理路径中选取出现频次最高的前 5 个答案。
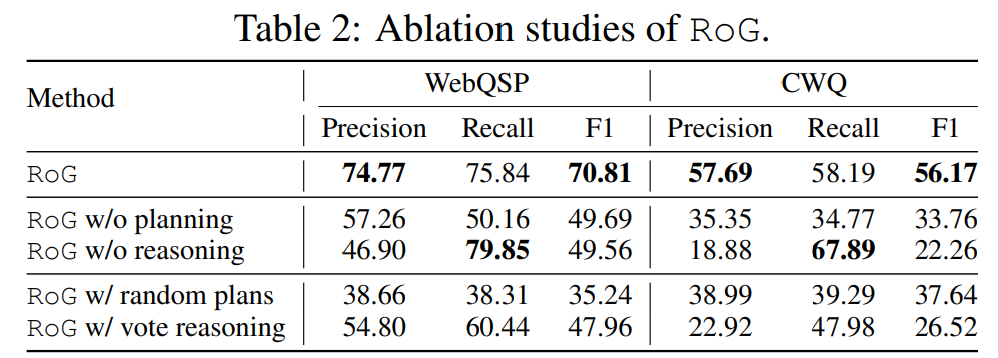
实验结论:
规划模块的不可替代性:
当去除规划模块(w/o planning)时,系统退化为传统的无外部知识的大模型,暴露出知识缺失的问题。
当使用随机路径(w/ random plans)时,实验表现比完全去除规划模块(w/o planning)还要差。这表明输入无关或错误的图谱路径会干扰推理,进一步突显了规划模块生成“忠实关系路径”的核心价值。
推理模块对噪声过滤的关键作用:
去除推理模块(w/o reasoning)虽然返回了大量候选实体从而取得了较高的召回率(recall),但由于检索路径中混杂了大量噪声,导致精确率(precision)大幅下降。这一现象印证了推理模块在识别重要路径、过滤图结构噪声方面的必要性。
采用简单的多数投票(w/ vote reasoning)虽然表现优于不加筛选的 w/o reasoning,但仍弱于完整的大模型推理模块,验证了大模型结合自然语言语义进行综合推理的有效性。
推理基座 LLM 的影响
本实验使用训练好的 RoG 规划模块为输入问题生成关系路径规划,据此从知识图谱中检索出对应的推理路径,随后将这些推理路径作为上下文背景直接输入给待测的各类 LLM 进行推理。评测涵盖了 ChatGPT、Alpaca、LLaMA2 以及 Flan-T5 等不同架构与规模的大语言模型。
由于从大模型的自由文本输出中较难准确统计出实体答案的具体数量,因此该组实验未采用 F1 指标,仅汇报了 Hits@1 与 Recall(召回率) 两个评估指标。
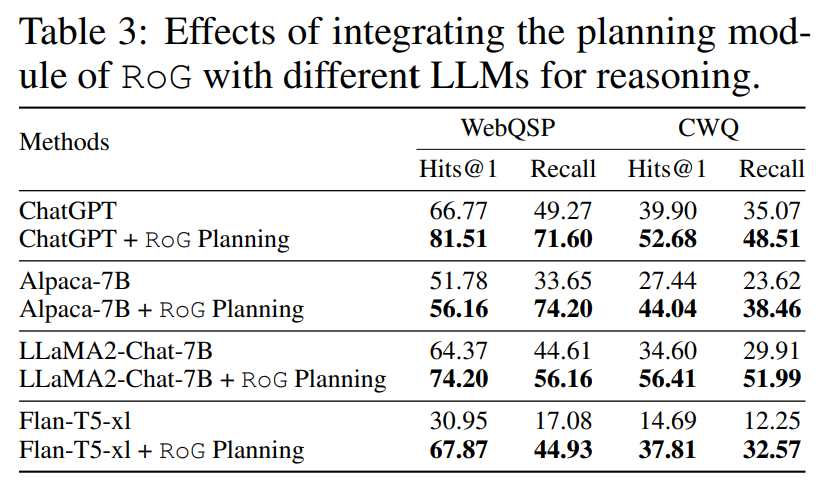
实验结论:
能提升:所有参与测试的大语言模型在接入 RoG 的规划模块后,性能均获得了提升。
无需重新训练:实验验证了 RoG 的规划模块具备良好的模块化解耦特性,在不改变其他大模型权重、无需额外训练的前提下,能够无缝接入任意大模型,并有效利用图谱结构路径辅助其完成知识推理。
规划路径数量 K 的取值权衡
作者在实验中对 RoG 生成的 Top-K 关系路径数量进行了参数遍历分析:
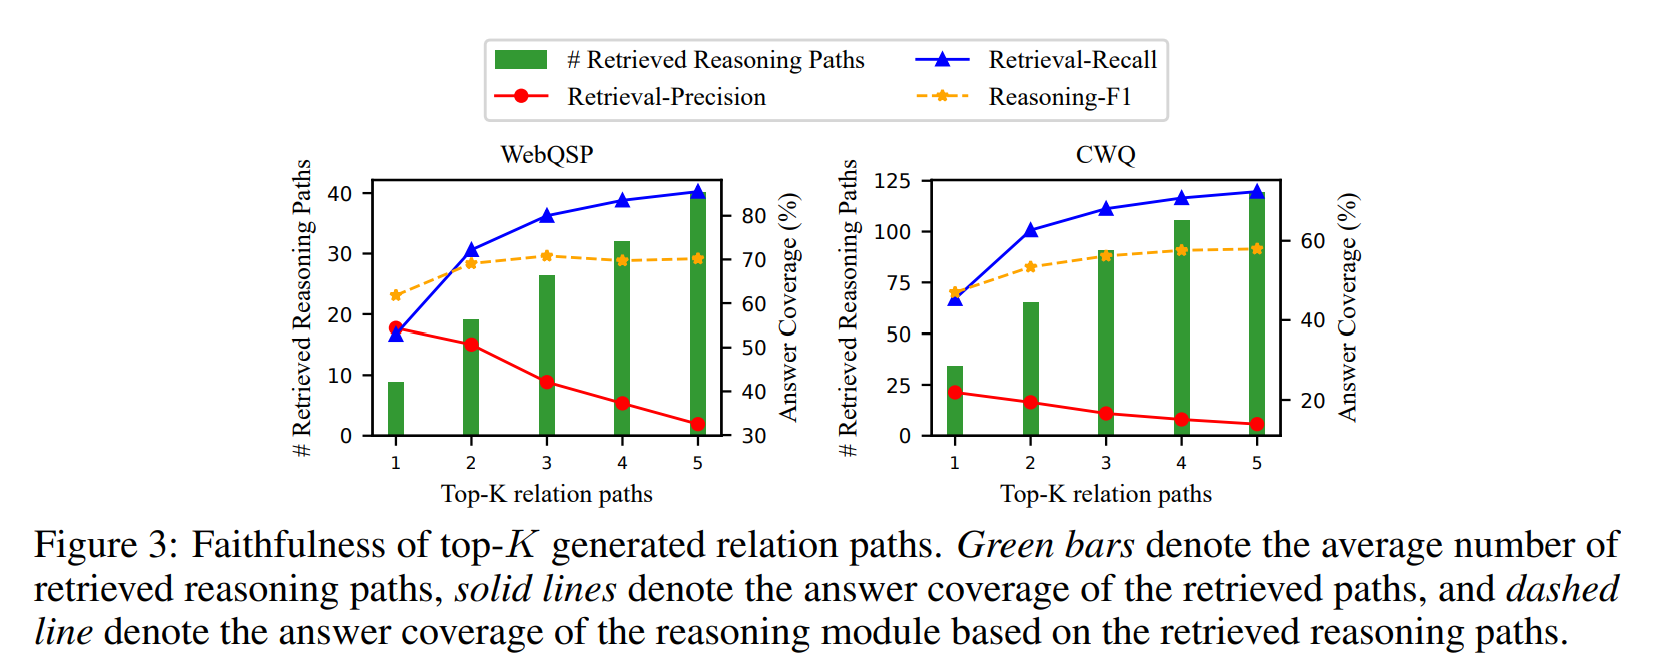
随着 K 值增加的正向表现:
从知识图谱中检索到的推理路径数量随之增多;
答案的召回率(Recall)有所提升。这一现象证明了模型生成的关系路径在检索真实答案方面的忠实性。
随着 K 值增加带来的负面影响:
检索到的推理路径包含了更多的无关噪声;
检索过程的时间开销明显增加;
预测的精确率(Precision)出现下降,并且对最终的推理综合表现(Reasoning-F1)贡献微弱。
参数设定结论:
综合考虑召回率、噪声控制与检索效率的平衡,作者在其他实验中将参数统一设定为 K = 3 。
案例分析:与 ChatGPT+CoT 的对比
论文通过两个典型案例展示了 RoG 与基线模型在实际问答中的差异:
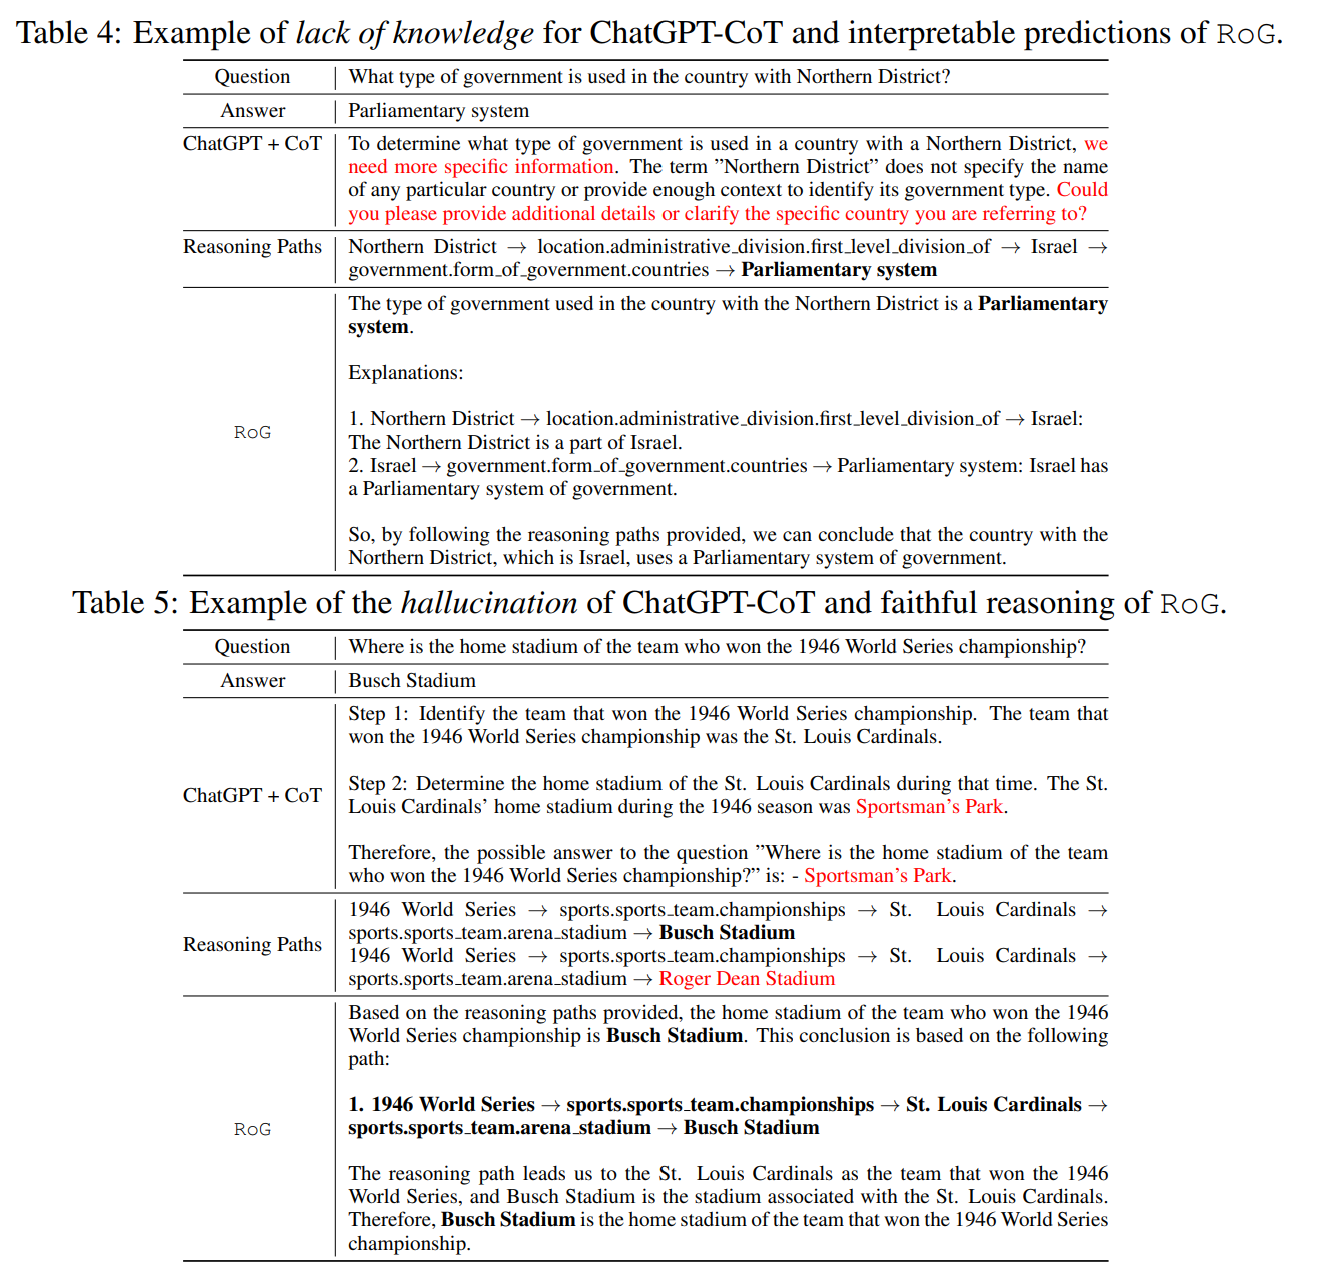
知识缺失场景(Table 4):
ChatGPT+CoT:受限于模型自身参数化知识的不足,无法回答问题;
RoG:生成了忠实的关系路径,并从知识图谱中检索出有效的推理路径实例,进而基于这些路径给出了具备可解释性的答案说明。
幻觉干扰场景(Table 5):
ChatGPT+CoT:推理过程中产生了幻觉,给出了错误的实体答案;
RoG:尽管检索到的推理路径中混杂了部分噪声路径,但推理模块能够辨识出正确的关键推理路径,排除了噪声干扰,完成了忠实的推理推导。
这两个案例验证了 RoG 在知识补全、抑制模型幻觉以及提供结构化可追溯解释方面的有效性。
4. 结论
作者在本研究中提出了一种名为图上推理(RoG,Reasoning on Graphs)的新方法,该方法协同 LLM 与知识图谱来开展忠实且可解释的推理。为了缓解幻觉与知识匮乏的问题,作者提出了一个规划-检索-推理(planning-retrieval-reasoning)框架,允许大语言模型获取最新知识,同时基于图谱上忠实的规划展开推理。RoG 不仅通过训练从知识图谱中蒸馏知识来增强大语言模型的推理能力,而且在推理阶段支持与任意大语言模型的无缝集成。在两个基准知识图谱问答(KGQA)数据集上的充分实验表明,RoG 在推理能力和可解释性方面具有优越性。