

今天研读 《OmniDocBench: Benchmarking Diverse PDF Document Parsing with Comprehensive Annotations》
开源实现:OmniDocBench
1. 什么是 OmniDocBench ?
文档解析作为计算机视觉与文档智能领域的一项核心任务,旨在从诸如 PDF 等非结构化文档中提取结构化且机器可读的内容。这一任务对于将学术论文、技术报告、教科书等富文本资源输入大语言模型尤为关键,从而能够增强模型的事实准确性与知识支撑能力。此外,RAG 系统依据外部文档检索并有针对性地生成回答,因此对精确文档理解的需求也更为强烈。为应对这一具有挑战性的任务,主要形成了两种范式:
基于流水线的方法:将任务分解为版面分析、OCR、公式与表格识别以及阅读顺序预测;
端到端视觉-语言模型:直接输出结构化表征(例如 Markdown)。
尽管这两种方法均取得了良好的效果,但由于缺乏全面且统一的评估基准,对两者的有效性进行广泛对比仍然存在困难。
对于这两种方法,现有的评估基准大致整理如下:
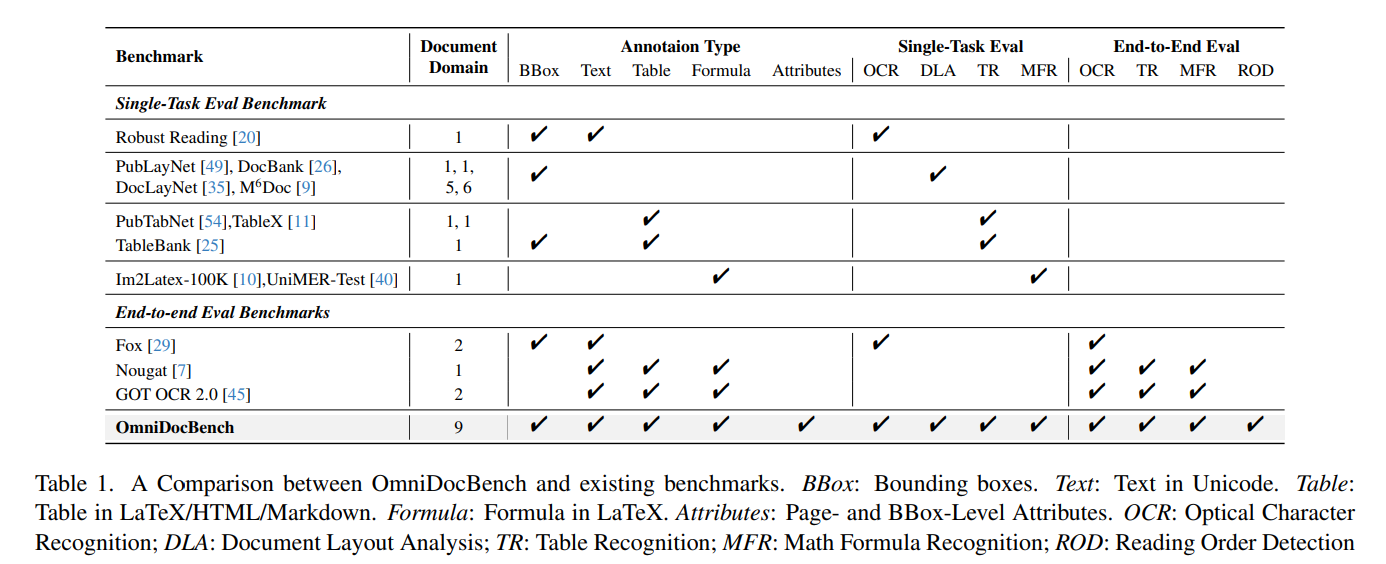
针对基于流水线的文档解析系统,已开发出专门针对特定子任务的基准数据集。而对于端到端评估,像 Nougat 与 GOT-OCR 等工作提供了规模相对较小的验证集,并使用编辑距离等页面级指标来评估预测结果。
然而,这些基准存在若干关键局限:
文档多样性有限:现有数据集主要集中在学术论文上,忽略了教科书、试卷、财务报告和报纸等其他真实世界的文档类型;
评估指标不一致:当前基准严重依赖通用的文本相似度指标(例如编辑距离和 BLEU),而这些指标无法公正地评估支持多样化句法表达的 LaTeX 或 HTML 格式中的公式与表格准确率;
缺乏细粒度评估:大多数评估仅报告总体得分,无法深入了解具体不足,例如元素级得分(如正文文本与公式的对比)或各个文档类型的具体表现(如杂志或笔记)。
作者于是提出了 OmniDocBench ,一个旨在为基于流水线和端到端两种范式的文档解析模型提供严格且全面评估的新基准。主要包含三大贡献:
高质量、多样化的评测集:纳入了涵盖教科书到报纸等 9 类不同文档类型的页面,采用“自动化工具标注 + 人工核验 + 专家审查”相结合的三级流程进行标注。
灵活、多维度的评估体系:支持三个层级的全面评估——端到端评估、特定任务评估以及基于属性的评估。
端到端评估:衡量整页解析结果的总体质量;
特定任务评估:允许用户评估各个独立组件,例如版面检测、OCR、表格识别或公式解析;
基于属性的评估:在 9 种文档类型、6 个页面级属性和 9 个边界框级属性上提供细粒度分析。
对前沿方法的全面基准评测:系统评估了一系列具有代表性的文档解析系统(涵盖基于流水线的工具与视觉-语言模型),提供了全面的对比分析,并识别了各模型在不同文档类型与内容结构上的性能瓶颈。
2. OmniDocBench 数据集介绍
作者通过数据采集、智能预标注以及人工精修三个阶段来构造数据集,可以参见下图:
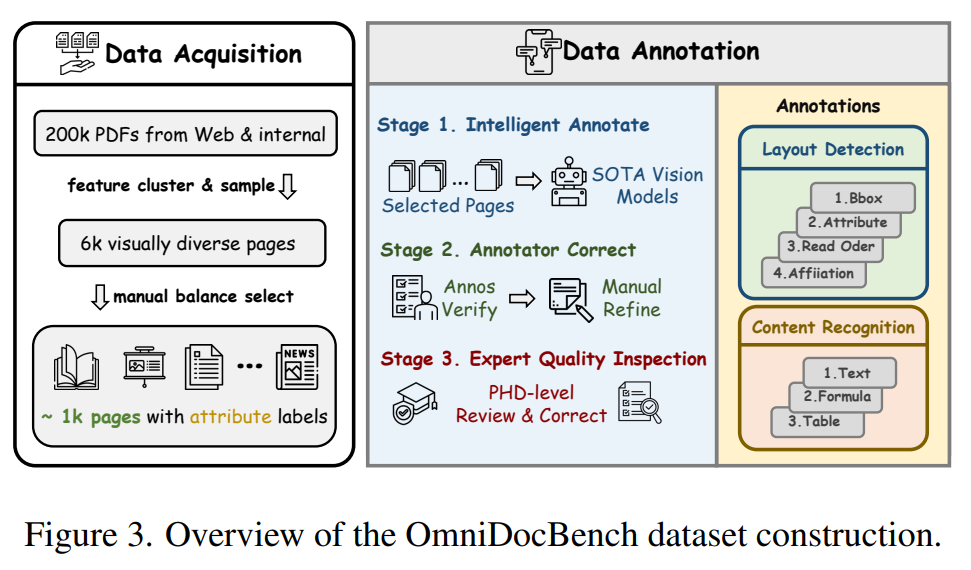
这确保了 OmniDocBench 具备以下关键特性:
页面多样性:作者从多种不同来源采集文档页面,以确保覆盖广泛的文档类型。
标注全面性:作者对页面上的所有元素进行了详尽标注,包括边界框、具体内容以及各种潜在属性。
标注准确性:作者通过结合半自动化标注流程、标注员修正以及专家质量检查,确保所有标注结果的可靠性。
2.1 数据获取
作者采用算法粗筛(视觉多样性聚类)+ 人工细筛(页面属性平衡)的方法筛选数据:
从 Common Crawl、Google、百度搜索引擎以及内部数据中收集了超过 200,000 份初始 PDF 文档。
使用 ResNet-50 提取这些文档页面的视觉特征,并使用 Faiss 进行聚类,从 10 个聚类中心中采样了 6,000 个具有视觉多样性的页面。
最终,标注人员提供了页面级属性标注(包括页面类型、版面类型和语言类型),并进一步均衡筛选出 981 个样本构成最终的数据集。
OmniDocBench 数据集包含来自 9 种不同类型、多种版面类别和各类属性标注的页面,覆盖了广泛的真实世界场景。
2.2 数据标注
OmniDocBench 将页面标注划分为版面检测标注与内容识别标注两大板块:
版面检测标注:
内容识别标注:
标注流程主要包括智能自动标注、标注员修正以及专家质量检查三个阶段:
自动预标注:分别使用微调后的 LayoutLMv3 进行版面检测标注,使用 PaddleOCR、UniMERNet 和 GPT-4o 分别进行文本、公式和表格的预标注。
标注员修正:在版面检测阶段后,标注人员精细修正检测边界框,并补充阅读顺序与层级归属等细节标注。针对内容识别,逐字符进行核对以确保准确性。此外,对于需要 LaTeX 和 HTML 格式的复杂表格和公式标注,标注人员使用 Tables Generator 和 latexlive 等辅助工具进行验证与修正。
专家质量检查:先利用 CDM 的渲染技术来识别无法正常渲染的元素,然后由三位研究人员对这些异常元素进行复核与修正,以确保最终标注的准确性。
2.3 数据集的统计特征
页面层级多样性:
标注层级与元素多样性:
用于页面检测与识别的标注总数超过 100,000 条。
细粒度标注属性分布:
文本属性
表格属性
分析上述数据可见,OmniDocBench 数据集确实保证了全面性:
结构化层级清晰:15 种块级(Block-level)+ 4 种跨度级(Span-level)构建了共计 19 种版面元素类别。
长尾与困难样本覆盖明确:包含大比例的复杂背景文本(>2,000 块)、旋转文本(493 块)、含公式表格(81 个)以及合并单元格复杂表格(150 个),确保了评测基准能够对解析模型形成有效的压力测试。
公式标注颗粒度下沉:明确标注了 4,009 个嵌入在正文中的行内公式(LaTeX 表达),避免了仅评测独立行公式而忽略正文混合公式解析的缺陷。
3. OmniDocBench 评估方法
为了给各类模型提供公平且全面的评估,作者提出了一个端到端评估流水线,该流水线由若干模块组成,包括提取、匹配算法以及指标计算。可以参考下图:
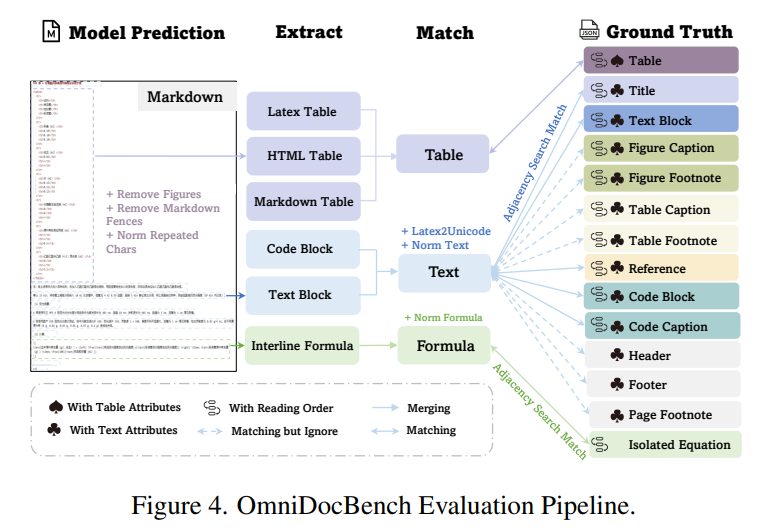
该流程确保了 OmniDocBench 能够对文档解析任务自动执行统一标准的评估,从而产生可靠且有效的结果。
3.1 提取流程
先对模型生成的 Markdown 文本进行预处理,包括:
移除图像标签;
去除文档开头的 Markdown 标签;
对重复字符的数量进行标准化处理。
元素提取主要采用正则表达式匹配。为确保各元素的提取过程互不干扰,必须遵循特定的提取次序。具体提取顺序为:
LaTeX 表格;
HTML 表格;
独立行公式;
Markdown 表格(提取后统一转换为 HTML 格式);
代码块。
在提取出上述特殊组件后,剩余内容均视为纯文本。
段落切分规则:优先使用双换行符(\n\n)进行段落切分,以使其能够参与后续匹配流程,并与真值(Ground Truth)中的阅读顺序标注单元保持对齐;若不存在双换行符,则采用单换行符(\n)进行分段。
代码块归属:先前提取的代码块被合并到文本类别中一并处理。
作者将段落中的行内公式统一转换为 Unicode 格式。这一处理的原因在于不同模型输出行内公式的格式不一致(例如部分模型输出 LaTeX 语法,部分直接输出 Unicode 符号)。对于原生采用 Unicode 编写的公式,难以通过正则表达式完整提取。因此,为了确保对比的公平性,不对行内公式进行单独抽离评估,而是将其转换为 Unicode 格式后,与所在的文本段落一同参与评估。
提取完成后,系统会记录各提取内容在原始 Markdown 文本中的起始与结束字符位置,以供后续计算阅读顺序指标使用。
3.2 匹配算法
为了避免段落切分差异对最终评测结果产生干扰,作者提出了邻接搜索匹配,该方法在真值与预测结果中同时进行段落的合并与拆分,以实现可能的最佳匹配。
具体策略包括:
步骤一(阈值匹配):计算预测结果与真值之间的归一化编辑距离矩阵。若预测块与真值块的相似度超过特定设定阈值,则直接判定为成功匹配。
步骤二(子集检测与邻接贪心合并):对于剩余未成功匹配的文本块,应用模糊匹配判断一个字符串是否为另一个字符串的子集:
若构成子集关系,则进一步启用合并算法,尝试将相邻段落进行合并;
该过程持续合并更多相邻段落,直到归一化编辑距离对应的相似度开始下降为止(即寻找到局部最优的合并边界);
经此流程后,即可为预测块与真值块确定最佳匹配对。
此外,作者针对 PDF 页面内容中的特定组件引入了忽略逻辑,即这些组件参与文本匹配对齐,但被排除在最终指标计算之外。这主要是因为不同模型对这些组件的输出标准存在不一致,这种标准差异不应影响评估结果。
忽略处理机制对照表:
3.3 评估指标计算
纯文本:计算归一化编辑距离,并在样本级别对这些指标进行平均,以获得最终得分。
表格:在计算基于树编辑距离的相似度(Tree-Edit-Distance-based Similarity, TEDS)和归一化编辑距离之前,所有表格均统一转换为 HTML 格式。
公式:公式目前采用字符检测匹配指标(Character Detection Matching, CDM)、归一化编辑距离以及 BLEU 进行评估。
阅读顺序:阅读顺序以归一化编辑距离作为评估指标。该计算仅涉及文本组件,表格、图像以及前文所述的被忽略组件均被排除在最终阅读顺序计算之外。
最后,作者在流水线工具(如 MinerU )、专用文档解析 VLM (如 Nougat )、通用 VLM (如 GPT-4o)三大类模型上,应用 omniDocBench 做了详细的评估测试。由于本文的重点是在 omniDocBench 的提出上,因此对实验结果不做详细介绍。具体实验结果请读者参见原文。
4. 结论
针对文档解析研究中缺乏多样化且贴近实际的基准这一问题,作者提出了 OmniDocBench —— 一个涵盖多种页面类型、具备全面标注的数据集,并配备了灵活且可靠的评估框架。OmniDocBench 能够对文档解析方法进行系统且公平的评估,为推动该领域的发展提供关键见解。其特定任务评估与属性层级评估有助于开展针对性的模型优化,推动构建更加稳健和有效的解析解决方案。