

今天研读《olmOCR: Unlocking Trillions of Tokens in PDFs with Vision Language Models》
开源实现:olmOCR
1. 为什么要提出 olmOCR ?
高质量的文本数据对于语言模型而言非常重要:
模型训练阶段:语言模型开发需要基于海量文档的数万亿 token 进行训练。若提取和表示的内容包含噪声或保真度低,会导致训练不稳定并削弱下游性能。
模型推理阶段:语言模型需利用纯文本格式的文档上下文来辅助用户提示(例如信息提取或阅读辅助)。低质量的源文档表征会引发级联错误。
虽然互联网上存在大量的文本资源,不过 PDF 等电子文档格式却存在如下难点:
物理渲染导向:PDF、PS、DjVu 以及 DOC、ODT、RTF 等格式旨在保证固定尺寸物理页面的视觉渲染,而不是保留逻辑文本结构。
语义单元缺失:PDF 格式最初用于规范数字文档在实体纸张上的打印方式,底层存储的是单字符及其坐标、间距和视觉元数据,而非标题、段落等语义段落单元。
缺乏阅读顺序:这类格式缺少连贯文本所需的基础信息(例如真实的阅读顺序),导致存量庞大的文档难以整合至语言模型流程中。
当时已有的文本提取技术路线对比:
流水线系统:将章节分割、表格解析等多个机器学习组件串联运行(如 MinerU、Marker),部分工具专门针对科学论文开发(如 Grobid、VILA、PaperMage)。该类方案传统上主要侧重于内容的准确提取。
端到端模型:使用单一模型接收 PDF 页面图像并输出纯文本(如 Nougat、GOT Theory 2.0)。这类模型推动了多栏排版、浮动图表、页眉、脚注等复杂布局内容的线性化处理(将内容按逻辑阅读顺序展平)。
专有闭源模型:先进的专有模型在端到端文本提取上具备较强能力,但调用成本高(例如使用 GPT-4o 转换百万页 PDF 需花费超过 6,200 美元)。
因此,作者提出了 olmOCR ,这是一个通用的内容提取与线性化工具包,用于将 PDF 或文档图像转换为适用于语言模型开发的干净纯文本。主要贡献如下所述:
训练数据(olmOCR-mix-0225)
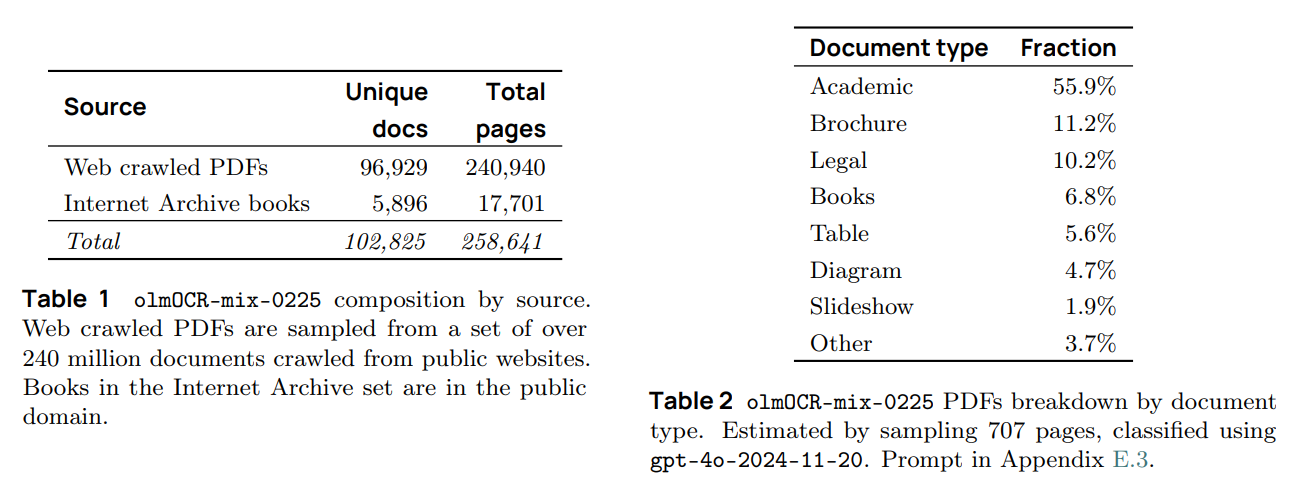
规模与来源:包含 260,000 页抓取的公开 PDF 页面及其对应的 GPT-4o OCR 输出,用于训练模型。
覆盖领域:涵盖学术论文、公有领域图书、法律文件、宣传册等多种类型。
评测基准(olmOCR-Bench)
评测机制:采用类似软件单元测试的简单二元规则,无需依赖模糊的参考标准匹配或 LLM-as-judge 。
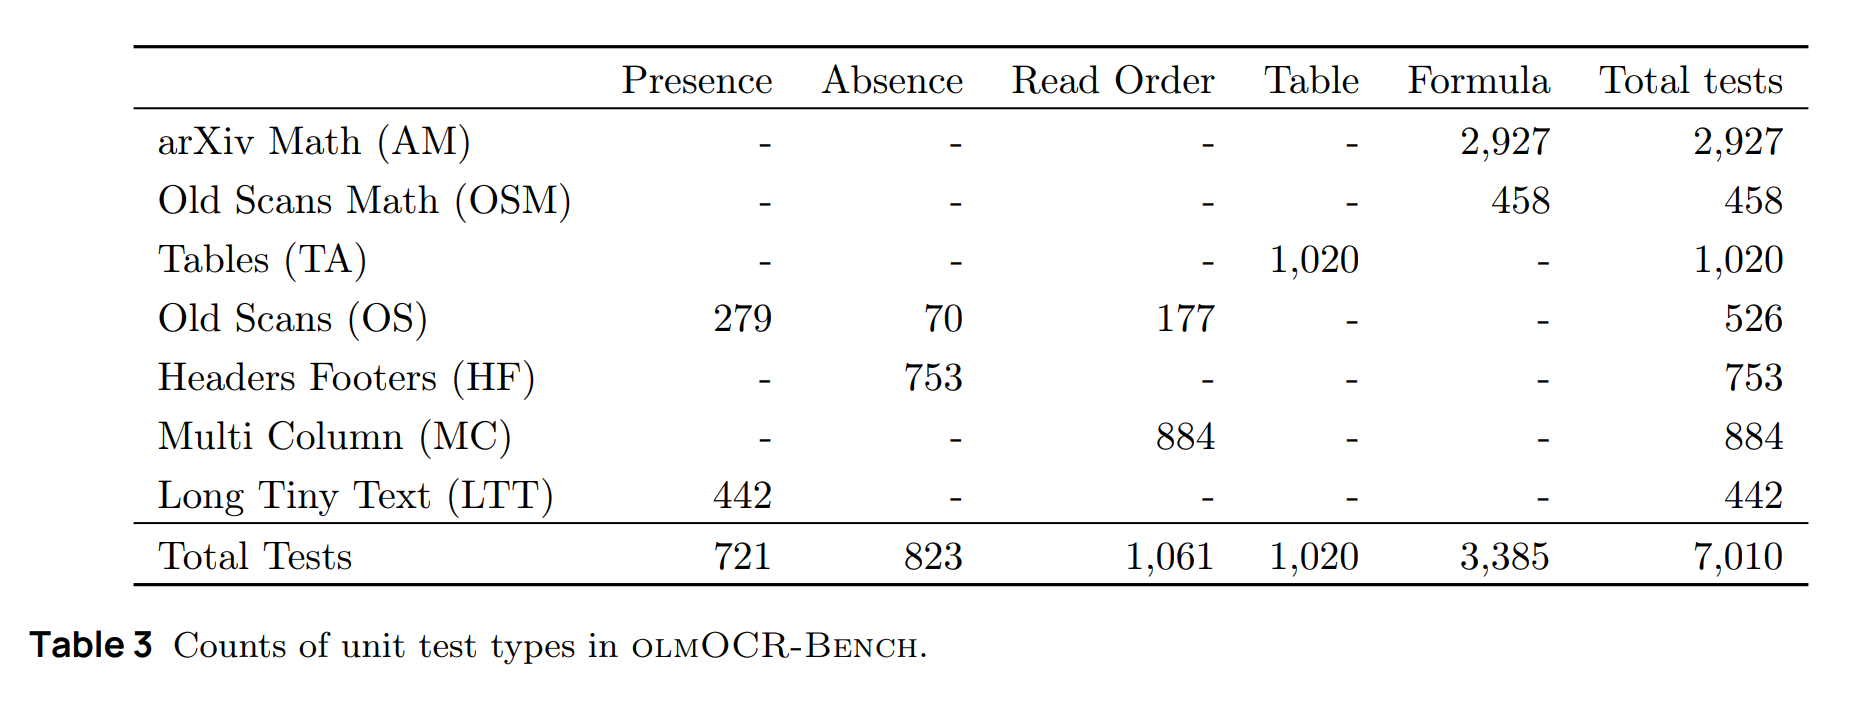
测试规模:覆盖 1,400 页 PDF,包含跨多种文档类型的 7,000 多个单元测试用例。
模型与代码(olmOCR-7B-0225-preview 与 Python 工具包)
模型微调:基于 Qwen2-VL-7B-Instruct 在 olmOCR-mix-0225 数据集上微调得到。
架构与扩展:封装为 Python 工具包,支持 SGLang 和 vLLM 推理引擎,可扩展适配单卡至数百张 GPU 的集群配置。
性能与成本:在评测基准上优于 Qwen-2.5-VL-7B;处理每百万页 PDF 的成本低于 176 美元。
下游实际应用(olmOCR-peS2o)
语料构建:使用 olmOCR 处理了语言模型预训练常用的 peS2o 数据集中的 790 万份原始科学文献 PDF,构建了 olmOCR-peS2o 数据集。
预训练效果:使用 olmOCR-peS2o 训练语言模型,在下游基准测试中观察到了性能提升。
2. 构建 olmOCR-mix 数据集并在其上训练模型
2.1 PDF 数据的来源与预处理
数据来源
网络抓取文档:从包含 2.4 亿份公开互联网抓取 PDF 的内部数据集中随机抽样,该部分多为原生数字文档。
公共领域图书:来源于 Internet Archive 的公有领域图书 PDF,该部分主要由图像扫描件组成。
数据过滤与清洗规则
语言过滤:使用 Lingua 工具包识别并过滤掉非英文文档。
解析与异常过滤:剔除无法被 pypdf 正常解析的文档。
内容与格式过滤:剔除包含垃圾信息关键词的文档、可填写的表单,以及文本内容过短的文档。
页面采样策略
从通过上述过滤条件的每份 PDF 中,以均匀随机抽样的方式抽取最多 3 页。
数据集的具体分布情况整理于下表之中。
2.2 提取线性化纯文本
方案选择
传统标注的局限:人工标注成本过高且容易出错;基于 PDF 内部数据提取的现有工具无法处理文档图像,且由于启发式规则脆弱,提取误差较大,无法提供可靠的真值标签。
方案确立:采用 GPT-4o 将 PDF 页面转换为线性化纯文本,以此构建模型训练所需的监督目标。
原生 GPT-4o 的缺陷与文档锚定策略
独立生成的不足:在面对高密度页面或复杂版面时,GPT-4o 容易出现内容遗漏、非忠实于原文的重写或补全,以及在未收到指令时擅自为图像生成描述。
文档锚定机制:在 PDF 页面光栅图像这一视觉输入的基础上,补充从页面提取出的文本块和位置信息,以此辅助引导 GPT-4o 的生成过程。
文本信息提取与提示词采样
提取方式与数据特征:利用 pypdf 库从 PDF 内部数据中提取页面结构表征。该表征包含较多噪声,既未保留阅读顺序,正文也与模板文本及渲染相关的人工残留交织在一起。
采样规则:从提取出的长内容中采样文本块加入提示词,直至达到最大输入长度上限;在采样时,优先选取位于文档开头和结尾处的文本块与图像。
结构化输出规范与效果验证
先元数据后正文:要求 GPT-4o 输出结构化的 JSON 格式。强制模型在按自然阅读顺序生成页面正文之前,必须先提取页面元数据(如语种、页面朝向、是否存在表格等)。
作用与价值:除提升输出处理效率外,该设计能避免模型在页面不存在文本时为图像生成描述。
评测表现:基准测试(olmOCR-Bench)数据表明,文档锚定方法改善了 GPT-4o 的输出质量。
2.3 模型微调
本节用于验证规模较小、经过专门微调的 VLM 是否能达到大型通用模型配合优化提示词的效果。
基础模型与训练超参数
模型与数据:以 Qwen2-VL-7B-Instruct 为基础模型,在 olmOCR-mix-0225 数据集上进行微调,产出 olmOCR-7B-0225-preview。
开发框架:基于 Hugging Face 的 transformers 库实现。
训练参数:
有效批次大小:4
学习率:1e-6
优化器:AdamW
学习率调度:余弦退火策略,训练 10,000 步(约合 1.2 个 epoch)
硬件配置与算力开销
硬件环境:单节点配备 8 张 NVIDIA H100(80GB)GPU。
耗时统计:单次训练耗时 16 个节点小时(node hours);包含所有试验在内的总训练计算量为 365 个节点小时。
输入处理与提示词调整
图像尺寸缩放:在微调阶段改动了文档锚定提示词(删减部分指令),并将图像缩放至最长边不超过 1024 像素。
Token 长度与构成:
提示词字符数上限为 6,000 字符。
典型输入 token 分布:页面图像约占 1,000 tokens,锚定文本约占 1,800 tokens,整体输入约 3,000 tokens。
训练样本最大截断长度设为 8,192 tokens,以适配偶发的大提示词场景。
损失计算与输出格式
损失掩码:实施了 Loss 掩码处理,仅计算最终生成回复(Response)部分的损失,不计算输入提示词的损失。
输出规范:延续了 olmOCR-mix-0225 中定义的结构化 JSON 输出格式。
3. olmOCR-Bench 基准测试
olmOCR-Bench 是一个用于测试 PDF 内容提取质量的基准测试。
评测机制与设计特点
单元测试形式:olmOCR-Bench 采用预定义的“通过/失败”(pass-or-fail)单元测试来评估提取性能。测试逻辑为:输入完整的 PDF,检验其输出的纯文本是否满足特定属性或包含特定元素。
确定性验证:每个测试用例均具备简单、明确以及可通过机器程序进行确定性验证的特点。
规避传统评测方法的缺陷
规避模型自评偏差:不采用基于大模型的评估器,避免评测模型对自身生成结果产生偏好偏差。
规避软性指标局限:不使用与参考文本比对的软性指标(如编辑距离、ROUGE)。这类指标难以反映细粒度但语义关键的提取错误(例如数学公式中 xi 与 xi 的混淆)。
数据规模与测试类型
基准规模:包含来自多样化来源的 1,402 份独立 PDF 文档,涵盖 7,010 个独立的测试用例。
测试覆盖维度:
通用测试模式:适用于所有文档类型的通用属性(如元素存在性、缺失性、阅读顺序)。
专项测试模式:针对难度较高且重要的特定提取目标(如表格、数学公式)。
详细信息参见下表:
3.1 单元测试种类
在执行上述所有文本比对前,基准测试会对提取文本进行标准化处理:
将换行符转义表达统一转换为实际换行符。
将所有空白字符归一化为单个 ASCII 空格。
移除 Markdown 中的粗体与斜体标记。
将各类引号和连字符统一归一化为标准 ASCII 字符。
将所有 Unicode 字符串转换为 NFC 规范格式。
3.2 基准测试的数据来源与构建
测试数据的预处理规则要求:
隐私过滤:移除了包含个人可身份识别信息且非公开发布的文档。
数据去重:通过 URL 级别去重,确保基准测试文档与训练集 olmOCR-mix-0225 不发生重叠与污染。
7 类评测文档构建与测试用例生成方式:
3.3 打分机制
评分机制与通过率统计
测试形式:各工具与模型处理 PDF 页面并输出 Markdown 或纯文本。所有测试用例均为 Pass/Fail 二元判定,评测指标统计为测试通过率(百分比)。
单类目得分:针对每个测试文档来源(包含默认的 Baseline 基础测试),分别计算该来源下所有测试用例的通过率百分比。
最终总分为各文档来源通过率的宏平均:
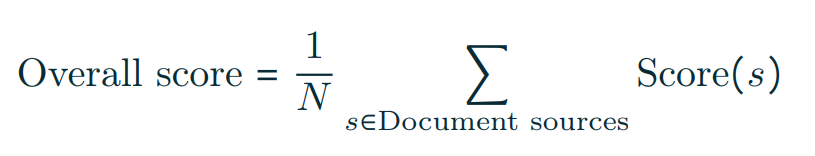
N:测试文档来源类别的总数。
s:特定的文档来源类别。
Score(s):该文档来源类别 s 的测试通过率。
权重设计考量
平衡样本规模差异:各类别在获取和人工验证测试用例时难度不同,导致各数据源的用例数量存在差异。采用宏平均方式计算平均值,可避免用例数量较多的类别主导最终得分。
均衡评估核心能力:确保各个文档来源所代表的特定 OCR 能力在最终评估中均具备同等的权重考量。
4. olmOCR 模型的评估
首先,作者在 olmOCR-Bench 上评估 olmOCR,并与一系列现有的文档线性化工具以及视觉语言模型进行横向对比;然后,作者使用 olmOCR 提取并线性化的文本内容,在 OLMo 2 checkpoint 上进行继续预训练,以量化其对语言建模的实际效果。
4.1 在 olmOCR-Bench 上的评估结果
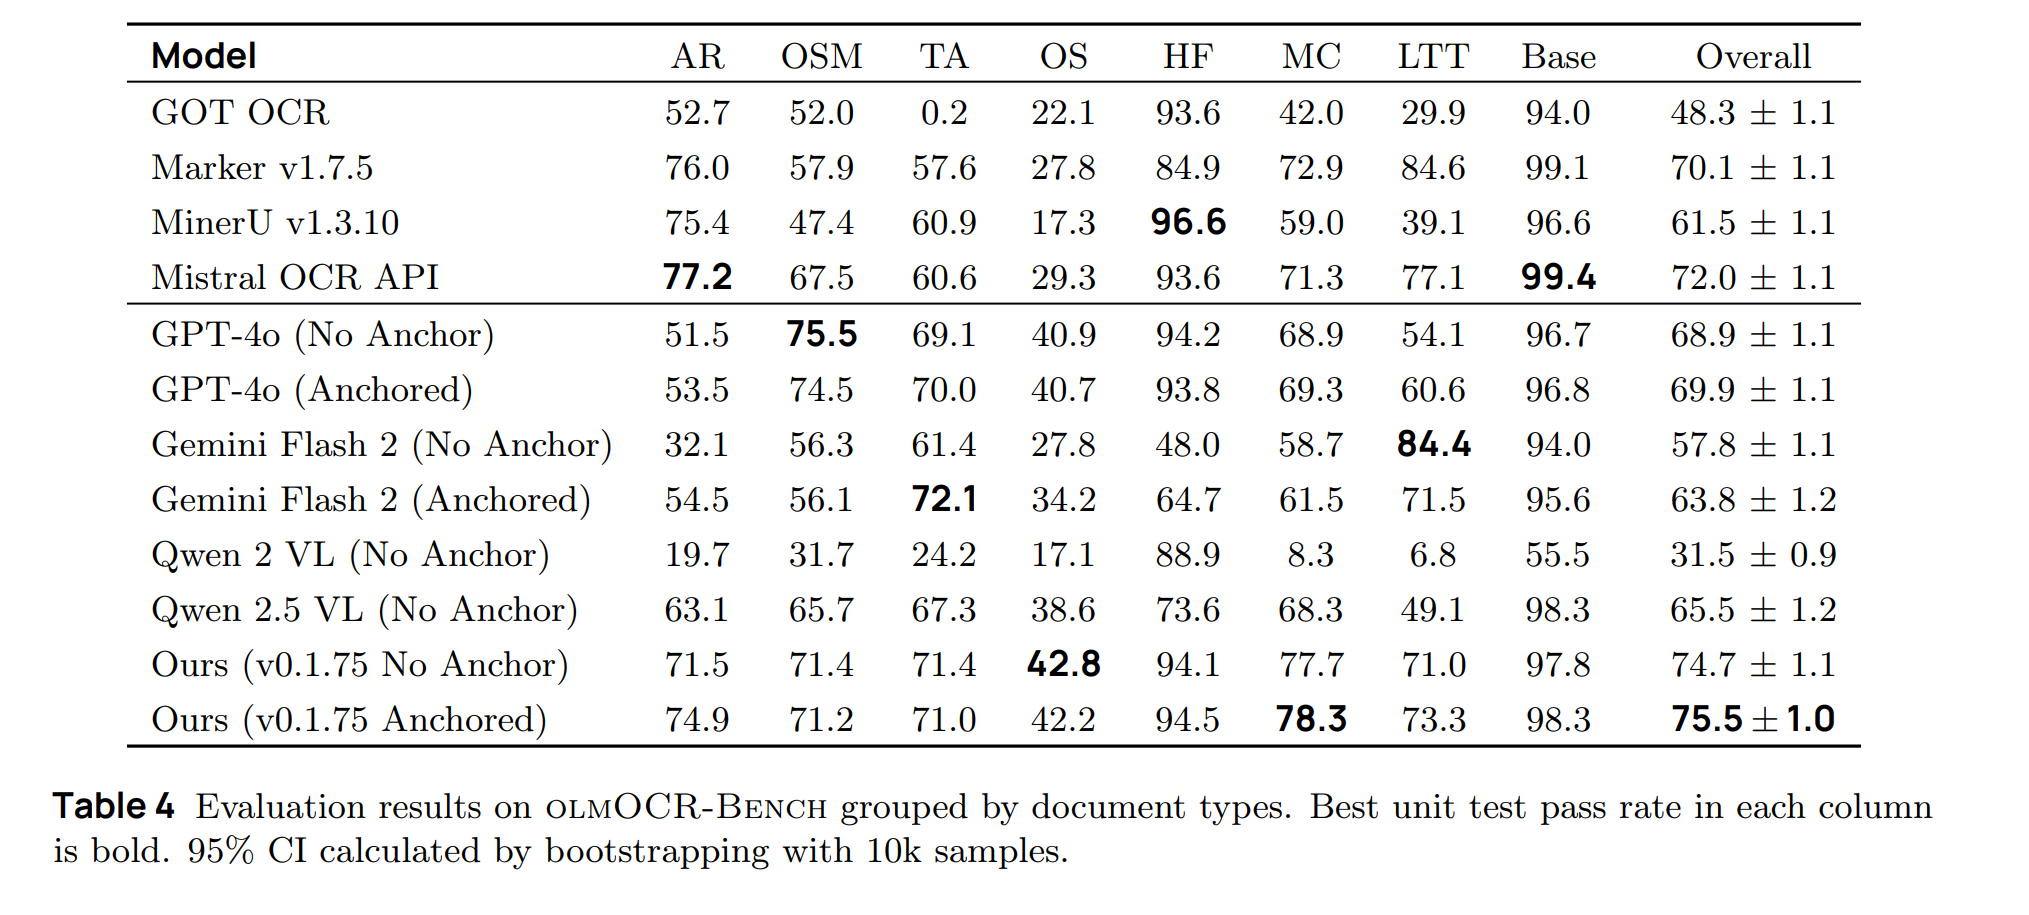
实验结果:
模型对比表现:olmOCR 的表现优于顶尖的商业专用 OCR 工具(Mistral)、其教师模型 GPT-4o,以及基础模型的后续升级版本 Qwen 2.5 VL(olmOCR-7B-0225-preview 的基础模型为 Qwen 2 VL)。
基准构建时序与防过拟合:olmOCR-Bench 是在完成 olmOCR-7B-0225-preview 模型训练之后才设计构建的,以避免在与其他系统进行横向对比前,针对评测集进行不公平的迭代调优。
定性文本质量:定性分析表明,olmOCR 生成的纯文本比现有的专用开源工具更为干净。
这个对比实验揭露的是:olmOCR 模型在 olmOCR-Bench 基准测试上,拥有良好的得分。
4.2 在下游任务上的评估
下游评估实验设计
评估目的:通过继续预训练检验 PDF 线性化质量对语言模型能力的实际影响。
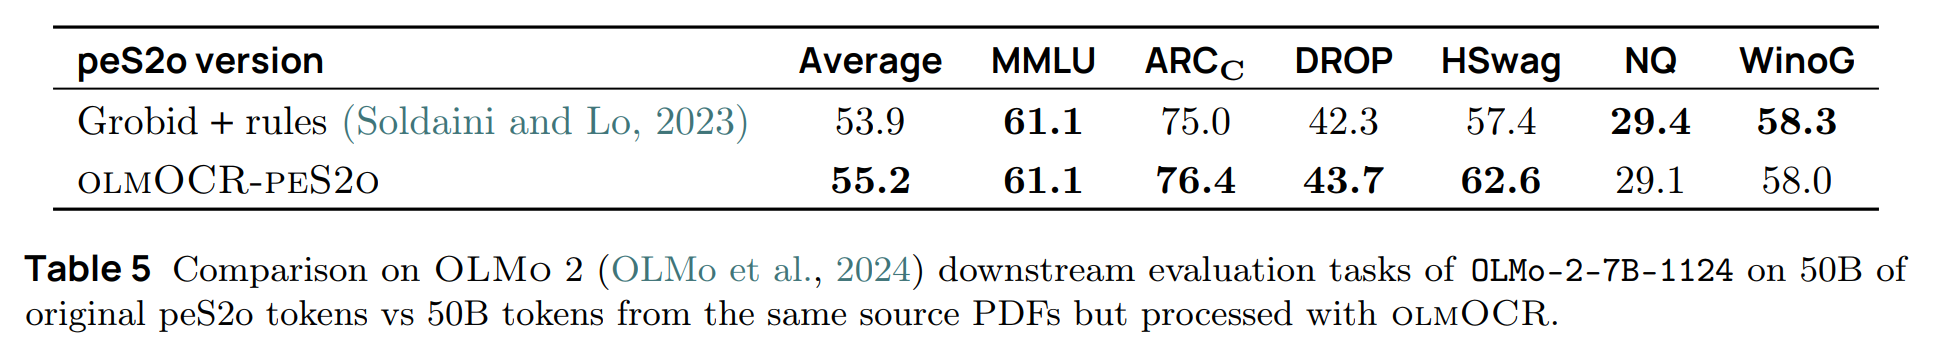
消融方法:固定相同的源 PDF 文档集合,仅改变文档线性化提取工具,以此对比输入文本质量对模型性能的差异。实验基于 OLMo-2-1124-7B 的中间 checkpoint 进行。
对照组设置
基线数据集(Baseline: peS2o):使用从 S2ORC 论文集中提取的 580 亿(58B)token 学术文献数据。该数据原始方案采用 Grobid 进行提取,并结合启发式规则进行清洗。
olmOCR 提取版本:匹配并获取 peS2o 中相同学术论文的原始 PDF,使用 olmOCR 工具链重新进行解析与线性化处理。
预训练配置与训练规模
针对两种不同提取方式处理得到的 peS2o 数据,分别载入 7B 中间检查点继续预训练 500 亿(50B)个 token。
下表展示了实验结果:
结果分析:
性能表现:使用 olmOCR 提取的数据替代原始 Grobid + 规则提取的数据后,语言模型在多项主流基准任务上的平均得分提升了 1.3 个百分点。
覆盖基准:评估涵盖 MMLU、ARCC、DROP、HellaSwag、NaturalQuestions 以及 WinoGrande。
这个对比实验揭露的是:olmOCR 模型可以通过更优秀的 PDF 线性化方案,来更好地“赋能”已有语言模型。
4.3 开销评估
在实际应用场景中,成本效益与模型性能具备同等的重要性。论文在下表中汇总了推理成本分析。
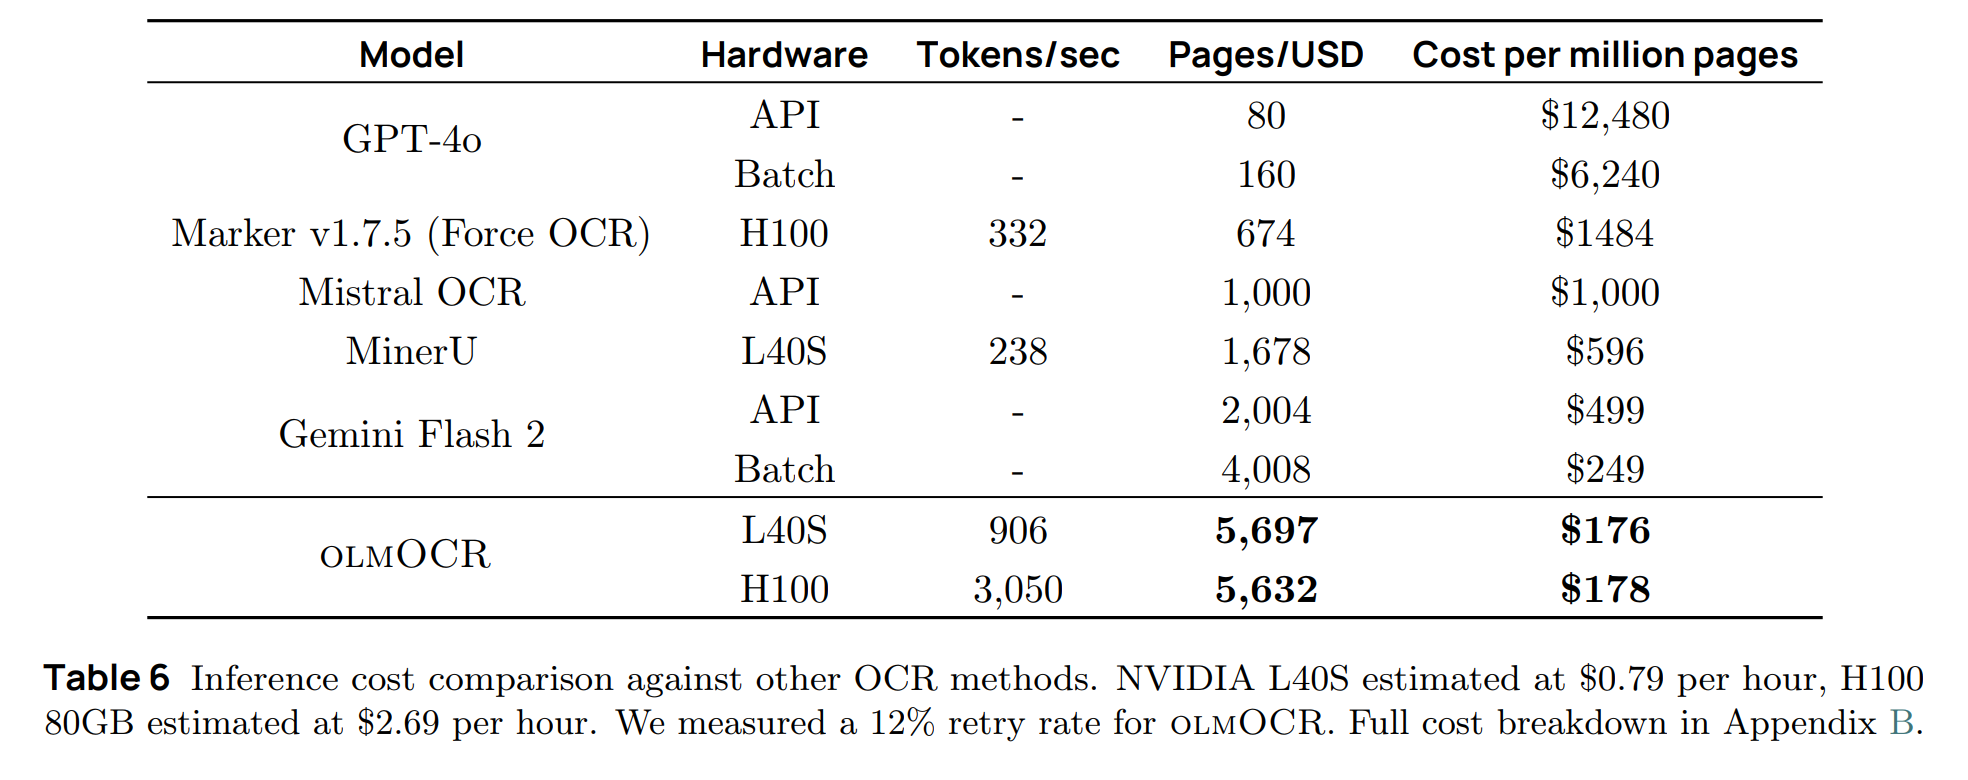
可以看到,olmOCR 的推理成本明显降低。
5. 结论
在这项研究中,作者推出了 olmOCR,一个用于将 PDF 文档转换为干净纯文本的开源工具包。作者将文档锚定(document-anchoring,一种利用原生数字 PDF 中可用元数据的新型提示技术)与微调后的 7B 参数视觉语言模型相结合,以较低的成本比例取得了可与闭源商业方案相媲美的效果。与此同时,作者公开发布了训练集 olmOCR-mix-0225 ,以支持各方进一步开发各自的视觉语言模型。
为了对系统进行严格评估,作者构建了 olmOCR-Bench ,这是一个涵盖 1,403 份 PDF、包含 7,010 个测试用例的评测基准。它包含了针对文本存在性、阅读顺序、表格、公式以及基线功能的 Pass/Fail 单元测试。测试文档涵盖从科学论文到历史手稿等多种类别,能够针对多样化的线性化与上下文提取挑战展开稳健的评估。此外,作者发布的高效推理流水线包含了从单份文档到数百万页 PDF 档案转换所需的全部组件。这为高质量 PDF 文档中的数据发掘提供了工程基础。