

今天研读《Nougat: Neural Optical Understanding for Academic Documents》
开源实现:Nougat
1. 为什么要引入 Nougat ?
PDF 是互联网上仅次于 HTML 的第二大主流文档格式,也是书籍与学术期刊最常用的存储形式。然而,PDF 文件极难高质量转换为其他格式。对于高度专业化的科学研究论文,其数学表达式的语义信息在传统提取过程中几乎完全丢失。
传统 OCR 引擎(如 Tesseract OCR)采用逐行识别机制,擅长单字和单词的检测分类,但无法理解字符之间的相对空间关系。因此,在面对数学公式时,传统 OCR 引擎经常将上下标与普通文本同等对待,破坏了分数、指数、矩阵等强依赖字符相对位置的数学结构。
此外,现有学术文本语料库(如 S2ORC 数据集)虽然通过 GROBID 提取了 1200 万篇论文的文本内容,但严重缺失数学公式的有意义表示。
因此,为了让数百万篇被锁在不可读格式中的论文实现机器可读,从而提升整体科学知识的可访问性与可检索性,作者提出了 Nougat 方案。它通过构建一个基于 Transformer 的端到端模型,直接将文档页面图像转换为格式化标记文本。
2. Nougat 建模
2.1 基本概述
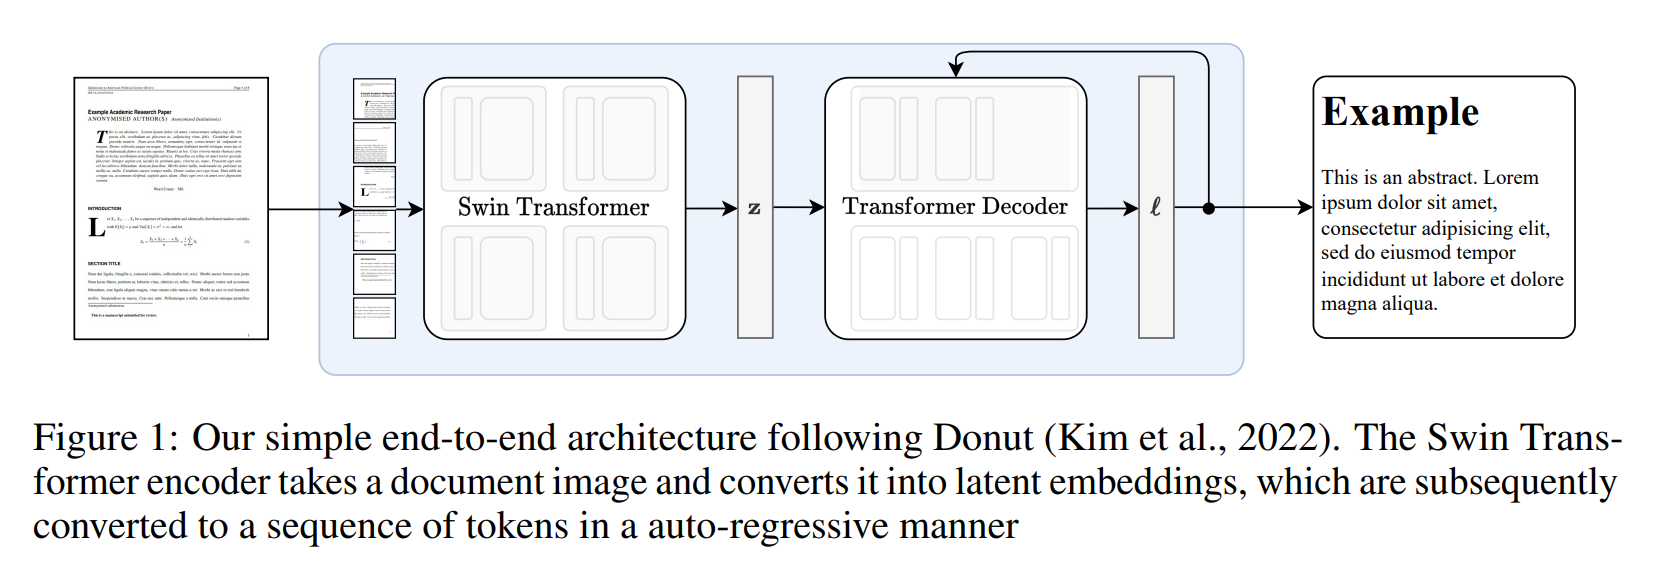
Nougat 采用了经典的 Encoder-Decoder Transformer 架构进行端到端训练,其核心设计思想继承自 Donut ,彻底摒弃了传统 OCR 预处理与分词检测模块,由神经网络隐式完成文本与公式的识别。
换言之,Nougat 模型无需外部 OCR 引擎、文字边界框检测或字符级标注输入,完全依靠视觉特征编码与跨模态注意力机制隐式提取文本内容与排版语义,从而直接实现「页面图像 -> 结构化文本」的端到端映射。
视觉编码器(Visual Encoder)
图像预处理流水线:
输入:原始文档图像 x ∈ ℝ3×H0×W0
裁剪与缩放:自动裁剪页边空白,缩放至固定的标准矩形尺寸 (H, W)
尺寸对齐:若图像小于目标尺寸,则追加填充(Padding),确保送入网络的张量维度完全一致。
骨干网络(Swin Transformer):
采用 Swin Transformer(一种分层视觉 Transformer)。
将图像划分为固定大小且不重叠的窗口,通过一系列局部自注意力与跨窗口注意力层逐步聚合全局多尺度上下文。
输出表征:输出 Patch Embedding 序列 z ∈ ℝd×N,其中 d 为隐层特征维度,N 为 Patch 数量。
文本解码器(Decoder)与分词
自回归解码机制:
采用 mBART 解码器架构。
在生成每个 Token 时,通过 Self-Attention 聚合已生成的上下文 Token,通过 Cross-Attention 动态聚焦视觉编码器输出的图像 Patch 表征 z 。
最后一层线性投影到词表维度 v ,生成预测 Logits ℓ ∈ ℝv 。
Tokenizer 的选型:
复用 Galactica 的分词器。
原因:该分词器专为科学文献语料优化,对 LaTeX 数学符号、特殊字符、变量名及化学/物理专业术语有极佳的切分与表征能力。
可以参考下图做大致了解:
2.2 基本配置
图像渲染与输入尺寸设计
渲染分辨率:以 96 DPI 的分辨率将 PDF 页面渲染为图像。
输入维度 (H, W) = (896, 672) 。
适配 Swin Transformer:图像先等比缩放再补充 Padding 对齐至 (896, 672),以适配预训练的 Swin Base 编码器输入限制。
解码器与模型容量对比
论文评估了 Base 与 Small 两种规格的模型,均采用 greedy decoding 进行自回归推理:
训练流程与超参数设置
优化器与周期:采用 AdamW 优化器,在有效批大小(Effective Batch Size)为 192 的配置下训练 3 个 Epoch。
学习率退火策略(应对训练不稳定):
初始学习率:lrinit= 5e-5
衰减机制:每 15 次更新将学习率乘以 0.9996(指数衰减)
最终学习率截断:直到降至最低阈值 lrend = 7.5e-6
2.3 数据增强策略
图像层面的数据增强
核心动机:训练集全为原生电子版 PDF ,缺乏物理纸张扫描时的噪声与几何畸变。为了提升模型对扫描件及复杂版面的泛化能力,需人工合成扫描缺陷。
具体变换类型(基于 Albumentations 库实现,每个算子按固定概率独立触发):
形态学操作:腐蚀、膨胀,用于模拟墨迹扩散或断裂。
噪声与滤波:高斯噪声、高斯模糊。
画质与编码降级:位图转换、图像有损压缩。
非线性几何形变:网格失真、弹性形变,用于模拟页面弯曲与纸张褶皱。
文本目标层面的扰动
操作方法:在训练阶段,对 Decoder 输入的 Ground Truth 文本序列进行随机 Token 替换。
核心收益:大幅缓解了自回归序列生成中常见的重复死循环现象,强迫 Decoder 即使在局部历史上下文受损时也能保持鲁棒性,继续对齐视觉特征。
3. 实验与结果
3.1 数据集
3.1.1 数据集的来源
作者从三个数据源构造实验数据集。
① arXiv:核心高质量配对数据(1,748,201 篇)
规模:爬取了 174.8 万篇开放获取论文的编译 PDF 及其 LaTeX 源码。
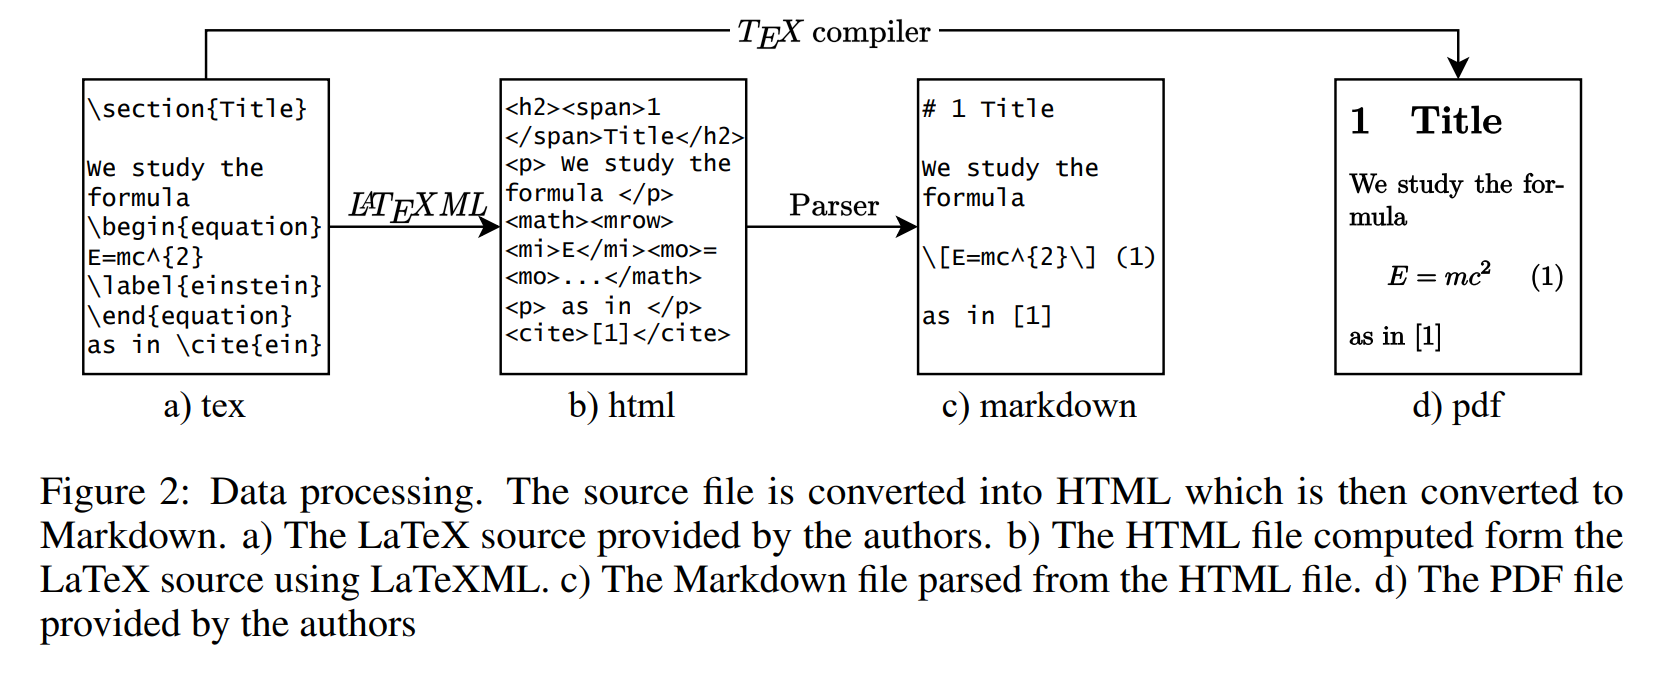
LaTeXML 标准化(关键预处理步骤):
原生 LaTeX 源码存在大量自定义宏和语法模糊性。作者先用 LaTeXML 将 LaTeX 源码转译为 HTML5 文件。
清洗动作:
展开并替换用户自定义宏;
规范化空格与补全可选括号;
归一化表格结构;
将交叉引用和文献引用替换为具体的编号文本。
最终轻量标记格式转换:
将 HTML5 解析为统一的轻量级标记语言,支持:标题层级、粗体/斜体、算法伪代码、行内/行间 LaTeX 数学公式以及 LaTeX 格式表格。
对 arXiv 数据的处理流水线可参考以下示意图:
② PubMed Central (PMC):扩充版面多样性
格式:提供 PDF 及带有语义信息的 XML 文件。
处理:将 XML 解析为与 arXiv 相同的轻量标记语言。
限制与使用阶段(仅用于预训练):
PMC XML 的语义丰富度参差不齐,公式与表格经常直接被存为位图图像,且难以自动化检测与过滤。
因此大幅减少了 PMC 数据占比,并严格限制仅在预训练阶段使用。
③ Industry Documents Library (IDL):强化基础扫描 OCR
来源:加州大学旧金山分校(UCSF)图书馆维护的公共卫生相关工业文档,采用 OCR-IDL 提取的高质量 OCR 纯文本。
作用(仅用于预训练):该数据不包含任何排版格式,仅用于在预训练阶段教会模型对扫描文档的基本字符级 OCR 识别能力。
下面进行了详细对比:
3.1.2 页面划分
Nougat 的输入是单页文档图像,输出是对应单页的 Markdown 标记文本。但在页面划分的时候存在以下难点:
LaTeX 编译器在排版时会自动决定分页断点,源码本身没有显式的单页标记。
重新编译所有论文的源码开销巨大,必须通过启发式文本匹配将完整源码切分成单页切片。
浮动体漂移:图和表在 PDF 渲染时往往发生跨页漂移,其在 PDF 上的实际物理位置与在源码中的代码顺序不一致。
作者采用以下四步来进行页面划分的处理:
提取并剥离浮动图表:
使用 pdffigures2 工具从 PDF 中识别并定位所有图片和表格元素,将其从正文流中暂时剔除,避免浮动位置混乱干扰主体正文的文本匹配。
文本规范化与单页切分:
使用 pylatexenc 库将 PDF 提取文本中的 Unicode 特殊字符替换为等价的 LaTeX 命令,消除字符编码差异带来的匹配误差。
将 PDF 单页提取的文本与整篇源码正文进行模糊比对,确定每页的起始与终止断点。
图表标题匹配:
将 pdffigures2 识别出的图表描述信息(Captions)与 XML 源码中的图表描述信息进行比对,基于编辑距离(Levenshtein distance)计算相似度,绑定图表对象。
图表回填与配对生成:
页面文本切分完成后,将该页识别出的图表与其对应源码重新插入到该页文本末尾。
将 PDF 页面栅格化为图像,与该页生成的轻量级 Markdown 文本组合,得到最终的「图像-标记」成对训练样本。
显然,上述算法的重点在于,如何精准找到每一页 PDF 对应的起止截断点。作者提出了一个“粗粒度段落分类 + 基尼不纯度边界优化 + 细粒度模糊匹配”的两阶段切分流水线。
粗粒度切分
由于直接逐字全局搜索极其耗时且容易陷入局部最优,作者先在段落级别定位每页的大致起止边界。
1. 特征与分类器构建:
使用 MuPDF 提取 PDF 单页文本行,预处理剔除页码、页眉和页脚。
采用 TF-IDF 词袋模型(Bag of Words) 构建特征,并训练一个线性支持向量机(Linear SVM),以页码作为分类标签。
将整篇 LaTeX 源码按段落切分,利用训练好的 SVM 预测每个段落所属的页码。
2. 基于基尼不纯度的阶梯边界拟合:
理想状态:段落预测页码序列应呈现单调递增的“阶梯函数”。
实际情况:分类信号存在噪声与偶发误判。
优化算法:借鉴决策树的分裂逻辑,在段落索引区间 [a, b] 内最小化加权基尼不纯度(Gini Impurity):
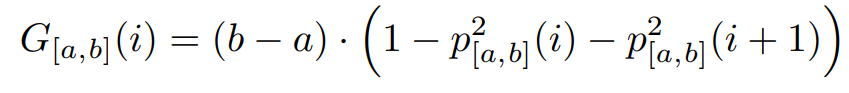
其中 p[a,b](i) 表示在区间 [a, b] 内预测为第 i 页的段落占比。
最优断点选取:寻找使得左右子区间不纯度之和最小的分割点 tˆi :
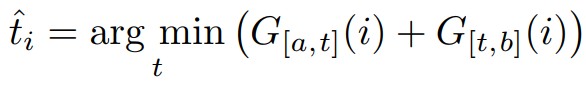
递推搜索:从所有段落出发,确定第 i 页的分割点 tˆi 后,将其作为下一个页面断点搜索的下界 a 逐步向后推进。
细粒度对齐(Fuzzy Matching)
粗切分只能定位到断点落在哪个段落附近,作者进一步在字符/句子级别确定跨页断裂处的具体位置。
1. 局部双向模糊比对:
在预测的断点邻域内,使用 fuzzysearch 库分别比对:
前一页 PDF 文本的末尾几句话;
后一页 PDF 文本的开头几句话。
2. 匹配评分机制:
精准一致:若前后两个方向推导出的切分点完全重合,视为“精确断点”,得分设为 1。
存在偏差:若切分点不完全一致,选取归一化编辑距离最小的位置,得分设为 1 - distance 。
3. 严格的质量过滤门槛:
仅当一页 PDF 的上下两个断点平均得分 ≥0.9 时,该页数据才会被采纳进入训练集。
接受率:经过这一严苛质检,最终约 47% 的页面得以保留。高质量对齐为端到端训练提供了干净的监督信号。
3.1.3 真值数据的噪声
通过自动化流水线构建 Ground Truth 时会引入以下噪声:
LaTeXML 预处理引发的格式伪影(arXiv 数据)
非支持宏包指令残留:LaTeXML 在解析某些未被原生支持的 LaTeX 宏包时,会残留无效命令或产生格式伪影。
小节编号不一致:转译后的 HTML 的小节标题可能会被强制赋予数字编号,即使原 PDF 页面上并未显式进行编号。
图表缺失:因处理管道中的解析或抽取失败,部分原始图表未能成功回填到 Ground Truth 标记中。
源码页面切分算法带来的边界误差
跨页溢出与尾部截断:基于启发式与模糊匹配的切分算法在个别情况下会误包含上一页的末尾文本,或将当前页末尾的单词截断。
格式标记被破坏:切分断点若恰好落在“不可见格式标记”(如粗体、斜体包裹符、章节标题标记)中间,会导致标记语法闭合失败或残损。
PMC 数据源的公式与图表退化
行内公式降级:PMC 文章中的行内数学公式多以 Unicode 或普通斜体文本存储,缺乏结构化 LaTeX 表达。
行间公式与表格丢失:大量行间独立公式及表格在 PMC XML 中存储为位图图像,导致这部分结构在生成标记文本时被忽略。
尽管上述缺陷降低了单条数据的纯度,但作者指出,海量的训练样本规模(170万+ 篇 arXiv 文献)有效稀释了局部微小误差的影响,模型能够在大规模弱监督信号中学习到正确的对齐规律。
3.2 实验评估
3.2.1 评估指标
3.2.2 模态拆分
科学文献的评估不能采用单一的纯文本标准,必须将文档内容解构为普通文本、数学表达式与表格三种独立模态分别评测。
模态拆分评测的原因
各模态信息密度与结构差异大:纯文本重语义连贯性,公式重拓扑结构与符号相对位置,表格重对齐与行列逻辑。
LaTeX 语法的“多对一”映射:相同视觉渲染结果可能对应多种完全不同的 LaTeX 源码写法。字符级比对(如 CER / BLEU)会把语法差异误判为识别错误。
数学公式评测失真的主要来源
符号与命令等价异构:
上下标顺序:$x_1^2$ 与 $x^2_1$ 渲染一致但字符序列不同。
命令互换:\frac{a}{b} 与 {a \over b};\stackrel、\atop、\substack 的混用。
字体与修饰符:\mathbf{x}、\bm{x}、\boldsymbol{x} 等命令功能重叠;\left( 与 \big( 等定界符层级差异。
不可见字符与冗余括号:多余的空字符指令(如 \,、\ )及嵌套花括号 {a} vs a。
行内公式边界的判定歧义:
标点与临近字符究竟属于公式环境内($...$)还是普通文本,缺乏唯一定义。
例如:$\mathrm{H}_{0}$1, 与 H$_{0}1,$ 渲染效果相近,但会同时导致纯文本和数学公式两项的打分下降。
由于上述语法冗余与边界歧义的存在,数学表达式的各项统计匹配得分(CER / BLEU / F1)在理论上预期天然低于普通纯文本,这反映的是源码表示的多样性,而非单纯的视觉识别缺陷。
3.2.3 对比实验
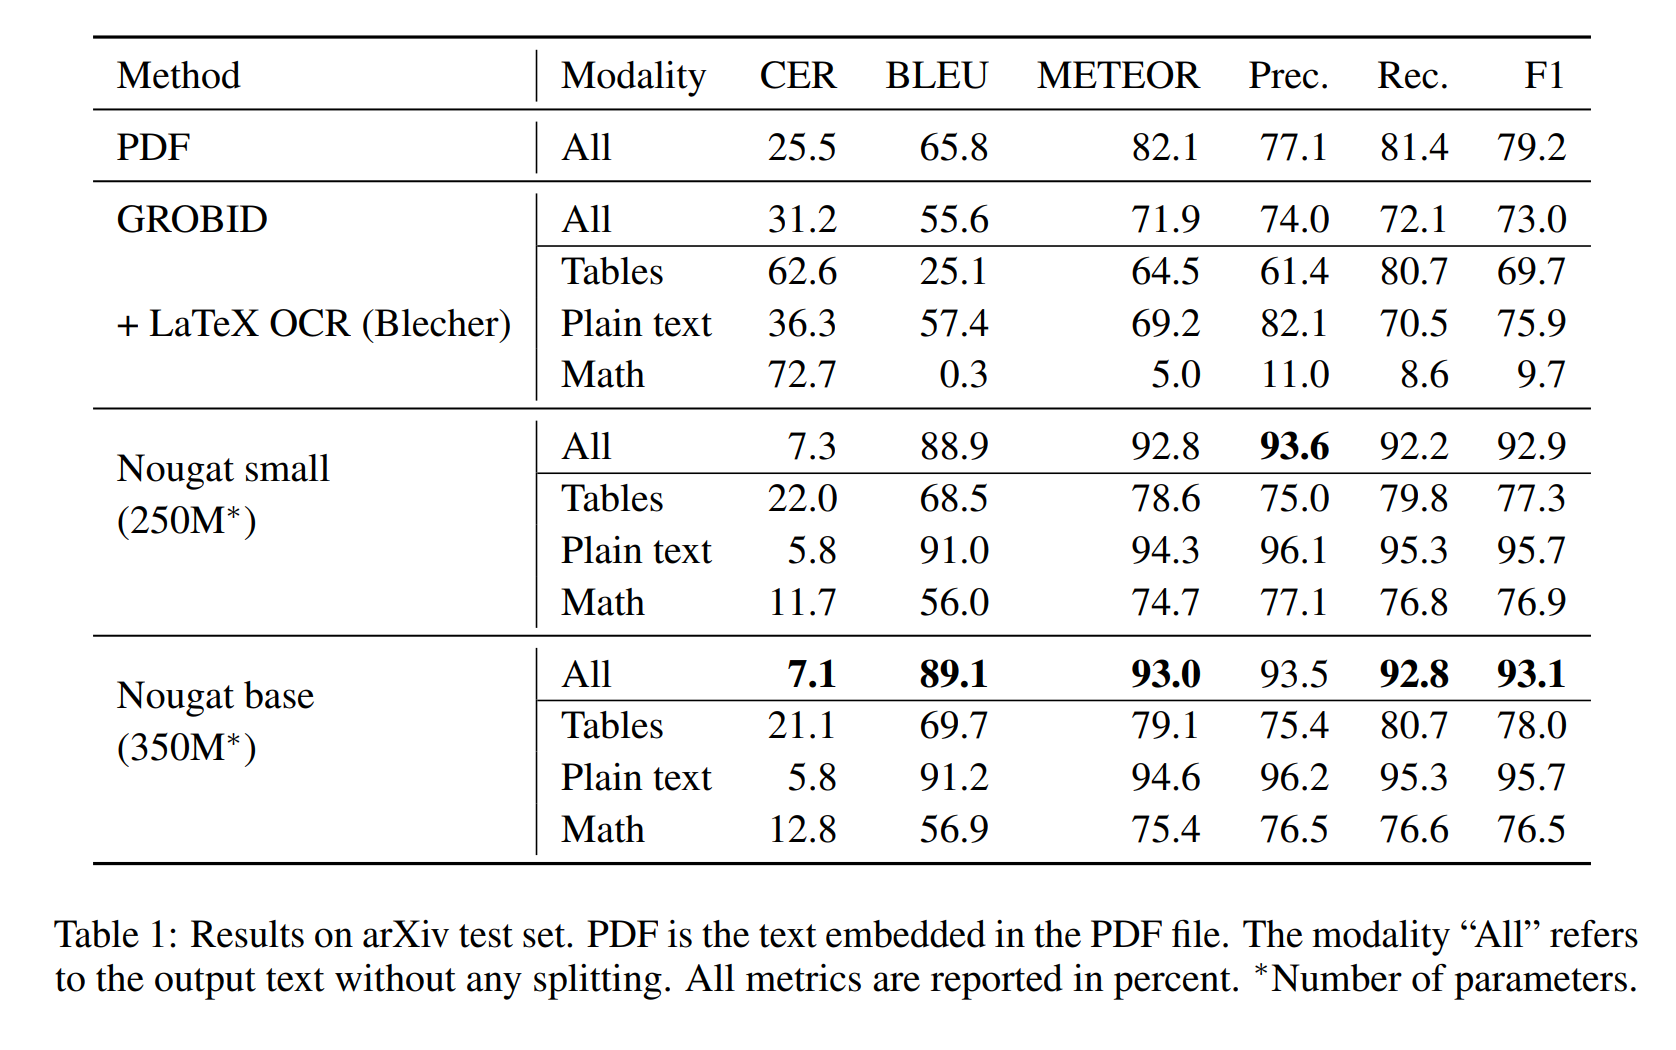
实验结论如下:
1. 各模态表现与误差归因
数学公式:如前文所预测,数学公式与 Ground Truth 的吻合度最低,主因仍是 LaTeX 语法的同义异构和边界歧义。
普通正文:误差主要源于两点:
排版与不可见格式标记的歧义;
行内数学公式边界划分不确定导致的局部文本丢失。
2. 基线方法(GROBID)的改造与局限性分析
为了让基于规则与 CRF 的传统工具 GROBID 具备可比性,作者对其输出进行了工程改造,但也揭示了其架构缺陷:
输出格式转换:将 GROBID 的 XML 输出转换为与 arXiv/PMC 统一的轻量级 Markup 格式。
公式提取与 Unicode 映射:GROBID 提取的是 PDF 内嵌的 Unicode 符号,作者将其自动映射替换为对应的 LaTeX 命令以提升文本相似度。
外挂公式 OCR 增强(LaTeX-OCR):
针对 GROBID 识别出的公式包围框,作者将对应图像区域截取并送入外部开源工具 LaTeX-OCR 进行二次识别。
表现依然糟糕的原因:
漏检率高:GROBID 经常将短小的行内数学表达式误判为普通文本;
边界框漂移:公式包围框定位不准,导致下游 LaTeX-OCR 识别错误。
PDF 原生文本 vs. GROBID:直接从 PDF 提取的嵌入文本在指标上甚至优于 GROBID,因为 GROBID 在论文标题页和参考文献部分的结构化解析上出现了较多格式错乱。
3. Nougat 的实验表现与模型选型结论
全面大幅领先:无论是 Nougat-base(350M) 还是 Nougat-small(250M),在所有模态(正文、公式、表格)和所有评测指标(CER、BLEU、METEOR、F1)上均显著超越基线。
Small 模型性价比极高:Nougat-small 的性能与 Base 模型几乎持平。这表明在 4 层 Decoder 的轻量级参数下,模型已具备充分的跨模态文档结构化解析能力,更利于低成本推理部署。
3.2.4 推理期解码重复现象
作者注意到,模型有时候会在推理阶段发生退化,重复输出相同的内容。在标准测试集中,有 1.5% 的页面出现重复循环;而在在域外文档(Out-of-domain,如扫描版纸质书籍)上,重复退化的发生频率会显著上升。
事实上,Ari Holtzman 等人的研究已证实,在 Transformer 生成模型中,贪心解码(Greedy Decoding)确实容易诱发确定性的重复循环。因此,作者尝试引入核采样以打破死循环。不过,核采样依然易受重复输出的影响,且引入的随机扰动破坏了文档转录的精确性,无法有效抑制句子级重复,因此最终被弃用。
作者指出,他们遇到了三种复杂的重复生成模式:
简单无限循环:最基础的表现形式,即最后一句话或整个段落被无休止地重复生成。
交替变体循环:在两个句子之间来回交替切换,且模型在切换过程中会微调替换个别单词。这导致常规的“严格完全匹配”查重算法直接失效。
自计数重复:最隐蔽、最难检测的模式。常见于参考文献部分,模型在陷入死循环的同时会不断自动累加编号(如自动编造 [1], [2], [3]...),使其形式上看起来符合格式规范。
为了有效解决这个问题,作者引入了抗重复数据增强机制,通过在训练期主动注入噪声,教会 Decoder 在面对局部错误 Token 时具备自愈与继续视觉对齐的能力,而非直接被带偏陷入死循环。
具体流程如下所述:
逐词替换流程:在每个训练样本中,以固定概率随机选取一个 Token,并将其替换为词表中任意随机抽取的另一个 Token。
循环停止条件:持续执行该随机替换采样过程,直到新采样的数值大于预设阈值(论文中设定为 10%)。
实验结果:
无损基础性能:在标准测试指标(CER、BLEU 等)上未观察到性能下降。
死循环显著减少:大幅降低了自回归生成阶段的重复退化概率。
域外数据鲁棒性大幅提升:在容易出现死循环的域外文档上,页面转换失败率下降了 32% 。
此外,由于自回归解码的最大长度上限设定为 S = 4096 ,一旦模型陷入重复死循环,将永远无法生成终止符(EOS Token),这会导致解码一直持续到 4096 步才强制终止。因此,需要设计轻量级判据,实时捕获死循环状态并提前截断生成(Early Stopping)。作者采取了以下监测方案:
提取每个 Token 生成步的最高置信度 Logit ℓi = max ℓ ,模型陷入死循环时,Logits 会呈现异常平稳且高度固化的模式。
算法通过两层嵌套方差计算来捕捉 Logits 的平稳性突变:
第一步:滑动窗口局部方差(VarWin)
设定滑动窗口大小 B = 15,计算局部窗口内的 Logits 方差:
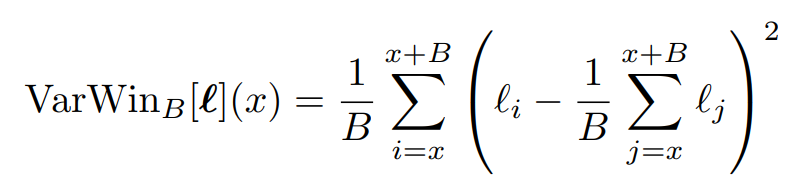
此步骤生成了一个反映局部波动特性的新时序信号。
第二步:序列末尾累计方差(VarEnd)
基于 VarWin 信号,再次计算从位置 x 到序列末尾 S 的方差:
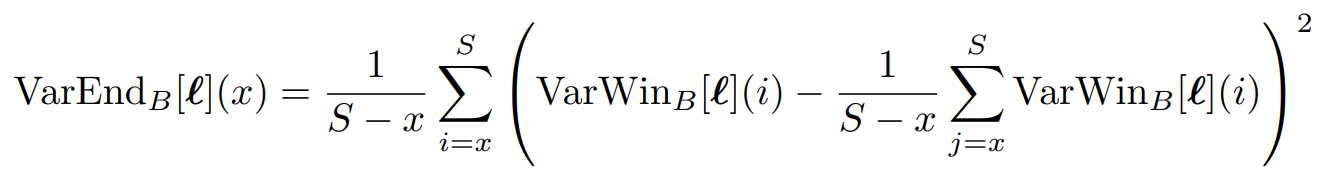
判定判据:若 VarEnd 信号跌破阈值 6.75 ,且在后续序列中持续低于该阈值,则判定该序列已陷入重复崩溃。
最后,完成在线推理早停与后处理复检:
4. 结论与未来展望
4.1 局限性与未来展望
作者指出了 Nougat 在应用范围、语言泛化、推理速度及跨页一致性上的局限性,并明确了后续的研究改进方向:
适用场景与语言泛化限制
重复生成缺陷:自回归死循环仍是限制其可用性的主要瓶颈之一。
领域结构依赖:模型在科研论文上训练,因此对结构相似的学术文档效果最佳(但对其他类型文档仍有一定泛化能力)。
语言与字符集边界:
英语为主:训练集样本几乎全为英文。
拉丁语系表现:在其他拉丁语系文档上表现尚可,但特殊变音字符会被强制替换为最接近的拉丁字母等价字符。
非拉丁语系崩溃:遇到非拉丁语系文字(如中文、日文、阿拉伯文等)会直接触发即时死循环重复。
生成速度与计算开销
硬件基准与吞吐量:在单张 NVIDIA A10G (24GB 显存) 上,可并行处理 6 页。
推理耗时:当单页平均 Token 数约为 1400 时,Base 模型的平均生成时间为 19.5 秒/批次(未进行推理加速优化)。
对比传统工具:相较于 GROBID(处理速度约 10.6 PDF/秒),Nougat 的纯视觉自回归生成速度极慢;但其核心权衡在于不依赖原生电子版 PDF 且具备精准解析数学公式的能力。
跨页断裂与未来工作
单页独立处理的固有弊端:
并行优势 vs 一致性牺牲:为了最大化页面并行处理能力,模型以单页为单位独立训练与推理,完全缺失跨页全局上下文。
跨页冲突:导致整篇文档合并时出现不连贯,最典型的是参考文献引用风格不统一,以及跨页时小节序号跳漏或出现数字幻觉。
核心攻坚挑战:彻底解决自回归模型陷入重复死循环的退化问题。
4.2 结论
作者在这项研究中提出了 Nougat —— 一个基于端到端可训练的 Encoder-Decoder Transformer 模型,用于将文档页面转换为标记语言(Markup)。作者将视觉文档理解领域的最新进展应用于一项全新的 OCR 任务中。与传统方法不同的是,Nougat 既不依赖传统 OCR 引擎,也不依赖 PDF 内嵌的文本表征,而是完全仅依赖栅格化后的文档页面图像。
此外,作者提出了一套自动化数据集生成流程,并成功利用该流程训练了用于科学文献到标记语言转换的模型。它不仅在原生电子版 PDF 的文本提取上展现出巨大潜力,在扫描版论文与教科书的转换方面也同样表现出显著优势。