

在研读 MinerU 工作的时候,发现其版面分析模型基座是 LayoutLMv3 ,对其很感兴趣,遂来研读一二。
论文标题:《LayoutLMv3: Pre-training for Document AIwith Unified Text and Image Masking》
开源实现:LayoutLMv3
1. 为什么要引入 LayoutLMv3 ?以前的研究有什么不足?
近年来,预训练技术在文档理解领域进展显著,能够解析扫描表单、学术论文等各类文档的布局并提取关键信息,其中的代表性方法就是依赖“重构型”目标的自监督预训练。在文本模态上,当时大部分优秀的多模态 Document AI 模型均沿用了 BERT 的 MLM(Masked Language Modeling,掩码语言模型),即根据上下文预测随机掩码 Token 的原始词表 ID。然而,它们在图像侧的预训练目标存在明显差异和局限。举例说明:
DocFormer: 通过 CNN 解码器重构图像像素。
缺陷: 容易学习到噪声细节,而不是文档布局等高层级结构。
SelfDoc: 对掩码区域特征进行回归。
缺陷: 相较于在较小的词表中对离散特征进行分类,这种回归连续特征的方式噪声更大、更难学习。
这事实上体现出了跨模态表示学习的难点所在:
粒度不一致: 图像模态的目标是密集/连续的(如密集像素、连续区域特征),而文本模态的目标是离散的(离散 Token)。
影响: 这种粒度上的不匹配,进一步增加了学习 “跨模态对齐” 的难度,而跨模态对齐正是多模态表示学习的核心所在。
为了解决这种文本模态与图像模态预训练目标不对齐的问题,作者提出了 LayoutLMv3 ,它实现了统一掩码机制,在文本侧重构被掩码的词 Token(MLM),并在图像侧对称地重构被掩码的图像 Patch Token(MIM,Masked Image Modeling)。受 DALL-E 和 BEiT 启发,作者通过离散 VAE(dVAE)的隐码(Latent Codes)来获取目标图像 Token,解决了前面提到的图像/文本粒度不一致问题。
我的理解:离散 VAE 的作用是把输入的图像 Patch Embedding 映射为一个离散的整数索引(Latent Code)。因此,预测被掩码的图像 Patch Token 这一任务就转化为了预测对应的 Latent Code 的任务,这就与文本模态预测离散 Token ID 的任务统一起来了。
此外,由于文档中每一个文本单词都对应了一个图像块,因此,为了学习这种文本-图像对齐关系,作者提出了一个词-块对齐(Word-Patch Alignment, WPA)目标,通过预测“某个文本词对应的图像块是否被掩码(Masked)”,来学习跨模态的细粒度对齐。
受 ViT 和 ViLT 启发,LayoutLMv3 直接利用文档图像中截取出来的原始图像块,而无需页面目标检测等复杂预处理。换言之,LayoutLMv3 在同一个 Transformer 模型中,通过 MLM + MIM + WPA 三个统一目标联合学习图像、文本及多模态表示。这使得 LayoutLMv3 成为首个在图像 Embedding 上完全不使用 CNN 的多模态 Document AI 预训练模型,显著节省了模型参数,并摆脱了对区域标注的依赖。这种简单统一的架构和目标,使其能够同时作为“以文本为中心”和“以图像为中心”任务的通用预训练模型。
作者通过 5 个基准测试来评估 LayoutLMv3 的效果:
实验证实了 LayoutLMv3 在上述基准测试上取得了当时 SOTA 的结果。
2. LayoutLMv3 架构
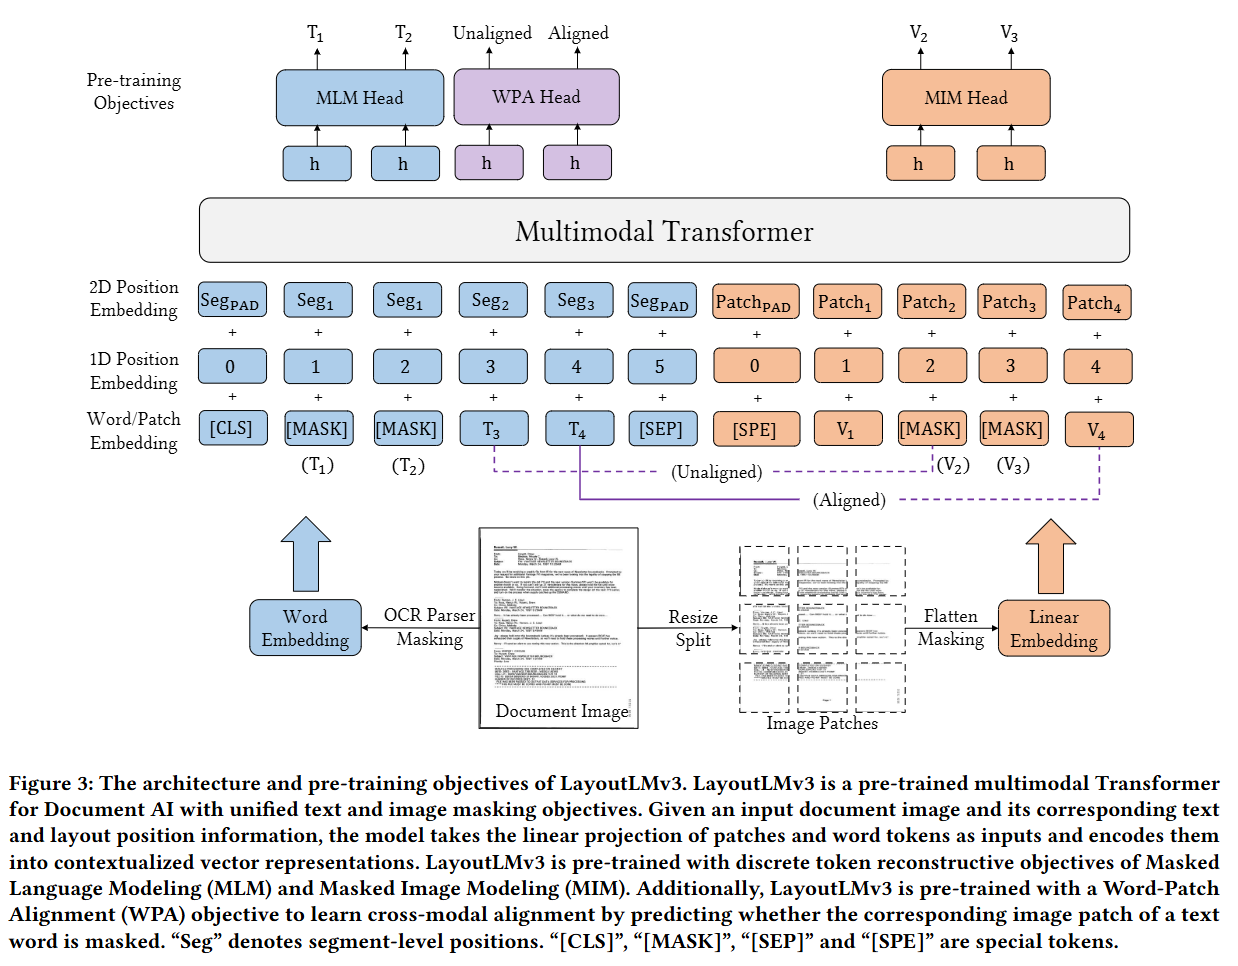
下图展示了 LayoutLMv3 的架构概览:
2.1 架构概述
LayoutLMv3 采用一个多层堆叠的统一文本-图像的多模态 Transformer 模型来学习跨模态表征。每一个 Transformer 层主要包含多头自注意力以及逐位置全连接前馈神经网络。Transformer 模型接受文本 Token Embedding 序列 Y = y1:𝐿 和图像 Patch Embedding 序列 X = x1:𝑀 作为输入,并在最后一个 Transformer 层输出文本-图像上下文表征,可以送入 MLM Head、MIM Head 和 WPA Head 计算损失。
2.1.1 文本 Embedding 是如何得到的?
LayoutLMv3 的文本嵌入由 词嵌入(Word Embeddings) 与 位置编码(Position Embeddings) 相加/融合而成:
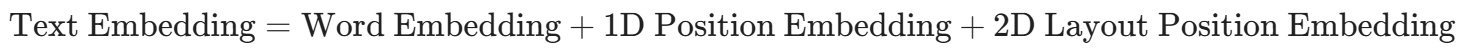
Word Embeddings 部分:直接使用预训练模型 RoBERTa 的词嵌入矩阵(Word Embedding Matrix)进行初始化。
Position Embeddings 部分:首先使用现成的 OCR 工具包处理文档图像,从中获取文本内容及其对应的 2D 位置信息。然后,为了同时捕捉文本的顺序关系与几何空间关系,LayoutLMv3 采用了两种位置编码:
此外,作者还提到了 LayoutLMv3 与 LayoutLM & LayoutLMv2 的关键改进:
LayoutLM & LayoutLMv2:采用 Word-level(词级)布局位置,即每个词(Word)都有独立的 2D 坐标。
LayoutLMv3:采用 Segment-level(片段级)布局位置,即同一个文本片段(Segment)内的所有词共享完全相同的 2D 布局位置坐标。
修改动机:同一个片段内的词通常表达同一个完整的语义,共享位置可以更好地表征文本块的整体语义结构。
2.1.2 图像 Embedding 是如何得到的?
LayoutLMv3 彻底抛弃了 CNN,直接使用图像块的线性投影特征(Linear Projection Features):
尺寸调整: 将文档图像缩放到统一尺寸 H * W,表示为张量 I ∈ ℝ𝐶×𝐻×𝑊(C 为通道数,H 为高,W 为宽)。
切分成块(Patching): 将图像切分为大小为 P * P 的均匀图像块。
线性投影与展平: 将每个图像块通过线性层投影到 D 维向量空间,展平后得到长度为 M = HW / P2 的向量序列。
添加 1D 绝对位置编码: 给每个图像块向量加上可学习的 1D 位置编码。
注:作者在初步实验中发现引入 2D 位置编码并没有带来性能提升,因此仅使用了 1D 位置编码。
此外,沿用 LayoutLMv2 的做法,LayoutLMv3 在文本和图像模态的自注意力网络中引入了 语义 1D 相对位置 与 空间 2D 相对位置 作为偏置项。
2.2 预训练目标
LayoutLMv3 的完整预训练目标可以定义为:𝐿 = 𝐿𝑀𝐿𝑀 + 𝐿𝑀𝐼𝑀 + 𝐿𝑊𝑃𝐴
2.2.1 目标一:掩码语言建模(MLM)
在文本侧,采用连续片段掩码策略,掩码片段的长度服从泊松分布(参数 λ = 3),一共掩码 30% 的文本 Token 。
该目标的本质是:在给定被破坏(掩码)的多模态序列上下文的前提下,最大化真实被掩码文本 Token 的对数似然。这等价于最小化如下的交叉熵损失函数:
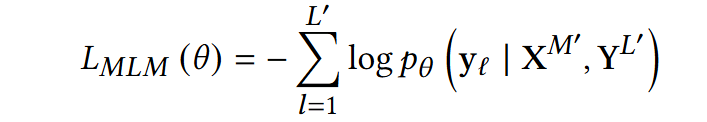
式中的符号含义如下:
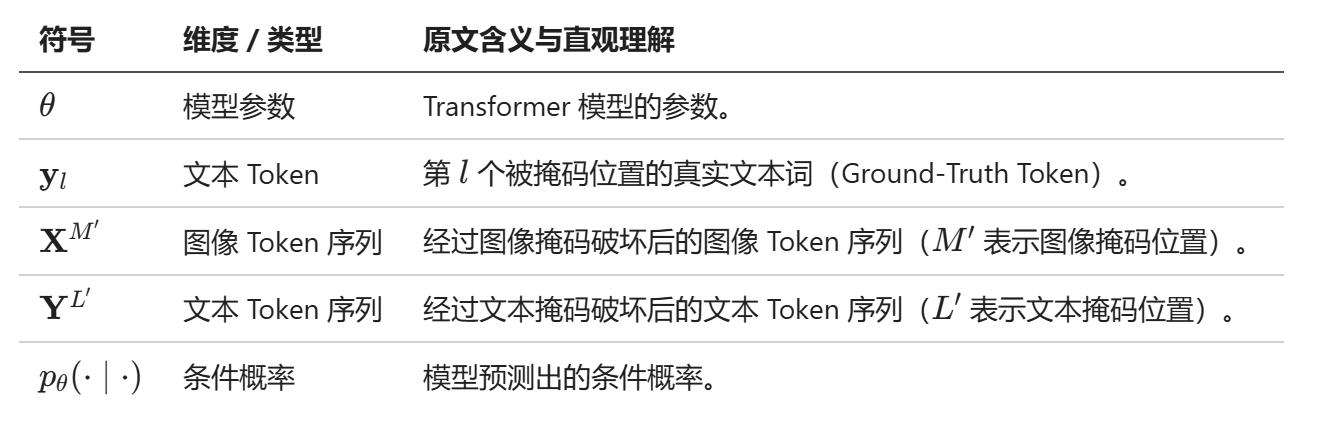
需要注意的是,在对文本 Token 进行掩码时,保持其对应的 2D 布局位置信息不变。这促使模型不仅依赖周围文本,还能显式利用留存的空间几何坐标(Layout)和视觉上下文(Image Context)来联合推断缺失的文本,从而建立起布局、文本与图像上下文之间的深层对应关系。
2.2.2 目标二:掩码图像建模(MIM)
为了促使模型结合上下文中的文本和图像表征来理解视觉内容,LayoutLMv3 借鉴 BEiT 的 MIM 预训练目标,使其与文本侧的 MLM 形成对称设计,二者均基于周围的多模态上下文来重构被掩码的离散 Token。
在图像侧,采用块状掩码策略,共随机掩码约 40% 的图像 Token 。MIM 同样采用交叉熵损失,驱动模型在周围未被掩码的文本与图像 Token 上下文下,重构被掩码的图像 Token:
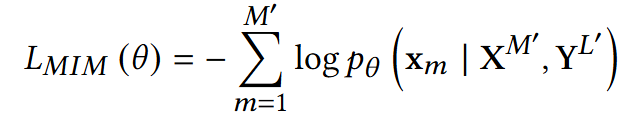
式中的符号含义如下:
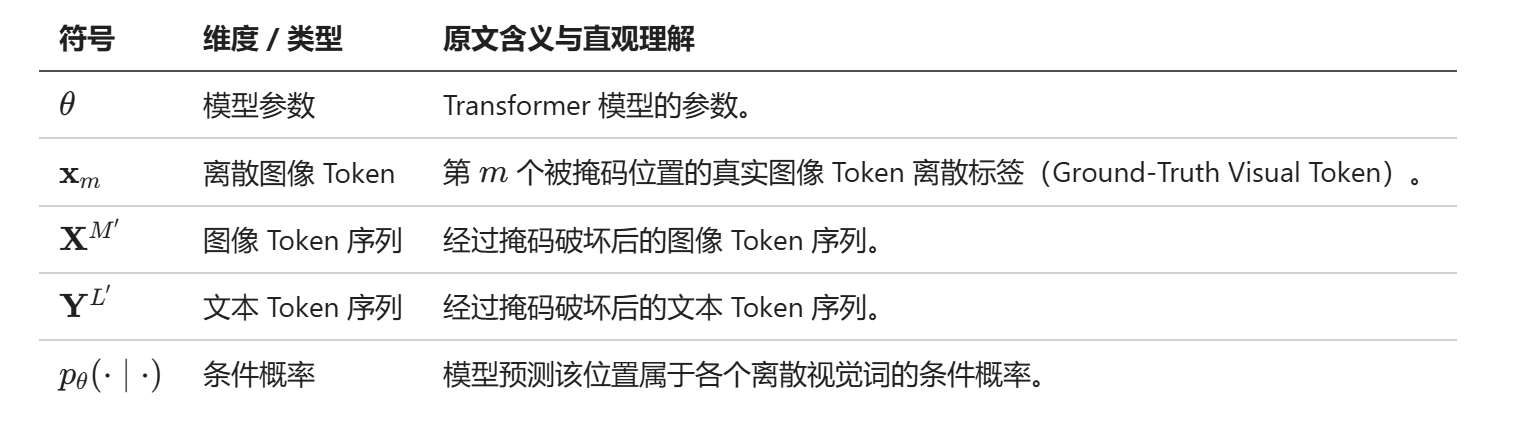
图像 Token 的标签由图像分词器生成,它依据视觉词表将密集的图像像素转化为离散 Token 。相比于直接回归 RGB 像素值,预测离散视觉词有助于模型学习高层级的文档布局结构,避免陷于学习低层级图像噪点与无关细节。
2.2.3 目标三:词-块对齐(WPA)
在文档中,每一个文本词(Text Word)在空间上都对应着特定的图像块(Image Patch)。由于 MLM 和 MIM 分别对文本和图像进行独立的随机掩码,模型缺乏显式的跨模态对齐学习机制。因此,作者提出 WPA 目标,旨在学习文本词与图像块之间细粒度的跨模态对齐关系。
WPA 被建模为一个二分类预测任务:预测某个文本词对应的图像块是否被掩码。
Aligned(对齐标签): 当一个未被掩码的文本 Token,其对应的图像 Token 也未被掩码时,分配为 Aligned。
Unaligned(不对齐标签): 当该文本 Token 对应的图像 Token 被掩码时,分配为 Unaligned。
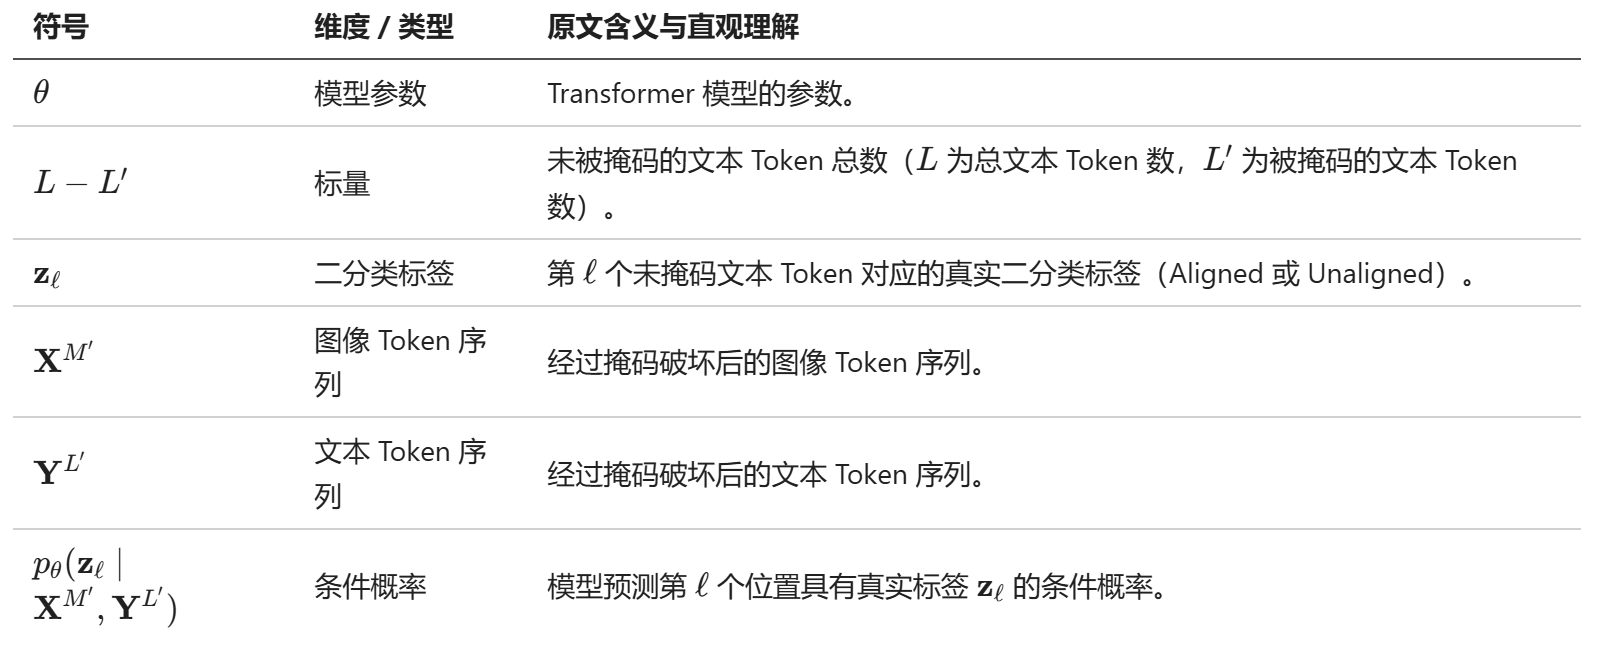
注意,在计算 WPA 损失时,显式排除所有被掩码的文本 Token 。这是为了防止模型学习到“已被遮挡的文本词”与“图像块”之间的虚假对应关系。
LayoutLMv3 使用一个两层 MLP 头,输入上下文文本和图像表征,输出二分类标签(Aligned / Unaligned),采用二元交叉熵损失:
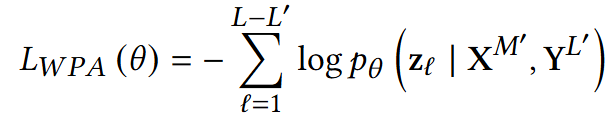
式中的符号含义如下:
3. 实验与结果
3.1 模型配置
模型规格对比
作者采用了两种大小的 LayoutLMv3 模型:
输入序列与预处理参数
文本模态:
使用 BPE(Byte-Pair Encoding) 分词器。
最大文本序列长度 L = 512。
文本序列开头添加 [CLS],末尾添加 [SEP];若长度不足 L 则用特殊 Token [PAD] 补齐。
特殊 Token([CLS]、[SEP]、[PAD])的 2D 边界框坐标均设为全 0。
图像模态:
输入图像尺寸:C * H * W= 3 * 224 * 224
图像块尺寸:P = 16
图像 Patch 序列长度:M = 196
训练工程优化策略
分布式与混合精度训练: 用于降低显存开销并加快训练速度。
梯度累加: 将大 Batch 拆分为多个 Mini-batch,突破大批量训练时的显存瓶颈。
梯度检查点: 在文档布局分析任务中进一步使用,以降低高分辨率/密集计算下的显存占用。
注意力数值稳定性优化
为防止训练过程中的数值不稳定,模型借鉴了 CogView 的注意力计算修正方法:
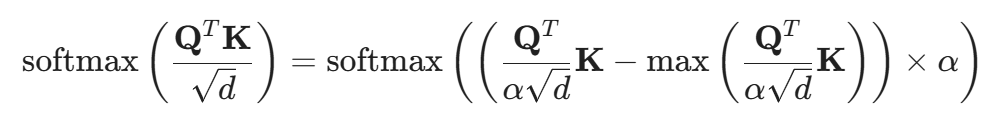
其中超参数 α = 32 。
3.2 LayoutLMv3 预训练
为了让模型学习各种文档任务上的普遍表征,作者对 LayoutLMv3 模型做了预训练。
预训练数据集
数据集来源: 采用大规模扫描文档图像数据集 IIT-CDIP Test Collection 1.0。
数据规模: 该数据集总计约 1100 万张文档图像(可拆分为 4200 万页),LayoutLMv3 仅使用了其中的 1100 万张图像。
图像增强: 沿用 LayoutLM 系列的做法,不进行任何图像数据增强。
权重初始化策略
多模态 Transformer 编码器与文本嵌入层: 使用预训练的 RoBERTa 权重进行初始化。
图像分词器: 使用文档图像预训练模型 DiT 中预训练好的图像分词器进行初始化。
视觉词表大小: 图像 Token 的词表容量为 8,192 。
其余参数: 其余模型参数均采用随机初始化。
优化器与通用训练超参数
优化器: Adam 优化器
动量超参数: (β1, β2) = (0.9, 0.98)
权重衰减(Weight Decay): 1e-2
批大小(Batch Size): 2,048
总训练步数: 500,000 步
Base 与 Large 模型训练配置对比
3.3 在多模态任务上的微调
Baselines 介绍
作者将用于对比的自监督预训练方法 Baselines 按预训练模态与视觉特征提取方式划分为以下五大类:
作者在多个公开可用的基准测试中的多模态任务上微调并比对了 LayoutLMv3 的效果。
任务一:表格理解与收据理解任务
任务本质: 从表单和收据中提取结构化文本内容,在算法上被建模为序列标注问题,目标是为每一个词赋予一个语义标签。
下游预测头架构:
表单理解(FUNSD): 直接在每个文本 Token 的最后一层隐层状态后接一个线性层。
收据理解(CORD): 在每个文本 Token 的最后一层隐层状态后接一个 MLP 分类器。
数据集描述:
超参数配置:
FUNSD 微调: 训练 1,000 步,学习率为 1e-5,批大小为 16。
CORD 微调: 训练 1,000 步,学习率为 5e-5,批大小为 64。
评估指标与实验结论:
评估指标: 采用 F1 Score 。
FUNSD 表现:
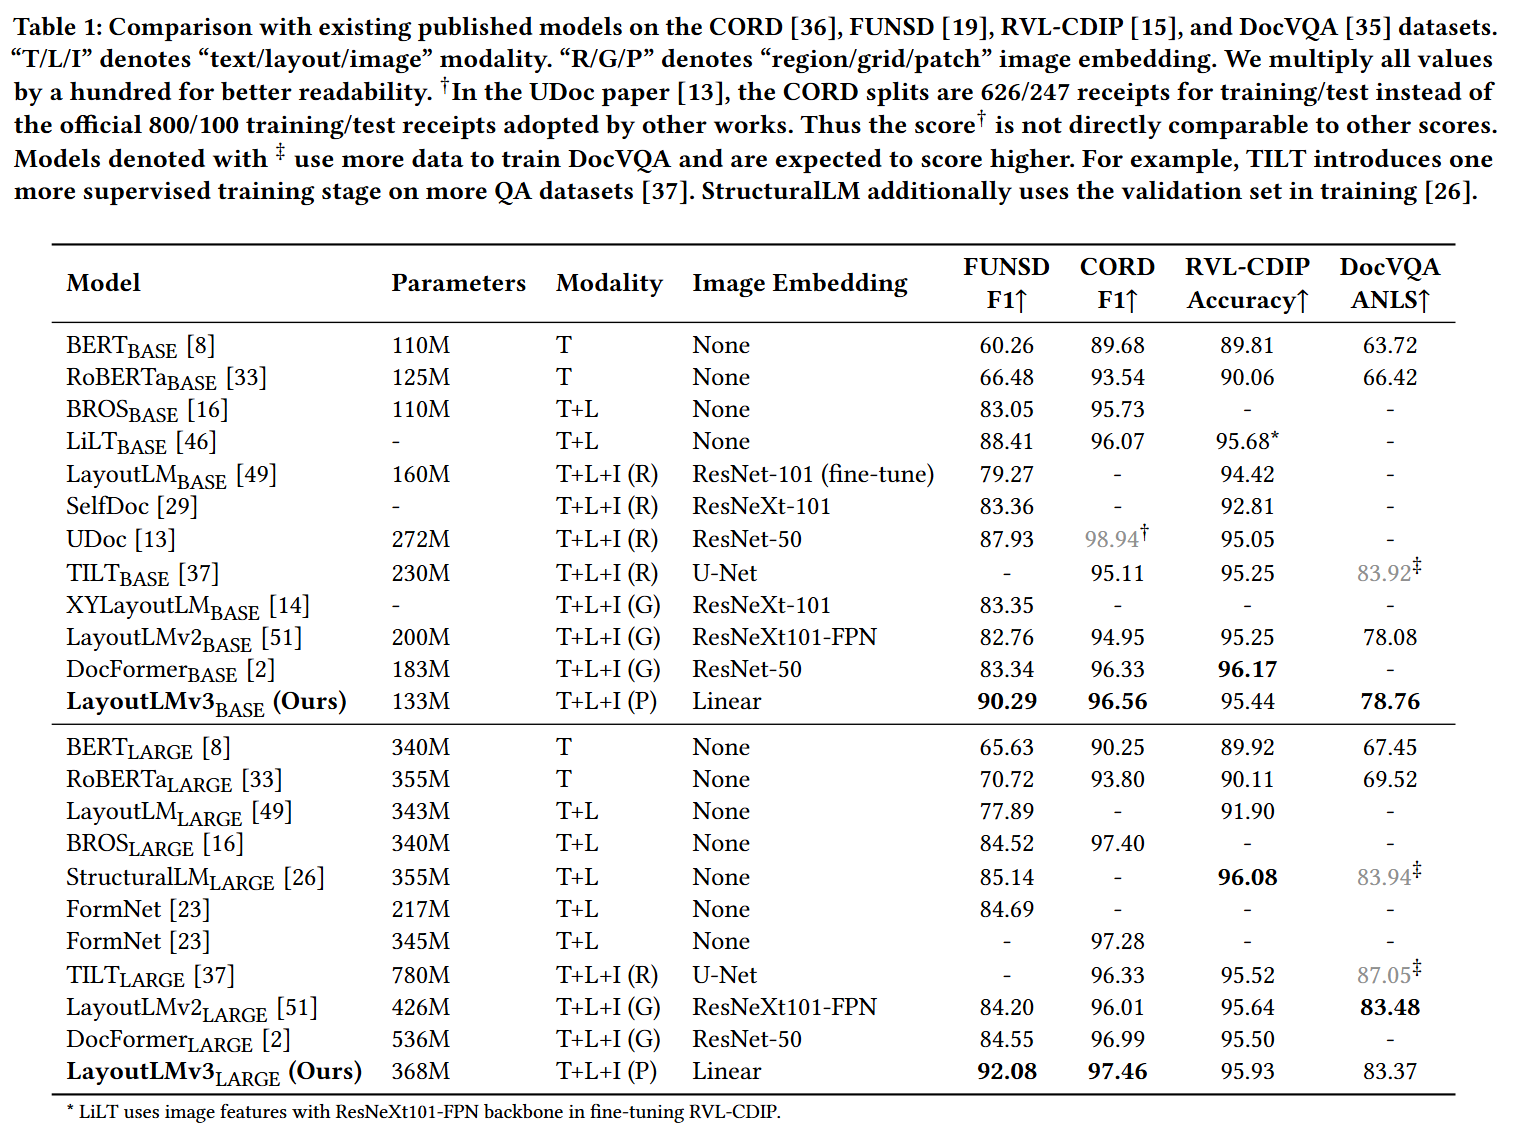
LayoutLMv3-Large 取得了 92.08 的 F1 分数,大幅超越了 StructuralLM 先前保持的 SOTA 结果(85.14)。
重要说明(可比性): LayoutLMv3 与 StructuralLM 均使用片段级(Segment-level)布局位置,而其他模型使用词级(Word-level)布局位置。片段级位置可能对 FUNSD 的实体标注有额外增益,因此这两类工作不能直接完全等同对比。
CORD 表现:
LayoutLMv3 在 Base 和 Large 两个尺寸上均取得了 SOTA 的 F1 分数。
结论: 证明 LayoutLMv3 能显著赋能以文本为中心的表单与收据理解任务。
任务二:文档图像分类任务
任务目标: 预测输入文档图像的所属类别。
预测头架构: 将特殊分类 Token([CLS])对应的最终隐层输出状态输入至一个 MLP 分类器,以此预测文档的类别标签。
数据集与数据预处理:
数据集: RVL-CDIP 数据集(IIT-CDIP 集合的子集)。
类别数量: 共标注了 16 个类别。
样本划分: 包含 400,000 张文档图像:
训练集: 320,000 张
验证集: 40,000 张
测试集: 40,000 张
文本与布局获取: 使用 Microsoft Read API 提取文档中的文本和 2D 布局坐标。
超参数配置:
训练步数: 20,000 步
批大小: 64
学习率: 2e-5
评估指标与实验结论:
评估指标: 总体分类准确率。
对比 LayoutLMv2 的收益:
Base 规格: 准确率绝对提升 0.19%。
Large 规格: 准确率绝对提升 0.29%。
模型轻量化与结构简化: 相比 LayoutLMv2 采用的重型 ResNeXt101-FPN CNN 骨干网络,LayoutLMv3 仅使用极简的线性图像块投影,在参数量显著降低的同时取得了更优或可比的效果。
核心结论: 表明轻量、简单的线性图像嵌入在以图像为中心的任务中同样能达到理想的表征性能。
任务三:文档视觉问答任务
任务目标: 模型以文档图像和输入问题作为输入,输出对应的答案。
建模范式: 建模为抽取式问答问题。
预测头架构: 通过二分类器对每个文本 Token 的最终隐层状态进行分类,分别预测答案文本跨度的起始位置与结束位置。
数据集划分与预处理:
数据集: 标准 DocVQA 数据集。
样本规模划分:
训练集: 10,194 张图像 / 39,463 个问题
验证集: 1,286 张图像 / 5,349 个问题
测试集: 1,287 张图像 / 5,188 个问题
预处理与标注匹配:
使用 Microsoft Read API 提取图像中的文本与 2D 边界框坐标。
沿用 LayoutLMv2 的启发式规则在提取的文本序列中定位真实答案位置。
在训练集上训练,在测试集上评估并提交至官方评测网站获取成绩。
超参数配置:
评估指标与实验结果:
评估指标: 采用基于编辑距离的标准指标 ANLS(Average Normalized Levenshtein Similarity,平均归一化编辑距离相似度)。
Base 模型表现: LayoutLMv3-Base 的 ANLS 得分达到 78.76,优于 LayoutLMv2-Base 的 78.08,且图像特征提取方式大幅简化(从 ResNeXt101-FPN 简化为线性 Patch 投影)。
Large 模型表现: LayoutLMv3-Large 在 Base 基础上进一步取得了 4.61 的绝对分值提升(达到 83.37)。
结论: 验证了 LayoutLMv3 在跨模态文档视觉问答任务上的有效性。
下表展示了上述三个任务下的对比实验数据:
3.4 在视觉任务上的微调
任务建模与检测架构
任务目标: 文档布局分析,通过预测边界框与类别(如文本、图表、表格等)解析非结构化文档,验证模型向纯视觉下游领域的泛化能力。
建模范式: 建模为不带文本嵌入的目标检测问题。
检测框架与骨干集成:
将 LayoutLMv3 作为特征提取骨干网络,接入基于 Detectron2 实现的 Cascade R-CNN + FPN 检测器。
多尺度特征构建: 从 Transformer 的不同层(以 Base 模型为例:第 4、6、8、12 层)提取单尺度特征,并通过分辨率调整模块将其转换为 FPN 所需的多尺度特征。
数据集与类别设定
数据集: PubLayNet 数据集(学术论文图像)。
版面类别(5 类): text(正文)、title(标题)、list(列表)、figure(图片)、table(表格)。
数据划分与使用:
训练集:335,703 张图像
验证集:11,245 张图像(遵循惯例在此集合上进行评测)
测试集:11,405 张图像
微调超参数与训练策略
评估指标与实验结论
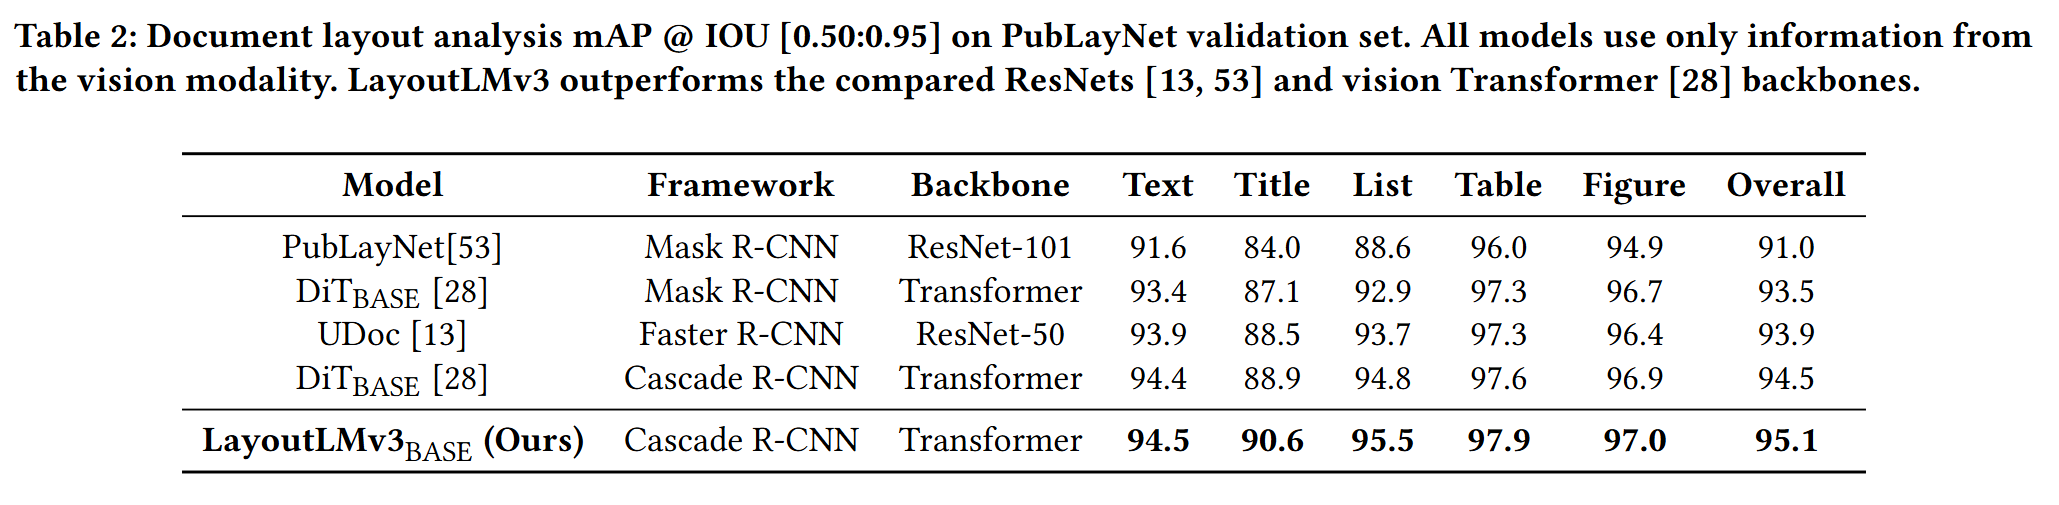
评估指标: 边界框的平均精度均值 mAP @ IoU [0.50:0.95]。
对比基线: 优于基于 ResNet 的模型以及同期的纯视觉文档 Transformer 骨干(DiT)。
核心表现与归因:
取得了 95.1 的综合 mAP SOTA 表现。
在 “Title”(标题) 类别上提升尤为显著。作者分析认为:标题通常比其他版面元素小得多,且严重依赖文本语义来识别,该提升主要归功于 LayoutLMv3 在预训练阶段融合了语言模态的先验知识。
具体实验数据
3.5 消融实验
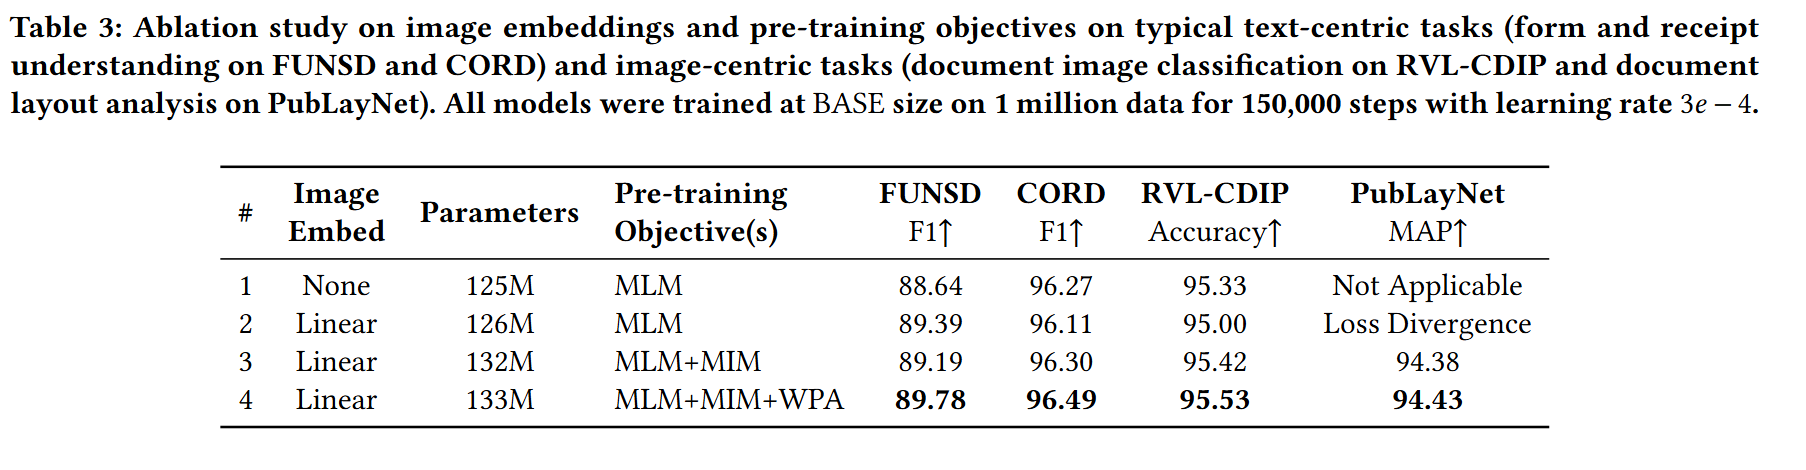
作者设计了四个逐步递进的模型变体,以验证图像嵌入方式与各预训练目标的有效性:
PubLayNet 微调实验结果
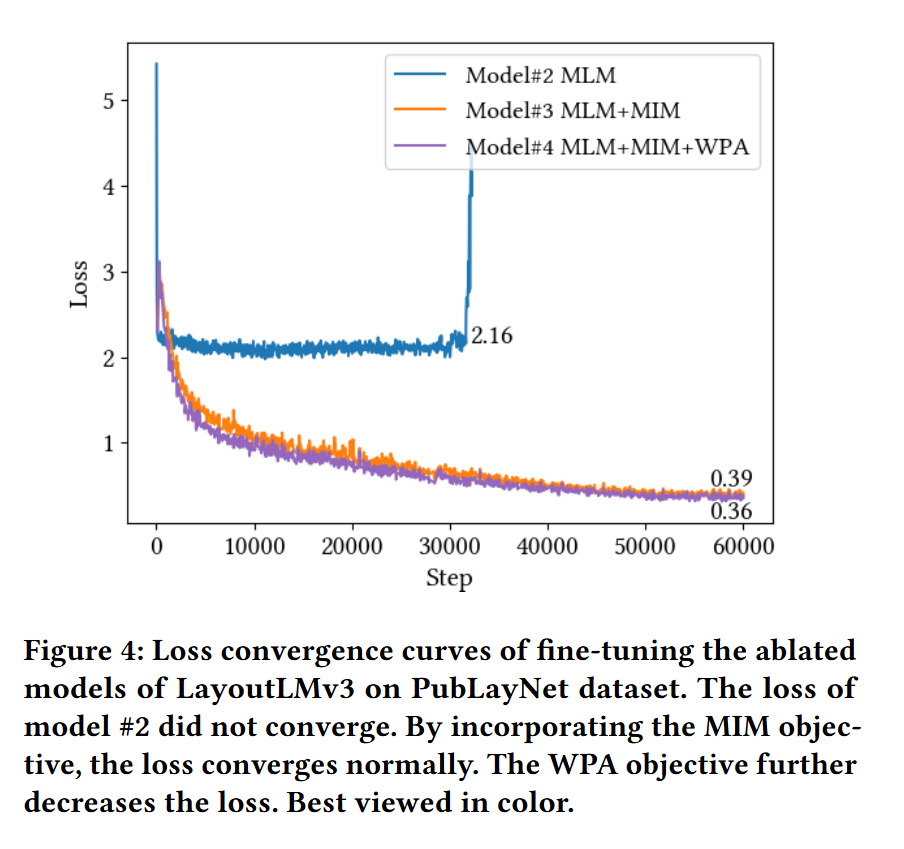
微调基准测试: 在 PubLayNet 数据集上微调并对比 Model #2、#3、#4 的损失曲线(Batch Size = 16,Learning Rate = 2e-4)。
Model #2 的不收敛现象:
虽然尝试了多种学习率(1e−4, 2e−4, 4e−4)与批大小(16, 32)的组合,Model #2 的训练损失均无法收敛。
Model #2 在 PubLayNet 上的 mAP 得分接近于 0。
结论与意义:
仅在输入端简单引入图像 Patch 嵌入(Model #2),若缺乏专门的视觉预训练目标(MIM)和跨模态对齐目标(WPA),模型无法有效利用视觉表征,在纯视觉下游任务(如版面分析)上完全无法迁移。
证明了 MIM 与 WPA 预训练目标对于多模态 Transformer 学习有效视觉与跨模态表征是必不可少的。
线性图像嵌入的作用
语言模态(文本 + 布局)的基础价值: 不含图像嵌入的 Model #1 在部分任务上仍能取得良好表现,表明包含文本与布局信息的语言模态在文档理解中起着重要的作用。
纯语言/布局方案的局限性:
仅靠文本与布局的结果仍不够理想。
完全无法处理部分以图像为中心的文档分析任务。例如在 PubLayNet 文档布局分析任务中,边界框(Bounding Boxes)与图像内容紧密关联,视觉模态不可或缺。
线性图像嵌入的有效性: 极简的线性图像嵌入设计与合适的预训练目标(MIM / WPA)相结合,不仅能够显著提升以图像为中心的任务表现,还能进一步持续改善以文本为中心的任务效果。
MIM 目标的作用
单纯拼接图像嵌入的缺陷:
性能劣化与发散: 在 Model #2 中,直接将线性图像嵌入与文本嵌入拼接输入,导致在 CORD 和 RVL-CDIP 上的表现下降,而在 PubLayNet 上的微调损失甚至无法收敛。
原因推测: 在没有任何图像模态预训练目标的情况下,模型无法在线性图像块嵌入上学到有意义的视觉表征。
MIM 机制如何发挥作用:
信息保留机制: MIM 目标通过随机掩码部分输入图像块并在输出端对其进行重构,迫使模型将图像特征信息一路保留并传递至最后一层。
正则化作用: 实验表明,MIM 目标能够起到对训练做正则化的作用。
各基准任务上的具体收益(Model #3 vs. Model #2):
CORD 与 RVL-CDIP: 引入 MIM 目标后,模型在这两个数据集上的表现均得到明显提升。
FUNSD: 由于单纯引入线性图像嵌入时已提升了 FUNSD 性能,引入 MIM 目标并未对其带来进一步增益。
PubLayNet(视觉任务): 引入 MIM 目标后,PubLayNet 的微调损失实现收敛,并取得了令人满意的 mAP 得分。
结论:MIM 预训练目标对于稳定多模态训练至关重要,特别是对于像 PubLayNet 文档布局分析这类以视觉为核心的任务是不可或缺的关键组件。
WPA 目标的作用
全任务一致性提升(Model #4 vs. Model #3): 在 Model #3(MLM + MIM)的基础上引入 WPA 构成 Model #4 后,WPA 目标在所有评估任务上均带来了一致的性能提升。
进一步降低视觉任务损失: WPA 目标在微调阶段进一步降低了 PubLayNet 文档布局分析视觉任务的损失。
双重表征学习效能: 实验结果证实,WPA 目标不仅对跨模态表示学习至关重要,同时也对图像表示学习具有显著的促进作用。
参数量对比
图像嵌入的参数轻量化优势:
极低开销: 引入 16 * 16 的图像块线性投影(即从 Model #1 升级到 Model #2)仅增加了 0.6M 参数。
对比 CNN 骨干: 相比传统文档多模态模型常采用的 CNN 骨干网络(例如 ResNet-101 约 44M 参数),线性图像嵌入增加的参数量几乎可以忽略不计。
预训练预测头(Pre-training Heads)的参数分布:
MIM 头: 预训练阶段引入 6.9M 参数。
WPA 头: 预训练阶段引入 0.6M 参数。
MLM 头: 由于文本词表大小为 50,265,文本侧 MLM 头的参数量达到了 39.2M。
结论: 相比文本 MLM 头的体量,图像嵌入与视觉相关预测头所带来的额外参数开销非常微小。
关于图像分词器(Image Tokenizer)的参数统计说明
未计入模型参数: 在统计 Transformer 模型参数量时,明确排除了图像分词器。
原因: 图像分词器仅作为生成 MIM 真实标签的独立离散化模块存在,并不嵌入在 Transformer 骨干网络内部。
具体实验数据展示
4. 结论与未来展望
作者在本研究中提出了用于文档 AI(Document AI)的多模态 Transformer 预训练模型 LayoutLMv3,对 LayoutLM 的模型架构和预训练目标进行了重新设计。与现有的文档 AI 多模态模型不同,LayoutLMv3 不依赖预训练的 CNN 或 Faster R-CNN 骨干网络来提取视觉特征,从而显著节省了模型参数量并摆脱了对区域标注的依赖。
作者采用统一的文本与图像掩码预训练目标——掩码语言建模(MLM)、掩码图像建模(MIM)以及词-块对齐(WPA)来学习多模态表征。广泛的实验结果表明,凭借简洁的架构与统一的目标,LayoutLMv3 在以文本为中心和以图像为中心的文档 AI 任务中均展现出了通用性与优越性。
作者指出了以下可以在未来深入研究的方向:
探索扩大预训练模型的规模(Scaling up),以便模型能够利用更多的训练数据进一步刷新 SOTA 表现。
探索少样本(Few-shot)与零样本(Zero-shot)学习能力,以更好地赋能文档 AI 领域中更多的真实业务场景。