

MinerU 是非常著名且广泛使用的 PDF 文档提取开源项目。
今天研读《MinerU: An Open-Source Solution for Precise Document Content Extraction》
开源实现:MinerU
1. 为什么要引入 MinerU ?
随着 LLM 与 RAG 技术的发展,对高质量文档提取的需要日益强烈。在当时有四类主流的文档内容提取方案:
基于 OCR 的文档提取:用 OCR 模型直接从文档中提取文本内容。这对于纯文本文档很可行,但是对包含图像、图表、公式等其他元素的文档来讲,OCR 会引入大量噪声(混乱的、不正常的提取结果)。
基于开源库的文本解析:对于非扫描文件,一些开源的 Python 库(如著名的 PyMuPDF)能在不引入 OCR 的前提下直接阅读文档内容,从而提供更快更准确的内容提取。但同样地,这种方法对含有公式、图表的文档无能为力。
多单元文档解析:这种方法利用多种不同类型的文档解析模型,在多个阶段逐步处理文档图像。具体步骤如下:
首先,用版面检测算法分划出文档的不同区域,比如图像、图像描述信息、表格、表格描述信息、标题、正文等。
对不同区域使用不同的提取模型。比如,对正文和标题使用 OCR 模型,对公式使用公式识别模型,对表格使用表格识别模型等。
尽管这种方法在理论上能处理得到高质量的结果,但是现有开源方法仅仅针对学术论文设计,而对更多其他的文档类型(如教科书、考试试卷、研究报告、新闻报纸等)提取效果不佳。
端到端多模态 LLM 文档解析:随着多模态 LLM 的兴起,许多文档解析多模态 LLM 诞生了(如 Donut ,Nougat ,Kosmos-2.5 等)。这些模型受益于持续进化的 Encoder(如 SwinTransformer 和 ViTDet)以及 Decoder(如 mBART 和 Qwen2-0.5B)以及数据工程,能逐渐提升文档提取表现。但这种方法依然存在数据多样性和高推理成本的问题。
鉴于此,作者提出了 MinerU ,它是一个集成式(all-in-one)文档提取工具,能在处理多样化文档的同时,兼顾低推理成本与高推理质量。MinerU 采用了多模块文档解析策略,不过与现有的文档解析算法不同,MinerU 调用了 PDF-Extract-Kit 中的各种开源模型。这些模型是在多样化的真实世界文档上训练出来的,专门用来应对复杂版面与公式的提取难题。在利用模型获取文档中不同区域的位置信息与识别内容之后,MinerU 使用专门定制的处理工作流做进一步处理,从而确保最终结果的准确度。
作者指出,MinerU 作为文档提取工具,有以下几个优势:
对多样的文档版面的适应性:MinerU 支持许多文档类型,包括但不限于学术论文、教科书、考试试卷、研究报告。
内容过滤:MinerU 允许对不相关区域(比如标题、脚注、尾注等)进行过滤,从而增强文档的可读性。
准确的分段:MinerU 通过结合模型与规则方法,能准确识别段落,完成跨列甚至跨页的段落合并。(在研究报告、考试试卷、新闻报纸中,经常出现一个段落被分到同一页不同列甚至不同页上。MinerU 能够很好地处理这个问题)
鲁棒的页面元素识别:MinerU 能准确识别并区分公式、图表、图像、文本块,以及它们对应的描述信息。
2. MinerU 框架
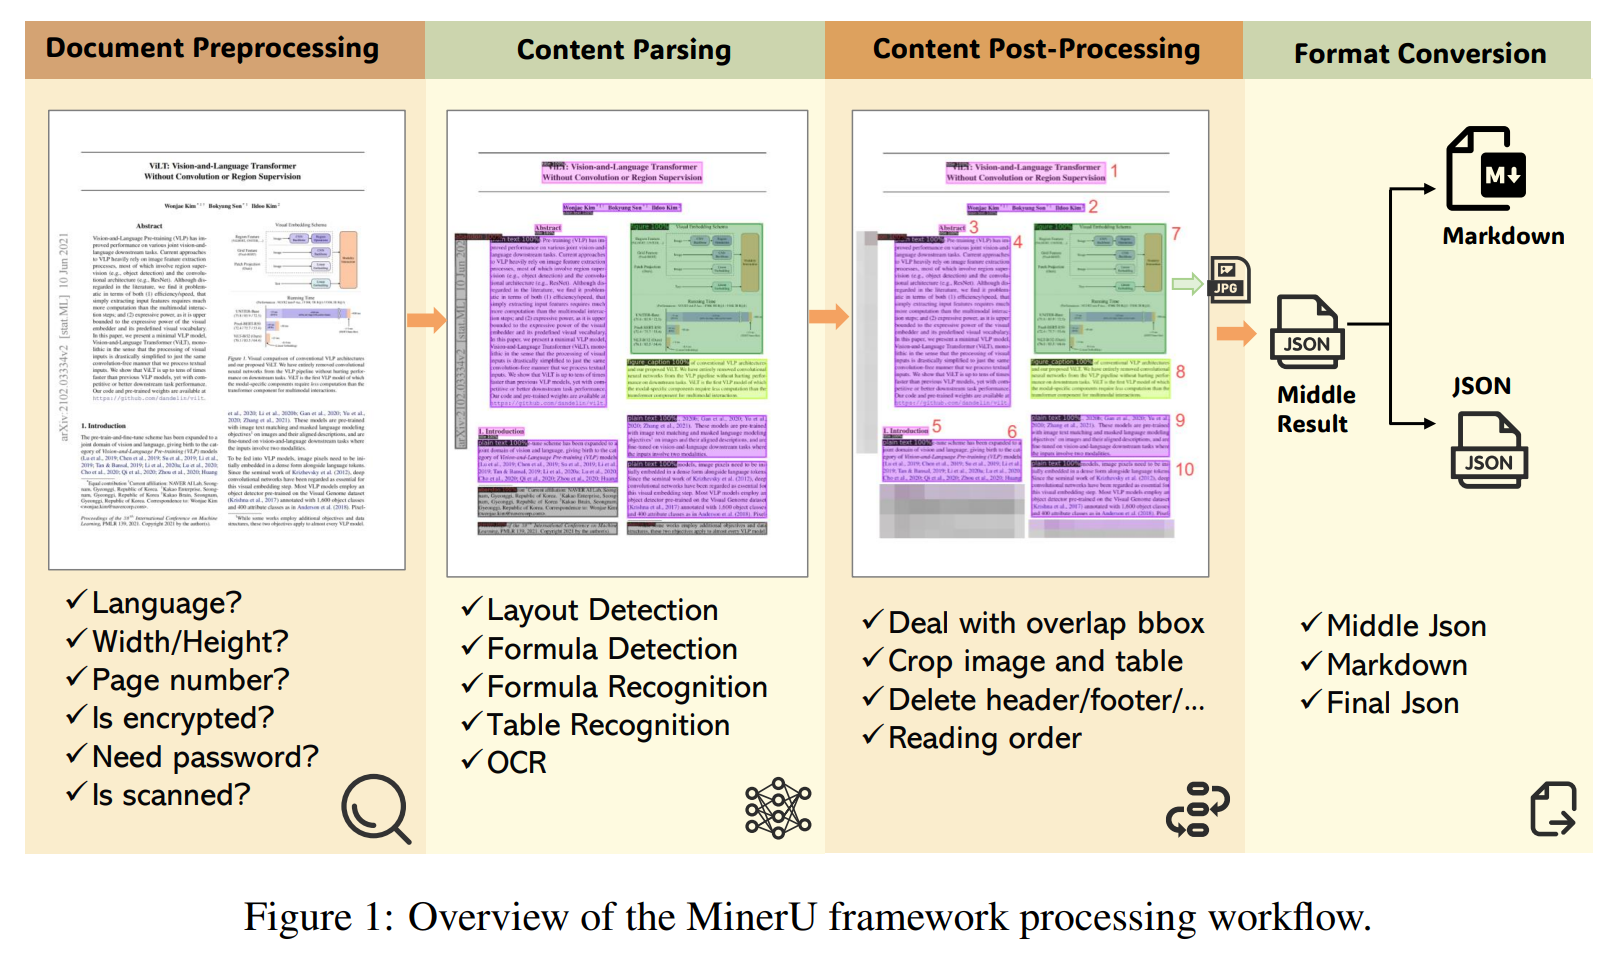
如上图所示,MinerU 的处理流水线分为四个步骤:
文档预处理:这一阶段采用 PyMuPDF 来阅读用户输入的 PDF 文件,将无法处理的文件(比如一些加密文件)过滤掉,并提取出 PDF 文件元信息。元信息包含文档的可解析性(划分为可解析文档与扫描文档两类)、页面尺寸、语言种类等。
文档内容解析:这一阶段利用 PDF-Extract-Kit(一个包含多种当时 SOTA 的开源 PDF 文档解析算法的模型库)来解析文档中的关键内容。分为两步:
第一步:版面分析:包含版面检测与公式检测。
第二步:分治识别(Divide and Conquer):
文本与标题 -> 送入 OCR 模型识别文字
数学公式 -> 送入 公式识别模型
表格 -> 送入 表格识别模型
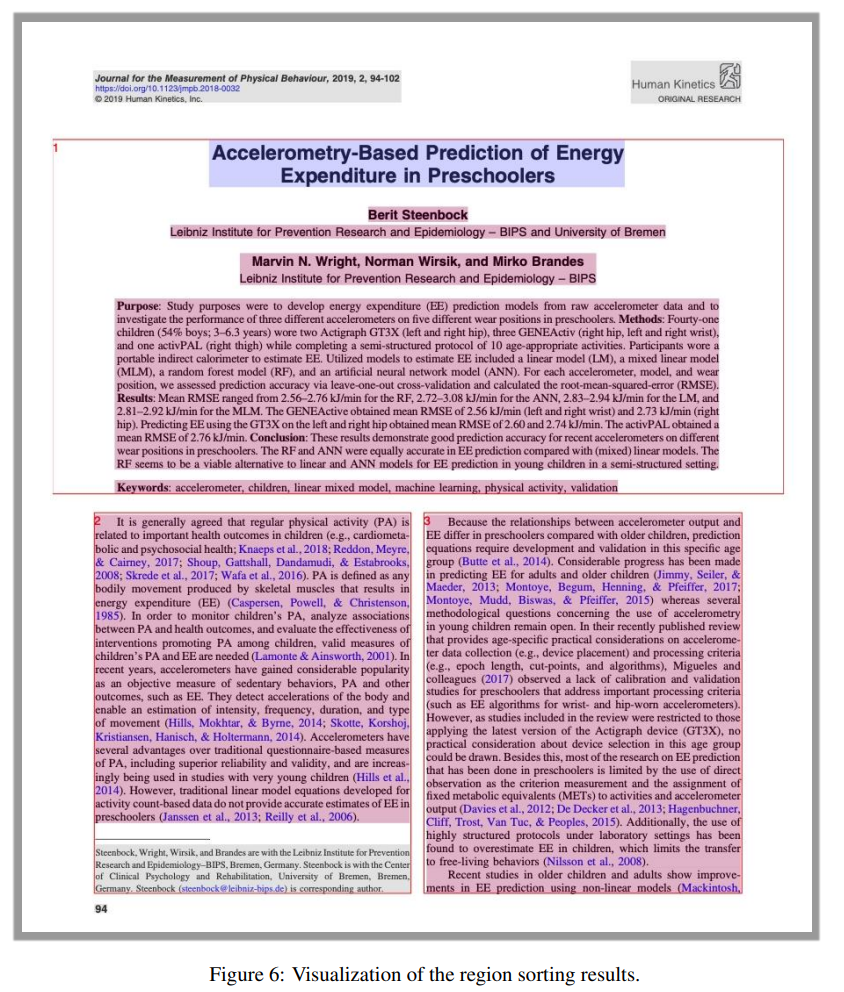
文档内容后处理:根据规则和版面信息删去无效区域,依靠位置坐标信息,将跨页、跨栏被截断的句子或段落缝合起来,最后确定多栏(如双栏学术论文)下的正确阅读顺序。
格式转换:基于后处理整理好的“元素 + 坐标 + 内容 + 阅读顺序”,渲染生成结构化的 Markdown 或 JSON 文件,提供给 RAG、大模型预训练等下游任务。
下面来逐步骤详细解读。
2.1 文档预处理
这一阶段有两个目标:
过滤掉无法处理的 PDF 文件,比如非 PDF 文件,加密文件,密码保护的文件,损坏了的文件等。
获取 PDF 文件的元信息,以供后续使用。获取 PDF 元数据的工作包含以下几个方面:
识别语言类别(中文、英文等)。语言类别会作为后续 OCR 模型的输入参数。
乱码检测。针对部分复制时会出现乱码的文本型 PDF 进行提前检测,识别出此类文档后,下一步将强制改用 OCR 来做文本识别,避免直接提取出现乱码。
扫描件 PDF 识别。
处理策略分化:
文本型 PDF :直接使用 PyMuPDF 提取文本。
扫描型 PDF :必须启用 OCR 模式进行识别。
判断扫描件的具体特征依据:
图像区域的面积大于文本区域面积(有时图像会覆盖整个页面);
单页平均文本长度接近于零。
页面元信息提取:提取文档的基本属性,包括总页数、页面尺寸(宽度和高度)以及其他相关属性。
2.2 文档内容解析
在这一阶段中,MinerU 依赖 PDF-Extract-Kit 模型库,检测文档中的不同区域,并对相应区域的内容进行专项识别(提取)。PDF-Extract-Kit 模型库通过数据工程 + 模型微调,保证了在处理真实世界多样化数据时,仍能维持高准确率与高处理速度。
在 v0.8.1 版本的 MinerU 中,内容解析阶段具体由以下 5 个精细化分工的模型共同完成:
版面检测:负责定位图表、标题、文本段落等大块区域。
公式检测:专门切出行内公式(Inline)与陈列公式(Display)的位置。
表格识别:负责解析表格结构、行列关系及单元格内容。
公式识别:对检测出来的公式图片进行识别,提取公式内容。
OCR(光学字符识别):负责将普通文本与标题区域转化为可读文字。
2.2.1 版面分析
版面分析是 PDF 文档提取的重要步骤。它能够区分不同种类的文档视觉元素,并识别出其在页面中的位置。为了解决现有版面分析方法对多样的文档种类(试卷、教科书等)适应性不佳的现状,PDF-Extract-Kit 模型库构造了一个多样的版面检测训练数据集,并在其上训练了高质量的版面检测模型。基于数据工程的模型训练方法如下所述:
多样化数据挑选:基于视觉特征聚类采样。
收集与聚类:收集海量多样化的 PDF 文档,根据视觉特征进行聚类,并从不同的聚类中心进行采样,确保初始数据集的覆盖面和多样性。
覆盖场景:涵盖学术论文、通用书籍、教材、试卷、杂志、PPT、研究报告等。
数据标注 (Data Annotation):细粒度划分与标注。
10 余种细粒度版面类别:
常规内容:标题、正文段落、图片、图片描述信息、表格、表格标题描述信息、图表注释。
公式细分:行内公式、公式编号/标签。
丢弃类别:页眉、页脚、页码、页面注释。
标注规模:制定了详细的标注标准,最终标注了约 2.1 万(21K)个数据点作为训练集。
模型训练:基座微调与类别对齐。
微调基座:基于现有的版面检测模型(如 LayoutLMv3, YOLO)进行微调。
参数修改:修改模型的类别数参数(number of classes),使其与 MinerU 重新定义的细粒度版面类别完全对齐。
迭代式数据选择与训练:动态加权与定向攻坚。
验证集引导:划分一部分数据作为验证集,用验证结果指导后续的数据迭代方向。
定向加权采样:如果某种特定来源的 PDF 在某个特定类别上的识别得分较低(例如:某类研报中的“表格标题”识别不好),在下一次迭代中就会提高该来源中包含该类别的 PDF 页面的采样权重,实现高效的数据与模型闭环迭代。
2.2.2 公式检测
虽然上面的版面分析模块已经能识别页面中的大多数元素,但是公式是一个特例。这是因为许多行内公式从视觉上看与普通文本差异并不大。但如果直接对其使用 OCR 或者 Python 库的话,就很可能得到混乱错误的解析结果。
因此,作者单独训练了一个公式检测模型(本文中使用了一个 YOLO 架构的模型作为基座)。这个模型会预测三个类别:行内公式、陈列公式、忽视类别。其中,忽视类别指的是一些很难被定义为“公式”的内容,比如 “50%” “NaCl” 等等。最终,作者在 2890 页训练数据上标注了 24157 条行内公式与 1829 条陈列公式。
如果读者了解 markdown 的话,用 $ ... $ 包围的就是行内公式,用 $$ ... $$ 包围的就是陈列公式。
2.2.3 公式识别
上一小节中描述了如何检测出公式所在区域的方法,这一小节描述如何识别检测区中公式的内容。这事实上是一个比较复杂的任务,因为不同类型的文档中可能出现不同种类的公式,比如短小的印刷体行内公式,繁复的陈列公式,甚至是某些扫描件中的手写公式。
因此,作者自研了 UniMERNet 模型,并基于大规模、多样化的公式识别数据集 UniMER-1M 进行训练。通过网络结构优化,UniMERNet 对真实场景下的各类公式均具备强大解析能力,效果甚至媲美商业软件 MathPix 。
2.2.4 表格识别
MinerU 支持将表格转换为 LaTeX 或 HTML 格式。具体而言,MinerU 整合了两套不同的表格识别模型,分别应对不同复杂度的场景:
2.2.5 OCR
在剔除表格、公式、图片等特殊区域后,MinerU 使用集成在 PDF-Extract-Kit 中的 Paddle-OCR 对普通文本和标题区域进行识别。
为了解决传统全页 OCR 容易出现的问题,MinerU 在这里设计了两个巧妙的机制:
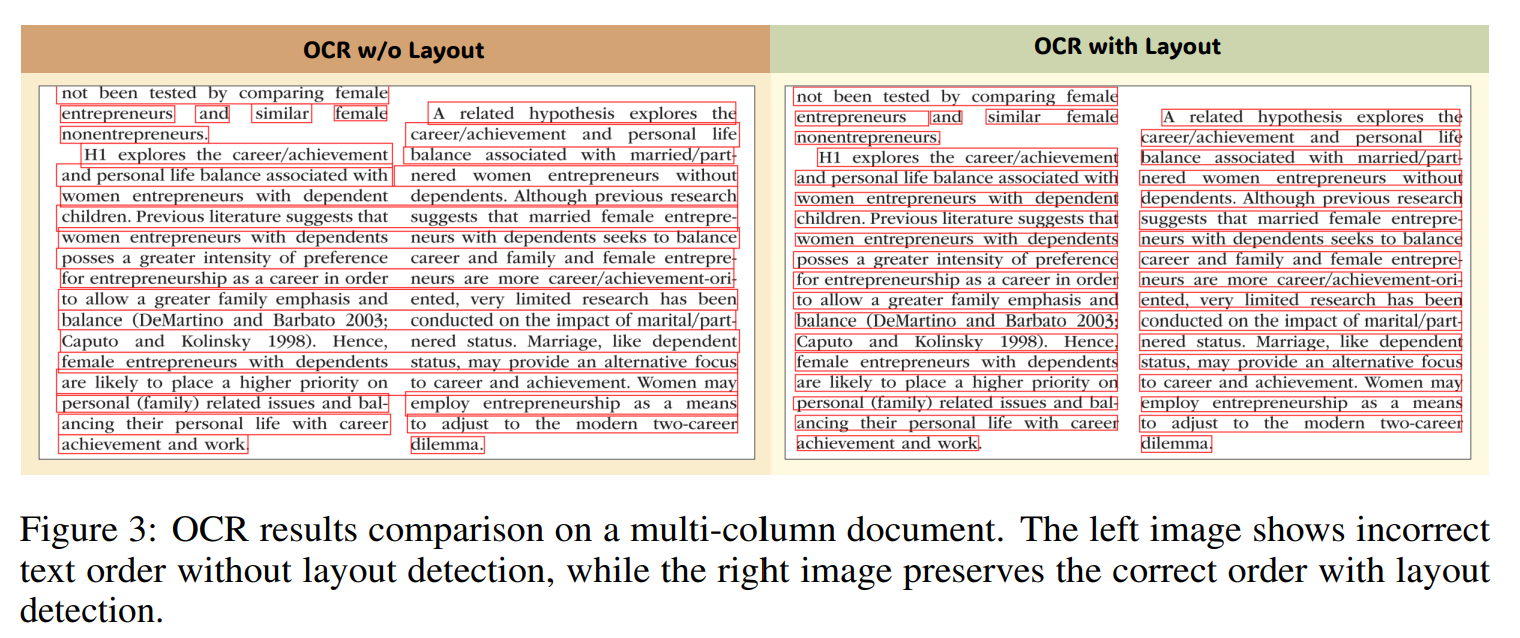
基于版面区域做 OCR
原因:若直接对“整张页面”做全图 OCR,模型经常会把双栏或多栏排版的文本“横向串行”识别为同一栏,导致破坏阅读顺序。
解决方法:MinerU 仅在版面分析检测出的独立文本块(Titles, Text paragraphs)内部执行 OCR,从源头上避免了跨栏混乱。
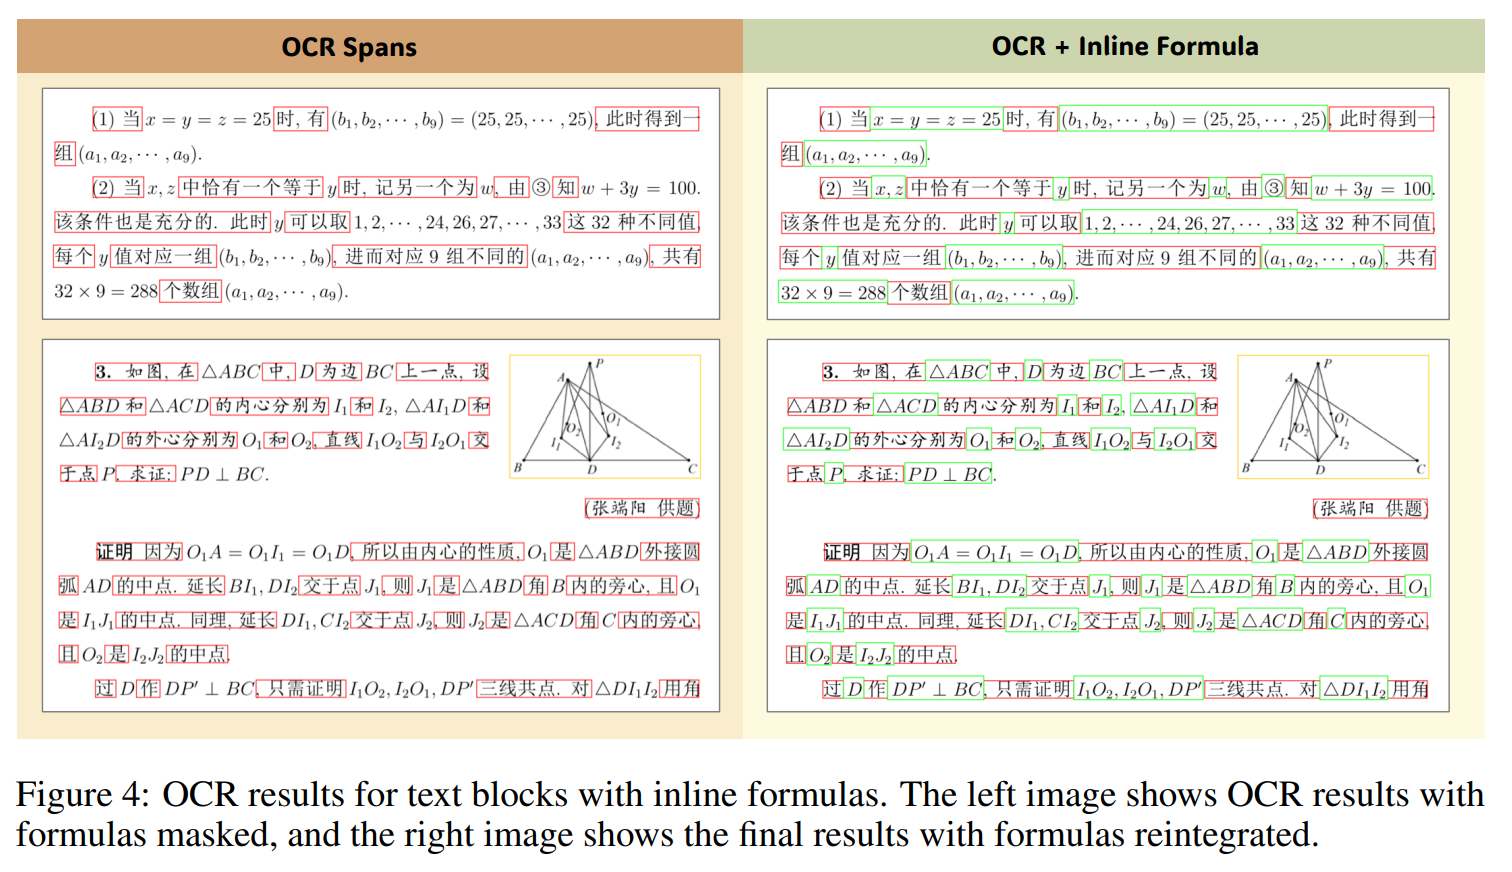
“先遮罩、再识别、后回填” 策略
原因:正文段落中往往夹杂着行内公式,直接做 OCR 会导致公式和文字揉在一起变成乱码。
解决办法:
先利用公式检测模型提供的坐标,将行内公式区域掩盖掉。
对遮罩后的纯文本段落做精准 OCR 识别。
将识别好的行内公式重新插回 OCR 文本的对应位置。
下面两张图片展示了上述两种策略的效果:
2.3 文档内容后处理
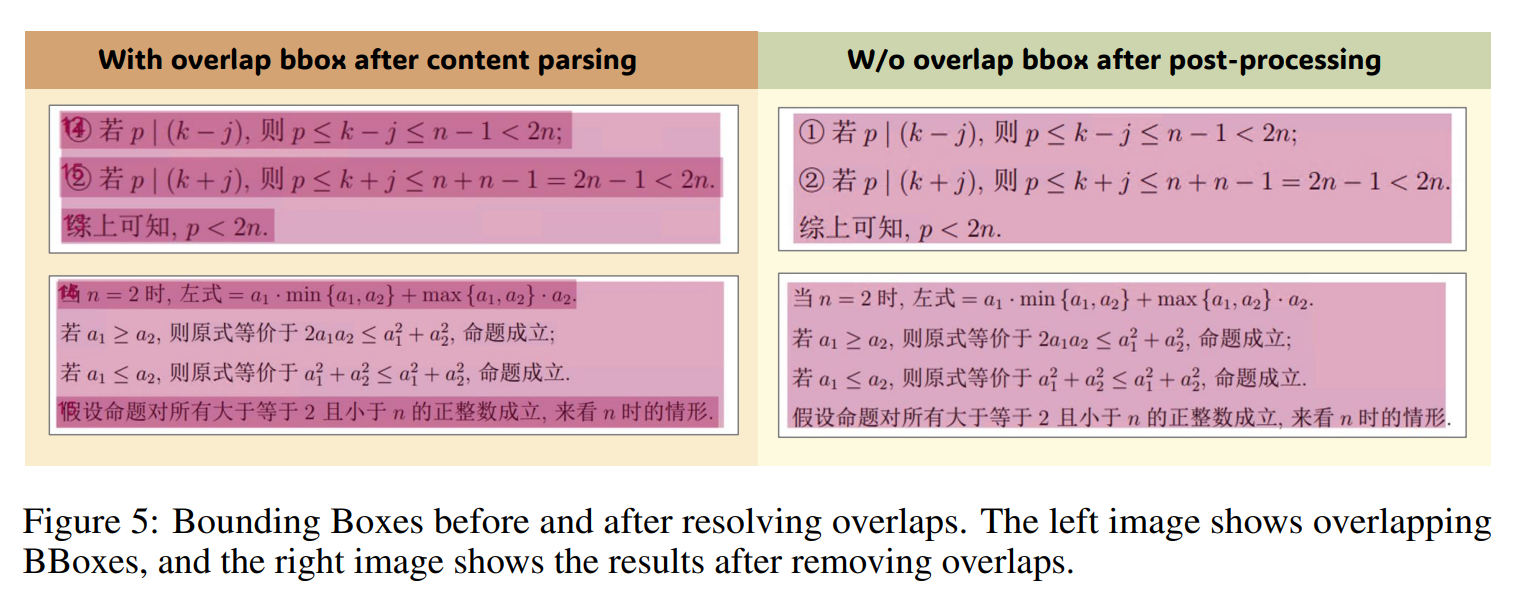
后处理阶段主要解决提取内容的阅读顺序。由于模型输出的文本、图片、表格、公式的边界框(BBox)之间经常存在重叠,且通过 OCR 或 API 提取出的文本行也频繁相互交叉。如果不先解决这些 BBox 的重叠冲突,直接对内容进行排序将非常困难且容易出错。
针对不同类型的 BBox 冲突,MinerU 给出了如下处理方案:
1. 包含关系
图表包含文本/公式:直接删除被包含在图片和表格区域内部的公式与文本框(避免图表内的文字被二次识别产生重复)。
公式框嵌套:直接删除被包含在公式框内部的其他小框。
2. 部分重叠关系
文本框与文本框部分重叠:对交叠的文本框在水平和垂直方向上进行微调收缩,消除覆盖,确保位置和内容不受影响,同时为后续排序铺平道路。
文本框与图表部分重叠:暂时忽略图片和表格,优先保证文本框的完整性。
在清理完嵌套和交叠的 BBox 之后,MinerU 引入了一套自研的分栏与排序算法:
基本原则:遵循人类自然的阅读习惯——“从上到下,从左到右”(Top to bottom, left to right)。
关键约束(单栏隔离):
算法将整页划分为若干个大区域,每个区域内包含多个 BBox。
核心约束:确保每个大区域内部最多只包含一栏。
消除“跨栏跳读”:通过强制“单栏隔离”,保证了文本在单个区域内部可以安全地按照“从上到下”逐行读取,彻底避免了双栏学术论文中常见的“从左栏第 1 行直接横跨读取到右栏第 1 行”的串行乱序问题。
全局排序:最后按照这些划分好的区域组之间的空间相对位置关系进行排序,确定整个 PDF 中所有元素的最终阅读顺序。
下图展示了消除 BBox 重叠的效果:
下图展示了阅读顺序排序之后的效果:
2.4 格式转换
经过处理的 PDF 数据会被保存为一个中间 json 文件,格式描述如下:
接着,MinerU 的命令行支持以 Markdown 或自定义 JSON 格式作为最终输出。在格式转换阶段,图像、图表等元素可以按需删去。
3. MinerU 质量评估
为了全面评估 MinerU 提取 PDF 内容的质量,作者从两个维度展开评估:
核心内容解析模块的独立评估
评估逻辑:模型推理结果的准确度是决定最终提取质量的关键。因此,团队首先对负责内容解析的 3 个核心模块进行单独测试:
版面检测(Layout Detection)
公式检测(Formula Detection)
公式识别(Formula Recognition)
评估方法:构建了一个多样化的评估数据集,将 MinerU 内部使用的 PDF-Extract-Kit 核心算法组件与目前业界其他的 SOTA 开源模型进行量化指标对比。
多样化文档的端到端人工质量检查
评估逻辑:单模块指标高并不完全等同于最终导出的 Markdown 质量好。
评估方法:通过人工抽样质检,综合评估 MinerU 在处理各种不同类型(如论文、教材、财报、试卷等)真实文档时的最终端到端解析表现。
3.1 多样的评估数据集
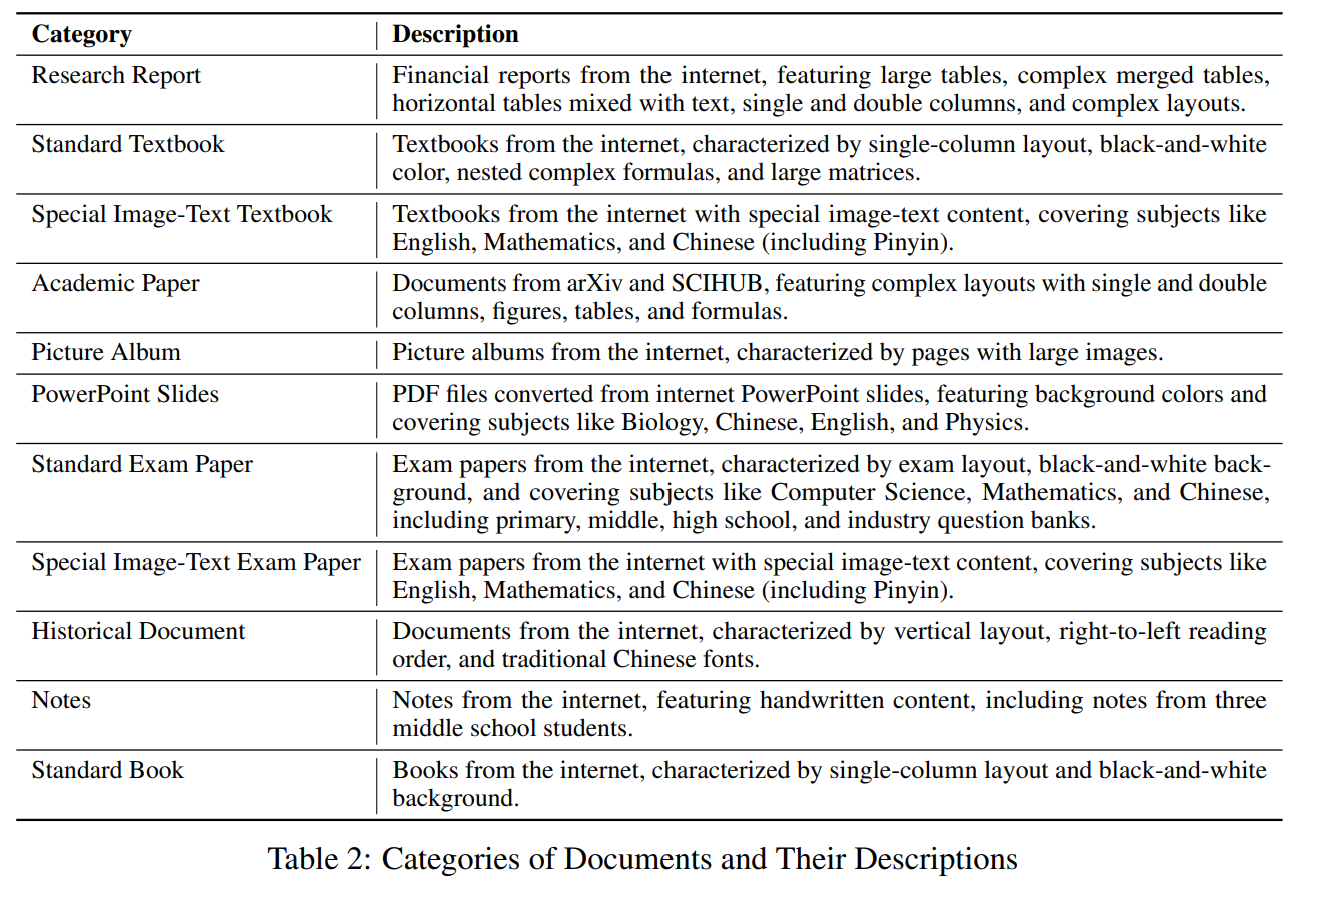
为了衡量 MinerU 在真实场景下的文档内容提取效果,作者构造了一个包含 11 类文档的多样化数据集。具体信息如下表所示:
3.2 核心算法单元的评估
3.2.1 版面检测
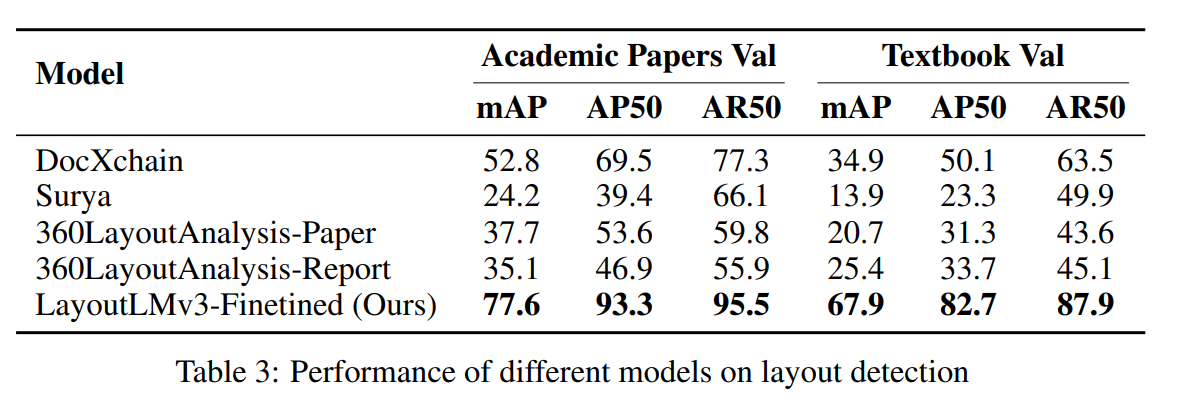
MinerU 采用 LayoutLMv3-base-chinese 作为预训练基座模型,自建的细粒度版面检测数据集上进行了监督微调,最终导出的模型被命名为 LayoutLMv3-SFT 。然后,作者将其与当前开源界主流的 4 个代表性模型(DocXchain, Surya, 360LayoutAnalysis 的两个模型)进行了对比。
初始测试集选用了具备代表性且结构复杂的两类文档:
学术论文验证集:多栏、多公式、多标题层级。
教材验证集:图文混排、多图表注释、排版多样。
实验结果如下:
3.2.2 公式检测
MinerU 的公式检测模型基于经典的 YOLOv8 目标检测架构,使用前面构建的多样化公式检测训练集进行了专门微调,并选取了主流开源公式检测模型 Pix2Text-MFD 作为对比基准。
作者采用学术论文页面+多源文档页面构成评估数据集。实验结果如下:
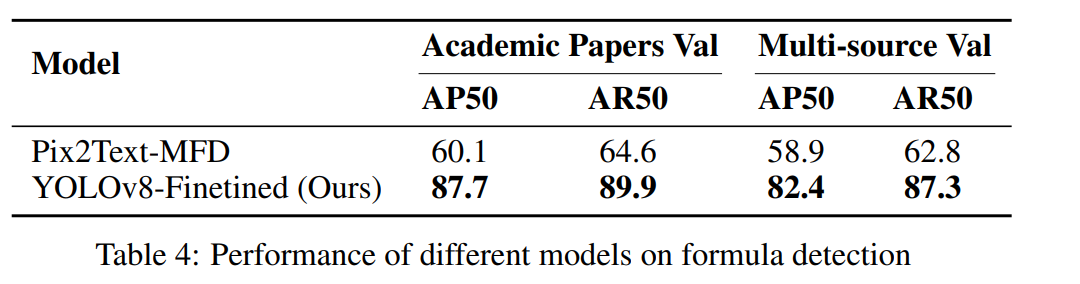
可以看到,在多样化数据上微调的 YOLO-Finetuned 模型,检测性能显著超越了先前的开源模型 Pix2Text-MFD 。
3.2.3 公式识别
为了在面对各种样式(印刷体、扫描体、手写体、行内/行间等)的复杂公式时获得鲁棒的识别结果,MinerU 选用了 UniMERNet 作为其公式识别模型。由于同样的公式可能有多种表达方式,为了公正客观地评估识别效果,作者采用了 CDM 指标来衡量公式识别的真实表现。下面是实验结果:
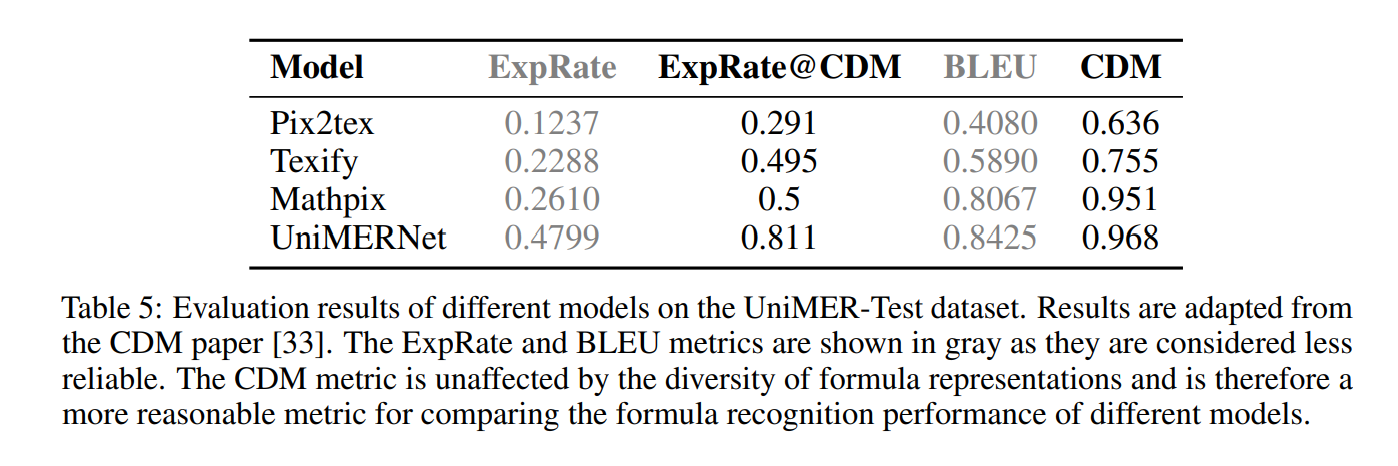
UniMERNet 的公式识别能力远超其他现有的开源模型,其识别精度已达到了与行业标杆级别的商业软件 Mathpix 相媲美的水平。
3.3 端到端的结果可视化与分析
要保证 MinerU 最终输出内容的品质,单靠前面 3.2 节评估的“模型推理准确度”是不够的,必须配合后处理:
关键后处理动作:
剔除噪声内容:过滤掉页眉、页脚、页码等无关干预。
模型输出缝合:将版面、OCR、公式等不同模型提取出的零散结果拼接在一起。
后处理的价值:保障了最终导出的文档结果的可读性与准确性。
下面是端到端的结果展示:
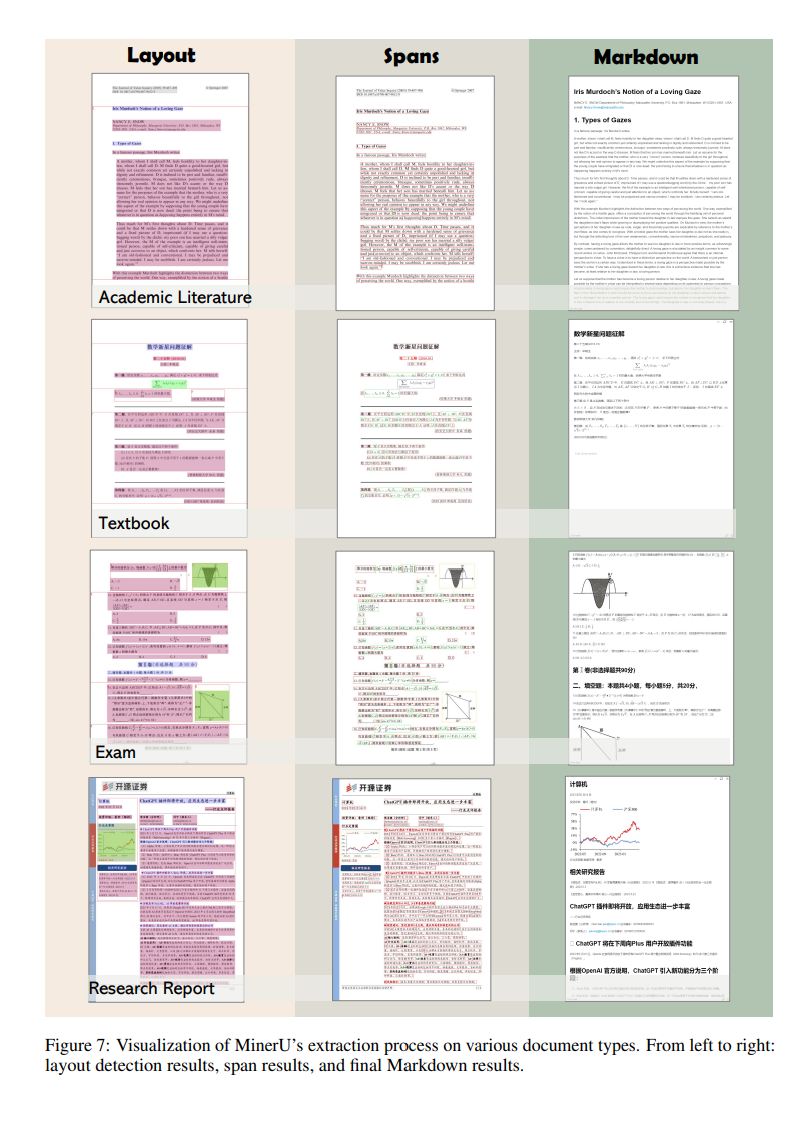
可以清楚地看到三层递进的解析能力:
宏观版面定位:版面检测结果能够精确定位文档中的各个不同区域。
微观片段识别:公式检测与 OCR 文字识别在细粒度片段上的表现令人满意。
最终结构缝合:所有被正确识别的元素最终被无缝缝合,生成高质量的 Markdown 结构化文档。
4. 结论与未来展望
在这项研究中,作者提出了 MinerU —— 一个一站式 PDF 文档提取工具。得益于高质量的模型推理结果以及细致的预处理和后处理操作,即使在处理多样化的文档类型时,MinerU 也能保证高质量的提取效果。尽管 MinerU 已经展现出显著的优势,但仍有很大的提升空间。作者指出了几个将持续对 MinerU 进行升级的方面:
核心组件的增强:迭代更新 PDF-Extract-Kit 中的现有模型,以进一步提升对多样化文档的提取质量。此外,还可以引入新的模型(如专门的表格识别和阅读顺序模型),以增强 MinerU 的整体能力。
易用性与推理速度的提升:进一步优化 MinerU 的处理流水线,以提高文档提取速度并增强易用性。此外,还可以部署更高效的在线推理服务,以满足用户的实时需求。
系统化基准测试的建设:建立针对多样化文档的系统化评估基准,以便清晰地将 MinerU 的结果与 SOTA 的开源方法进行对比,帮助社区用户选择最适合其需求的模型。