

今天研读:《ColPali: Efficient Document Retrieval with Vision Language Models》
开源实现:ColPali
1. 为什么要引入 ColPali ?
文档检索将用户的查询与给定语料库中的相关文档进行匹配,它在许多工业应用中扮演非常重要的角色,可以作为独立排序系统(如搜索引擎)或者复合系统核心环节(如信息抽取流水线、RAG)。
作者发现,虽然预训练语言模型显著提升了纯文本 Embedding 模型的能力,但在工业实际落地中,主要性能瓶颈并非 Embedding 模型本身,而是前面的“数据摄入流水线”。例如,传统 PDF 提取流水线包含以下步骤:
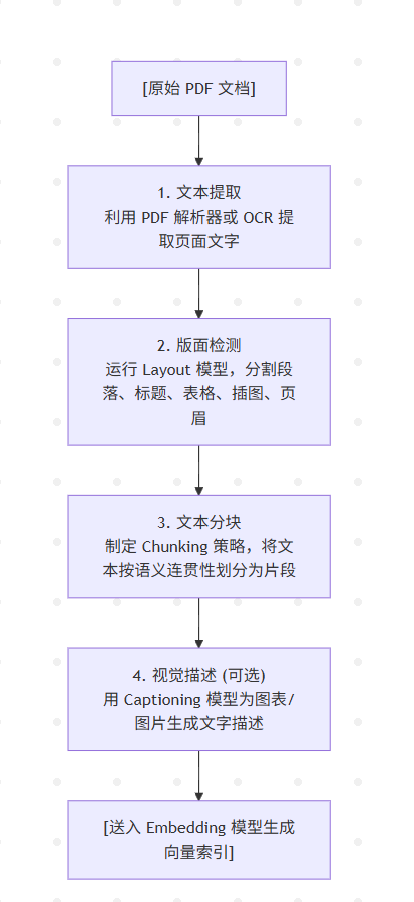
作者在实验中指出,在视觉丰富的文档检索场景中,优化数据摄入流水线带来的性能提升,远比单纯优化文本 Embedding 模型要大得多。
这意味着:如果前面的 OCR、版面切分和 Chunking 提取出来的文字已经错漏百出或丢失了排版信息,后面的 Embedding 模型再强也无济于事。
这项研究一共提出了两项重要的贡献:
贡献一:ViDoRe 评估基准
观点主张:作者认为,评估文档检索系统不应该只看纯文本 Embedding 模型的能力,还必须综合考量文档的上下文与视觉元素。
主要内容:推出了全面公开的基准测试 ViDoRe,用于评估页面级的文档检索能力,涵盖了丰富的领域、视觉元素和语言。
应用场景:在现实中的许多文档查询场景下,查询必须同时理解文本与视觉信息才能实现精准匹配。
发现:暴露了当前“以文本为中心”的系统在这些实际场景中的明显短板。
贡献二:ColPali 模型
核心理念:提出一种基于视觉语言模型(VLM)的全新概念与模型架构,纯粹利用文档的视觉特征来进行索引构建。
匹配机制:结合了晚期交互机制,实现后续的高效快速查询匹配(借鉴了经典检索模型 ColBERT 的思想)。
核心优势:
效果极佳:在 ViDoRe 上显著超越了所有现有的检索系统。
性能优越:速度快,且支持端到端可训练。
行业意义:验证了“在视觉空间中做检索”这一新概念的巨大潜力,有可能彻底改变未来工业界处理文档检索的方式。
2. 问题建模与前人工作综述
2.1 检索系统任务建模
基本任务定义:对于语料库 D 中的文档 d 和用户的查询 q ,检索系统计算一个相关性得分 s(q, d) ∈ ℝ 。通过对得分进行排序,提取出最相关的文档。
需要注意的是,本研究关注 “页面级检索” 。也就是说,“文档” 指的是单个页面,即系统检索的最小原子单元。
针对 RAG 和搜索引擎等大规模语料库场景,系统必须满足严格的时延约束。整个检索流程被拆解为两个阶段:
离线索引阶段:预先构建文档索引。
在线查询阶段:将用户输入的 Query 与索引进行匹配。这一阶段的低延迟对用户体验至关重要。
在上述工业约束下,论文提出了优秀检索系统必须具备的 3 个属性:
2.2 Related Works
2.2.1 传统文本检索方法
本文提出的 ColPali 就是继承了 ColBERT 的这种“多向量 + 晚期交互”思想,只不过把它用在了视觉图像 Token 上。
2.2.2 现有检索系统评估体系的缺陷
忽略预处理流水线:现有的 Leaderboard(如 MTEB/BEIR)主要在测纯文本 Embedding 模型本身,忽略了工业界复杂的预处理(OCR/解析/Chunking)对效果的巨大影响。
忽略视觉信息:纯文本检索系统完全丢失了页面排版、图表、字体等视觉线索。
缺乏通用 Benchmark:虽然以前有针对单一“表格”或“图表”的特定数据集,但缺乏一个端到端、涵盖多领域、能同时考察文本与视觉能力的综合 Benchmark(这也正是本文推出 ViDoRe 的原因)。
2.2.3 将视觉特征整合进模型的技术演进
3. ViDoRe 基准测试
ViDoRe 是一个专门利用视觉特征进行页面级文档检索的综合性评估基准。
3.1 基准测试设计
ViDoRe 的核心评估目标是:在页面级(Page-level)上,全面评估检索系统将用户 Query 与相关文档进行精准匹配的能力。
ViDoRe 包含多个相互正交的子任务,覆盖了以下丰富的维度:
多模态类型:文本、插图、信息图、表格。
多主题领域:医疗、商业、科学、行政。
多语言支持:英语、法语。
此外,ViDoRe 还对难度梯度和评测效率做了特殊设计:
难度梯度:子任务涵盖了不同的复杂度,从而能够同时拉开弱系统和强系统之间的差距。
限制候选文档规模:
原因:部分基线系统(例如基于图像描述 Captioning 的方法)索引构建极慢,处理单张页面可能需要数十秒。
解决办法:限制了每个检索任务中的候选文档集数量,从而保证了即使是流程极其复杂的系统,也能在合理的时间范围内完成评测,且不牺牲评估质量。
对于所有需要训练的检索系统,ViDoRe 提供了一个标准参考训练集,确保了不同模型在微调与对比时的公平性。
可以参考下表以了解 ViDoRe 的详细信息:
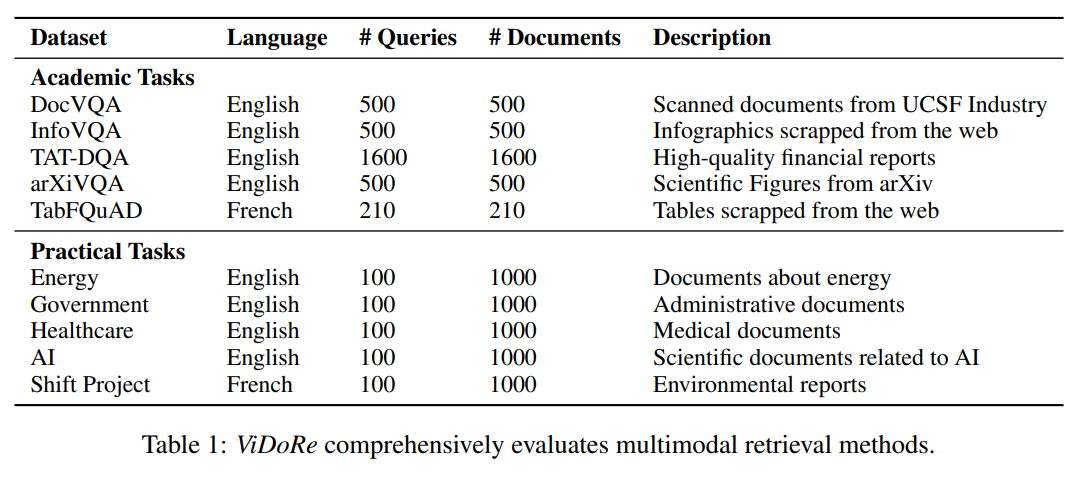
ViDoRe 包含两种任务类型。
学术任务
构建机制:改写现存的视觉问答(VQA)基准。
将原本的 (页面 - 问题 - 答案) 三元组转换用于检索任务:将问题作为输入的 Query,将对应的关联页面作为目标文档。
数据集构成与特点:
一部分来自于专注于单一特定模态的现有数据集。
一部分来自于针对多样化视觉丰富文档的数据集。
新增数据集:包含论文随附发布的 TabFQuAD,这是一个基于法国工业 PDF 文档提取的表格、经人工标注的全新数据集。
实用任务
构建动机:超越简单改写现成 QA 数据集的局限,专门用于评估更真实的工业应用场景(如 RAG)下的检索能力。
构建流程与规模:
文档收集:收集跨多个正交领域的公开 PDF 文档。
Query 生成:使用高性能商业视觉语言模型 Claude-3 Sonnet 针对文档页面自动生成 Query(同时生成对应的答案,用以固定 Query 语义、提升生成质量,并为未来研究留存资源)。
数据规模:每个主题收集 1,000 页文档,配备 100 个 Query。
人工筛选:生成的 Query 经过了人工标注者严格的筛选,以确保质量和相关性。
设计难点与目的:
特意选择主题非常具体的语料库,旨在最大化文档之间的句法相似度,从而制造更具挑战性的检索任务。
ViDoRe 的评估指标:
检索性能评估 (对应 R1)
主要性能指标:以 nDCG@5 作为论文中最核心的性能评估基准。
通用扩展指标:同时计算并报告检索领域的其他标准指标:
nDCG(归一化折减累计增益):衡量排序位置与相关性的匹配质量。
Recall@K(前 K 个结果的召回率):衡量相关文档被检索出来的比例。
MRR(平均倒数排名):衡量首个相关文档出现位置的靠前程度。
数据开源:完整的测试结果集已随模型一同开源发布。
工业实用性评估 (对应 R2 与 R3)
为了验证系统是否符合实际工业落地的约束条件:
在线查询延迟(R2 - Query Latencies):衡量用户发起查询到返回结果的平均响应耗时。
索引构建吞吐量(R3 - Indexing Throughputs):衡量系统在单位时间内能够完成图像向量化(Embedding)的文档页数。
3.2 用 ViDoRe 评估现有系统
我将在 ColPali 建模的相关内容介绍完毕后再来详细介绍实验结果与数据分析
4. 基于视觉检索的晚期交互机制
4.1 ColPali 架构
4.1.1 视觉语言模型
ColPali 的核心思想是:利用视觉语言模型(VLM)在多模态微调过程中获得的“文本 Token 与图像 Token 输出向量对齐”的能力,来直接做文档检索。可以参考下图做直观了解:
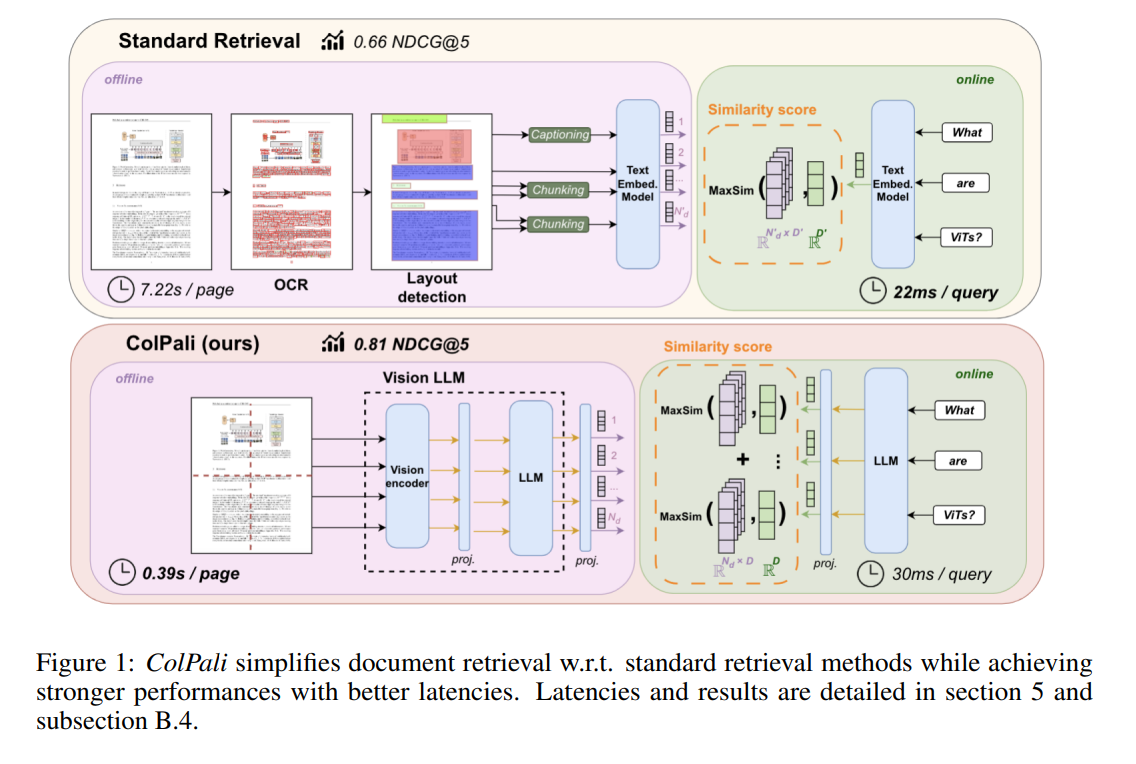
ColPali 选取 PaliGemma-3B 作为基座模型,主要原因是:
轻量高效:参数量仅为 3B,体积小,便于大规模部署与高效推理。
预训练生态丰富:官方释放了许多针对不同分辨率和不同下游任务微调过的 Checkpoints。
文档理解能力强:在各种文档理解基准测试上展现出了极佳的性能。
此外,传统的 PaliGemma 输出维度较高,直接存储多向量索引开销极大。为了保持轻量化的向量袋表示,作者在 LLM 最后一层输出之后,添加了一个线性投影层:
维度压缩:将每一个输出 Token(无论是来自输入的文本 Query Token,还是来自 PDF 页面图片的图像 Patch Token)的向量映射到 D = 128 维。
这直接沿用了 ColBERT 论文设置的经典维度 D = 128 。
不同于把整张 PDF 压缩成 1 个向量的传统做法,ColPali 产生的输出是:
每一个图像 Patch 经过 VLM 编码后,都变成一个 128 维的向量。
一张 PDF 页面图像最终由若干 128 维向量共同组成(即 ColBERT 风格的向量袋(Bag-of-embeddings)表示)。
4.1.2 晚期交互的数学建模
为了方便理解,先整理符号对照表如下:
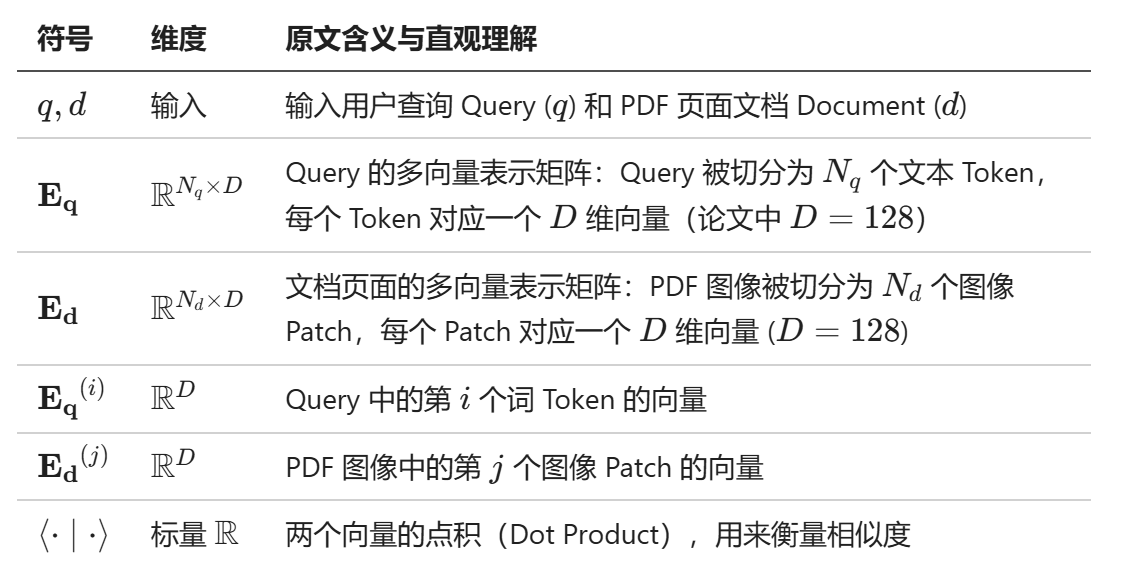
于是晚期交互的得分 LI(q, d) 可以如下表述:
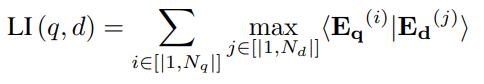
我们可以直观理解这个得分公式的含义:对于输入问询 q 中的每一个 token ,遍历文档页面 d 的每一个 patch 表示,找到与 q 最相关(点积值最大)的 patch 表示,这个 “最大的相似程度” 就是文档页面 d 能 “提供给” 输入问询 q 的这个 token 的相似性得分。把输入问询 q 的每一个 token 的相似性得分累加起来,就是文档页面 d 与整条输入问询 q 的相似程度,即所谓 “晚期交互得分” 。
此外,为什么要把这个方法叫做 “晚期交互” 呢?我们可以对照一下:
早期交互(如 Cross-Encoder):在模型最开始输入时,就把文本和图片的所有 Token 混合在一起算复杂的 Self-Attention。效果最好,但极慢,无法建立向量索引。
单向量双编码器(如 CLIP / DPR):把 Query 压缩成 1 个向量,把整个 PDF 页面压缩成 1 个向量,直接算余弦相似度。速度极快,但损失了图片中的局部细节。
晚期交互(Late Interaction):
离线阶段:Query 和 PDF 图像独立通过 VLM 抽取多向量表示(独立编码,高效建立索引)。
在线检索阶段:只在最后的得分计算时,才对这两组向量做轻量级的 MaxSim 点积匹配(晚期才发生交互)。
直观总结:晚期交互既保持了像双编码器一样的离线向量化与快速检索能力,又保留了像交叉编码器一样的局部细节精准对齐能力,是一种平衡了速度与质量的良好折衷方案。
4.1.3 对比损失
符号对照表如下:
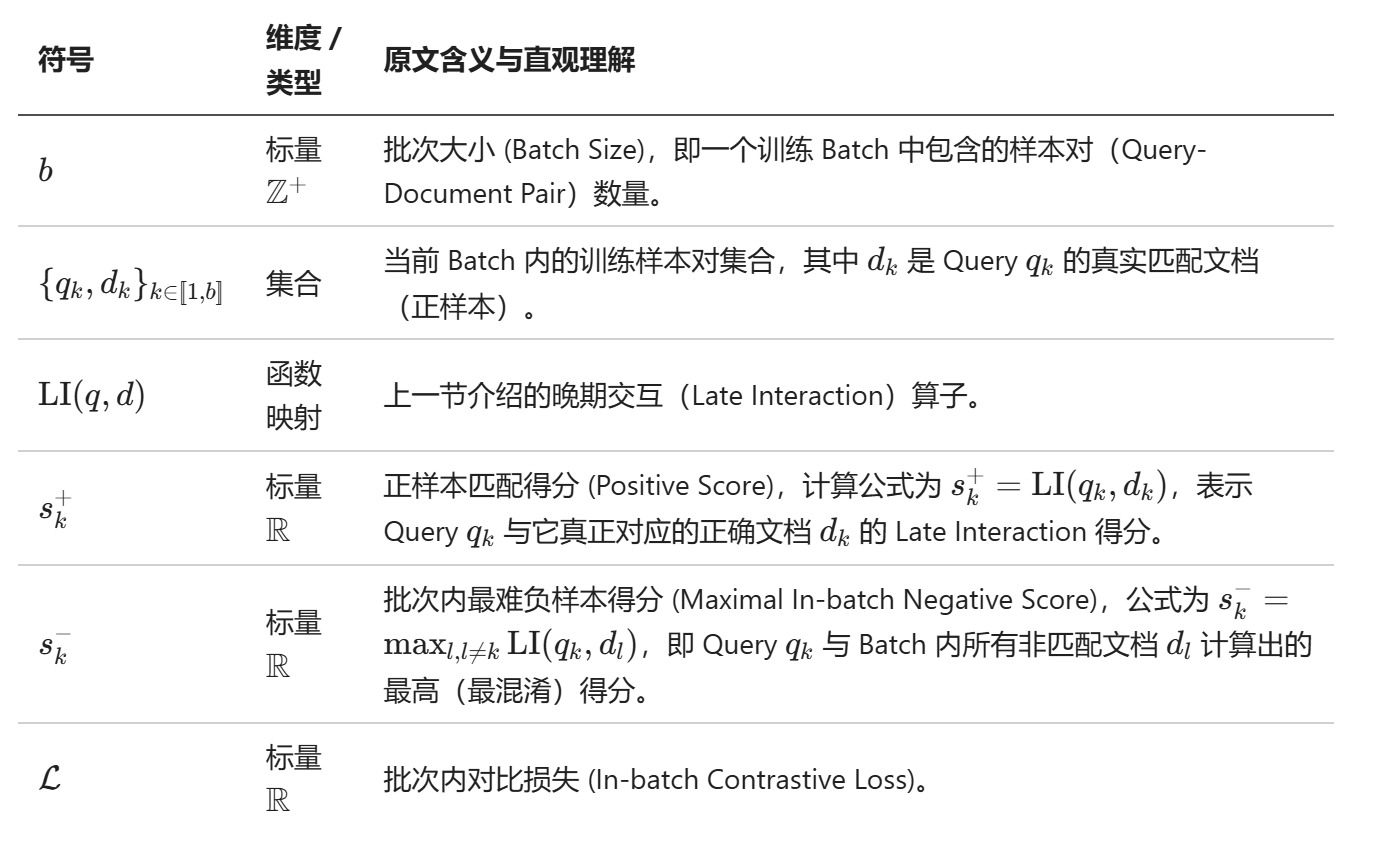
于是批次内对比损失可以如下表述:
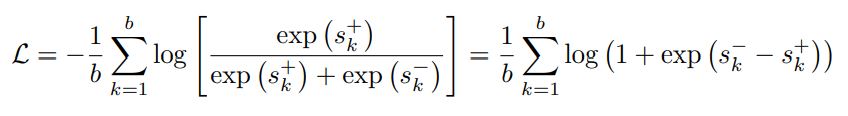
上述公式中,第一个等号的含义是 “将 qk 匹配 dl 视为一个二分类预测问题(匹配正确/错误),则在一个批次内,"预测正确" 的负对数似然的均值,视作对比损失函数” 。这是非常经典的损失函数设计思路。第二个等号则是数学上的恒等变形,可由读者自行推导。
补充:我们可以通过上述介绍,发现几个关键的技术细节:
端到端可微性:作者指出,Late Interaction 算子虽然包含了 max 操作,不过却是可微的。因此,计算得到的梯度可以直接通过反向传播,一路穿透 Late Interaction 算子,更新底层 PaliGemma 视觉语言模型和 128 维 Projection Layer 的所有参数,实现了真正意义上的端到端微调)。
难负样本挖掘:这里并没有把所有负样本都取过来计算 loss ,而是把 “最像正样本” 的那个负样本取来。这就是 “难负样本挖掘” 思想。这强迫模型去重点对抗最容易混淆的负样本,大幅提升了模型对于高相似度干扰项的判别精度。
公式变形:作者做出第二个等号的等价变形,是为了使用框架内置的 Softplus 函数:softplus(x) = log (1 + exp (x)) 。这是因为内置的 Softplus 函数实现了一些工程上的数值稳定性优化,比按照公式手搓更加鲁棒。
4.2 模型训练
4.2.1 数据集
数据规模与构成:训练集总共包含 118,695 个 Query-Page 对,具体分为两部分:
63%:来自于公开可用的学术数据集训练集。
37%:合成数据集,由网络爬取的 PDF 文档页面,配合使用 Claude-3 Sonnet(视觉语言模型)自动生成的伪问题(Pseudo-questions)组合而成。
语言设计与 Zero-Shot 泛化:
训练集完全由纯英文数据构成,用于研究模型对非英文语言的 Zero-shot 泛化能力。
作者在此补充:语言模型 Gemma-2B 的预训练语料库中本身包含多语言数据,且 PaliGemma-3B 在多模态训练阶段也潜在包含了多语言信息。
可以这么理解作者的用意:系统使用的所有模型在在预训练阶段已经掌握了不同语言的语法、语义和文本表征能力。但是微调阶段只使用纯英文来让模型学习本文提出的检索范式。这样在推理阶段,就可以看出,这种 “检索能力” 的获取,到底是对所有语言都存在的(具备 Zero-shot 泛化能力),还是仅对英文这一种语言存在(不具备 Zero-shot 泛化能力)。
防数据污染:
明确进行了人工核实,确保没有任何多页 PDF 文档同时存在于 ViDoRe 基准测试和训练集中,防止测试集污染。
抽取了 2% 的样本作为验证集用于超参数调优。
4.2.2 参数设置
4.2.3 Query 增强机制
具体做法:借鉴了 ColBERT 的做法,在输入的 Query Token 序列末尾追加 5 个 <unused0> Token。
核心作用:这 5 个额外的 Token 在模型训练和匹配中充当一种软性、可微的 Query 扩展(Query Expansion)或重权重(Re-weighting)机制。
5. 实验结果
5.1 检索性能表现(R1 要求)
作者指出,卓越的检索性能来自于以下 3 个因素的叠加:
精心构建的特定任务数据集;
将预训练 LLM 与视觉模型结合,以更好地利用图像中的文本语义;
采用多向量嵌入替代单向量表示,以更好地捕捉文档中海量的视觉信息。
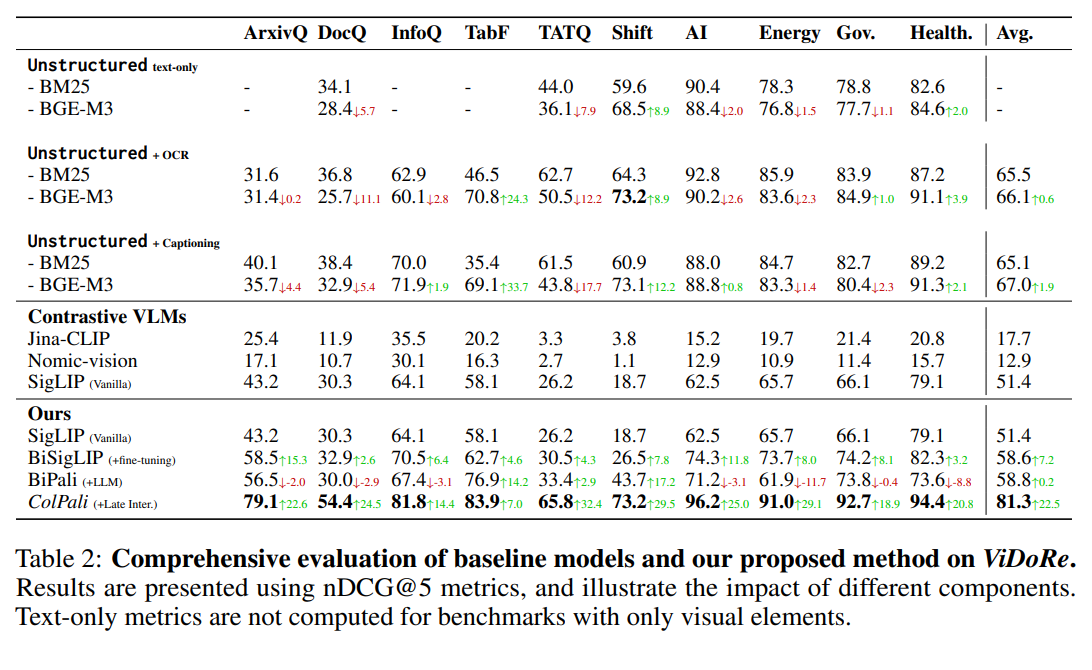
为了验证各个组件的作用,作者通过递进式地演进模型架构(BiSigLIP -> BiPali -> ColPali)进行了对比测试:
补充说明:
将图像 Patch 的 Embedding 送入文本 LLM 是 PaliGemma 的一种技巧,这可以利用文本 LLM 的文本理解能力来增强图像 Patch ,获得上下文感知的图像 Patch Embedding 。这一点在前文中的流程图中已经展示出来。
原始的 PaliGemma 是一个文本生成模型,也就是说,它的预测任务是 Next Token Prediction ,会在得到图像 Patch Embedding 与问询 Token Embedding 之后,共同增强一个生成头,从左往右自回归地生成答案文本。但是作者研究的是检索模型,不需要文本生成,因此这里会去掉生成头,通过一定的算法在问询 Token Embedding 与图像 Patch Embedding 之间做匹配,以检索到与问询最相关的图像信息。BiPali 与 ColPali 的区别就在于这个 “匹配算法” 。如果这里将所有 Patch Embedding 与 Token Embedding 各自通过池化层,压缩为单独的图像 dense 向量与单独的问询 dense 向量,然后做余弦相似度匹配,那么就是 BiPali 。但如果这里不通过池化层(也就是说,一张图像内的每个 Patch 单独保留其 Embedding ,问询内的每个 Token 单独保留其 Embedding ),并通过上面提到的晚期交互算法计算 “晚期交互得分” ,从而检索出 “最相关” 的图像,那么就是 ColPali 。
前面提到过,在 PaliGemma 模型原始的图像处理部分与问询处理部分的两个文本 LLM 后都会各自加一个参数随机初始化的, D = 128 维的投影层,这是为了减小存储与计算开销。
需要注意的是,由于 BiPali 与 ColPali 的预测任务是 “对比学习” ,与预训练基座 PaliGemma 的 “Next Token Prediction” 预测任务不同,因此可能会产生一些冲突。这也是作者将 BiPali 英文表现偏差的现象归因于此的原因。
BiPali 和 ColPali 在微调过程中,视觉编码器(SigLIP 的视觉组件)是参数冻结的。这是为了控制变量(BiSigLIP 只对文本组件进行微调)。那么如果解冻视觉编码器,会对检索效果产生怎样的影响呢?这一点会在后面的消融实验中有研究。
实验结果具体数据如下:
此外,作者还描述了几个结果负面的实验:
5.2 处理时延与内存使用开销
5.2.1 在线查询时延(R2 要求)与离线索引吞吐量(R3 要求)
在线查询时延(R2 要求):
离线索引吞吐量(R3 要求):
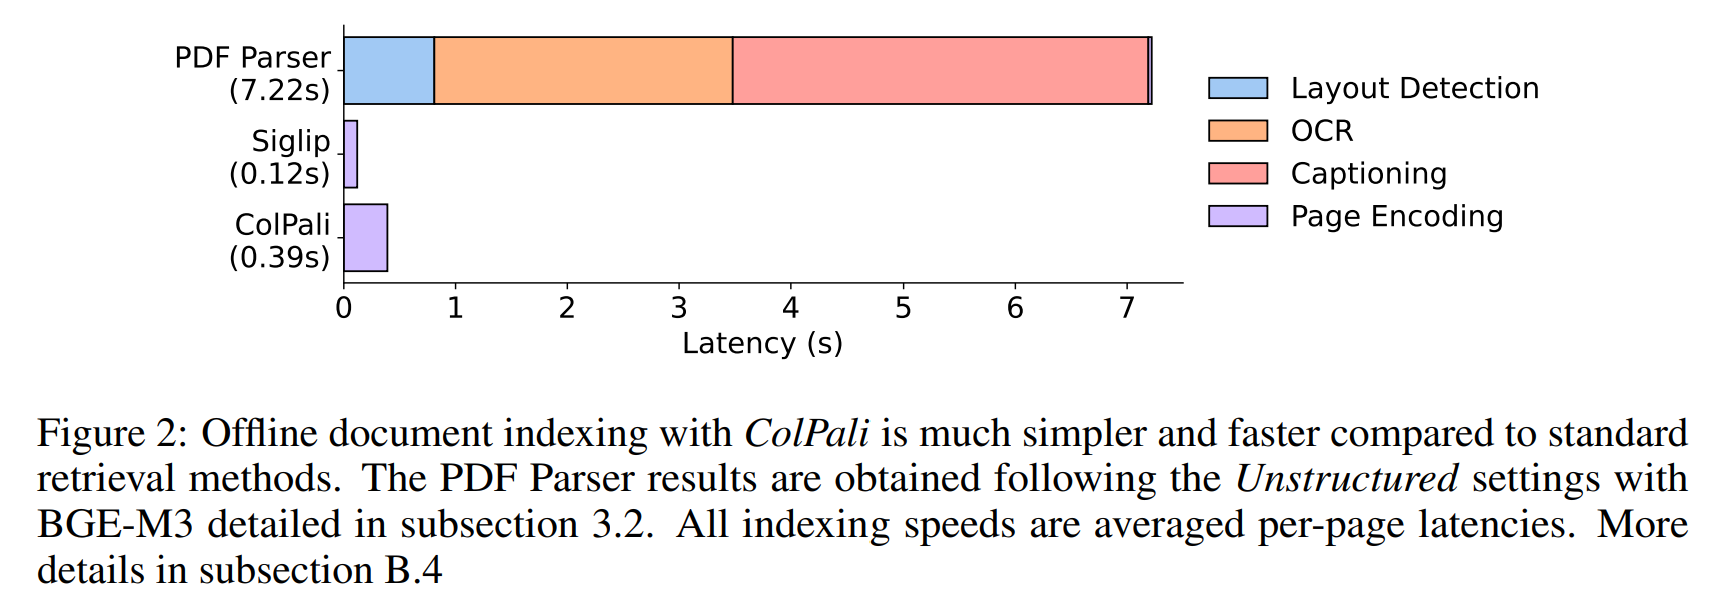
5.2.2 索引存储开销
在每一张图像页面的 Patch 序列后,添加 6 个文本 Token :"Describe the image" ,作为引导 VLM 提取全局图像特征的 Prompt 。每个向量被投影到 D = 128 维,大幅降低了存储开销。作者在具体实践中发现,这种方式处理后,单页存储所占据的空间大小仅有 257.5 KB ,而且在大规模应用场景中,通过添加一些压缩或聚类机制,还能进一步减少存储空间开销。
5.2.3 Token 池化技术
作者通过观察 PDF 文档图片的特性,提出了一种在工程友好前提下大幅削减向量存储与计算开销的轻量化方案 —— Token 池化。
Token 池化能够解决文档图片的“视觉冗余”问题
问题:真实文档图片中存在大量低信息量/高冗余的区域(最典型的就是大片空白背景、页边距、纯色分割线等)。
优化思路:将这些承载冗余信息的 Patch 向量通过池化合并在一起,用少数的复合向量代替原有的多个重复向量,从而达到“保质量、降体积”的目的。
此外,作者特别强调 Token Pooling 是一种 CRUDE-兼容 的方法(即对文档的动态添加与删除非常友好):
Token Pooling 是在单张文档页面内部独立完成的。
这极大地简化了工业级向量数据库的运维成本,随增随删,扩展性极强。
作者在图像 Embedding 上采用了层级均值 Token 池化(Hierarchical Mean Token Pooling),实验结果如 Figure 3 左图所示:
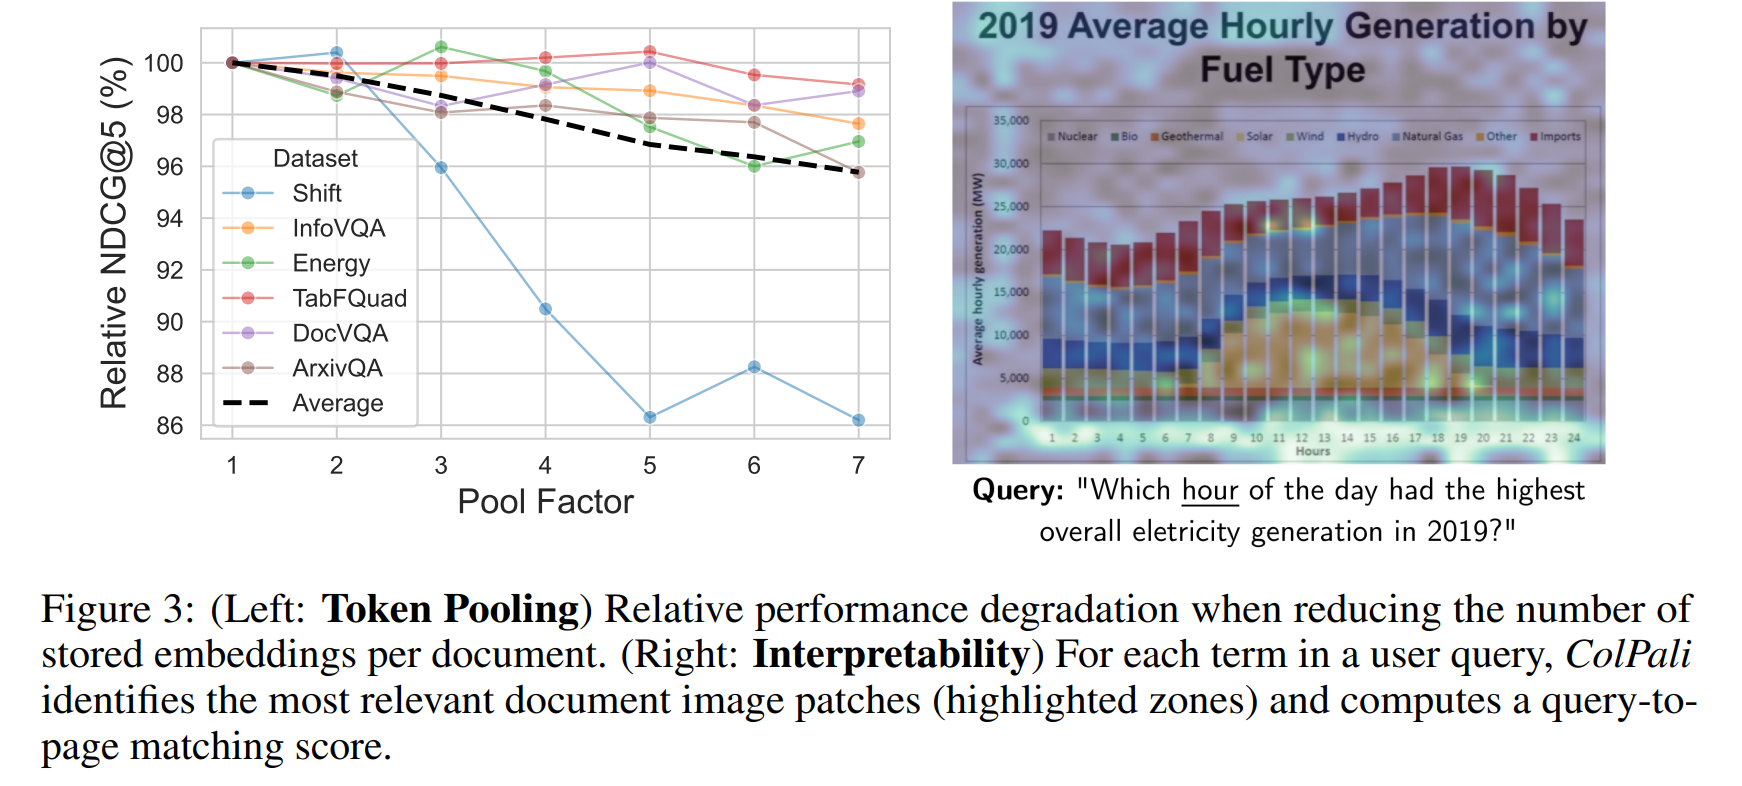
在整体表现优异的背景下,作者专门指出了一个特例—— Shift 数据集:
现象:在该数据集上使用 Token Pooling 时,模型的检索性能出现了比其他数据集更严重的衰减。
归因分析:
数据集特性:Shift 数据集主要由高文本密度文档组成(即页面上密密麻麻全是字,几乎没有大面积空白或无意义区域)。
归因分析:对于信息密度高的文档,冗余的 Patch 比较少,这种池化技巧可能反而会导致一些细节信息损失,从而影响检索精度。
5.3 可解释性
通过将晚期交互热力图叠加在原始图像上方,可以直观展示针对 Query 中每个词项最显著(晚期交互得分最高)的图像 Patch,从而对模型的关注区域(Focus Zones)提供可解释的洞察。
具体观察与验证(以 Figure 3 右图为例):
展现出强大的 OCR 能力:图像中的单词 “hourly” 和 “hours” 均与 Query Token <_hour> 展现出高相似度得分。
关注非平凡图像特征:模型还会特别关注图像中的其他特殊图像特征,例如图中代表小时的 X 轴 也被显著关注。
6. 消融研究
作者开展了消融实验以深入理解每个组件的作用。在消融研究中,作者汇报所有 ViDoRe 任务上的平均 nDCG@5 值。
模型大小与图像 Patch 数量之间的权衡关系
作者通过这组消融实验证明,在构建多模态文档检索系统时,必须在以下四个维度之间做取舍:
检索性能 (R1):取决于 Patch 数量与 LLM 能力的综合叠加;
在线查询延迟 (R2):底层 LLM 越小(如 2B),查询响应越快;
离线建库延迟 (R3):LLM 尺寸与 Patch 数量共同决定了建库吞吐量;
索引存储开销 (Memory Footprint):单页 Patch 向量数量越少,维度越低,存储开销越小。
解冻视觉组件
作者做了一个 ColPali 的实验变体,在训练阶段将视觉编码器(SigLIP)也解冻参与微调。但却发现,检索性能出现了轻微下降(−0.7 nDCG@5)。作者没有给出归因解释,并指出,随着训练数据规模的扩大,这一结论在未来可能会发生改变。
“问询增强” Token 的作用
前文提到过,本研究参照了 ColBERT 的方法,在输入问询的末尾添加了几个特殊 Token 作为 “问询软增强 Token” 。作者尝试去掉这几个 “问询增强” Token ,再开始训练,发现模型在英文基准测试上没有明显表现变化,但是在法语数据集上貌似反而有不小的性能增长(+9.8 nDCG@5 on Shift, +6.3 nDCG@5 on TabFQuAD)。
困难负样本挖掘的作用
作者尝试用批次内所有负样本参与对比损失计算,发现检索性能微微下降(−1.6 nDCG@5),这证明了困难负样本挖掘的作用。
模型对新任务的迁移能力
作者指出,ColPali 是端到端训练的模型,因此能平滑适应下游任务场景。为了验证这一点,作者往训练集中添加了 1552 条法语表格以及相应问询,并在 TabFQuAD 基准测试上观察到了不小的性能提升(+2.6 nDCG@5, +5 Recall@1),其余基准测试上也未见性能下降(整体 +0.4 nDCG@5)
更好的视觉语言模型带来的检索性能增长
作者开展了实验变体 ColQwen2-VL ,视觉语言模型部分采用了最新发布的 SOTA 生成式模型 Qwen2-VL 2B ,同时将图像页面 Patch 数设置为 768 (比 ColPali 的 1024 Patches 略少一些,这是为了满足 ColPali 的内存限制)。作者观察到了较大的性能提升(+5.3 nDCG@5)。这也展现出了生成式任务基准上的性能提升与检索任务基准上的性能提升具备明显的关联。
域外泛化能力
作者为了验证模型的高性能是否依赖于训练集与测试集之间的分布重合,设计了一组严谨的控制变量实验,证明了 ColPali 具备极强的跨域泛化能力。
7. 结论与未来展望
结论
在本研究中,作者提出了视觉文档检索基准(ViDoRe),用于在包含复杂视觉特征文档的真实场景下评估文档检索系统。作者证明了当前的检索流水线和对比视觉-语言模型难以高效利用嵌入在文档中的视觉信息,从而导致性能不够理想。为了解决这一问题,作者提出了 ColPali,这是一种新型检索方法,它利用视觉-语言模型纯粹从文档的视觉特征中生成高质量的多向量嵌入。ColPali 大幅超越了现有的最佳文档检索方法,同时实现了更快的语料库建库/索引时间,并保持了低查询延迟,从而避开了现代文档检索应用中的许多痛点。
未来展望
除了通过更好的数据、主干模型或训练策略来获取性能提升之外,作者还指出了一个值得长期探索的方向:将视觉检索系统与基于视觉锚定的问答(Visually Grounded Query Answering)相结合,构建纯粹基于图像特征运行的端到端 RAG 系统。这一设想得到了同期工作(MMLongBench-Doc)的支持,该工作展现了 VLM 在视觉问答领域的巨大潜力,并且这最终可能成为文档处理领域的新工业标准。
这一研究方向的核心是可靠性。信息检索方法的置信度估计技术可能会成为实现弃权/拒绝回答机制(Abstention Mechanisms)的关键。鉴于晚期交互系统具备信息丰富的多向量打分机制,这一方向显得尤为值得探索。此外,扩展基准测试以覆盖更多语言、模态和任务,也是未来一个至关重要的研究方向。