

对数据源的预处理是 RAG 系统在工程落地时所必须考量的一项基础设施。
今天研读 《Docling Technical Report》
开源模型:Docling
文档与示例:Github
1. Docling 是什么?为什么要引入 Docling ?
将 PDF 转换为一种机器可处理的形式一直是一大难题。因为 PDF 格式多样、缺乏标准化,且其设计最初是面向打印优化(printing-optimized)的,因此抛弃掉了大部分结构特征和元数据。但是,随着 LLM 和 RAG 模式的兴起,高效利用 PDF 中的丰富内容变得前所未有地重要。
现有的强力文档理解工具大多是商业软件或云端服务。开源工具极少,且在功能和质量上与专有/商业方案有显著差距。因此作者提出了 Docling ,它构建在专用的版面分析和表格结构识别 AI 模型及数据集上。
部署门槛:
纯 Python 库
许可协议宽松
完全本地运行,仅需普通消费级硬件
架构易于扩展新功能和新模型
Docling 的 6 大核心能力:
格式转换:快速稳定地将 PDF 转换为 JSON 或 Markdown。
结构理解:理解详细的页面版面、阅读顺序,定位插图(figures),还原表格结构。
元数据提取:提取标题、作者、参考文献、语言等。
可选 OCR:支持扫描件 PDF 的文字识别。
两种运行模式:
批处理模式(batch-mode):高吞吐量、低单文档解算时间。
交互模式(interactive mode):在效率上做适当妥协,追求极低延迟/快速响应。
硬件加速:支持 GPU、MPS 等不同加速器。
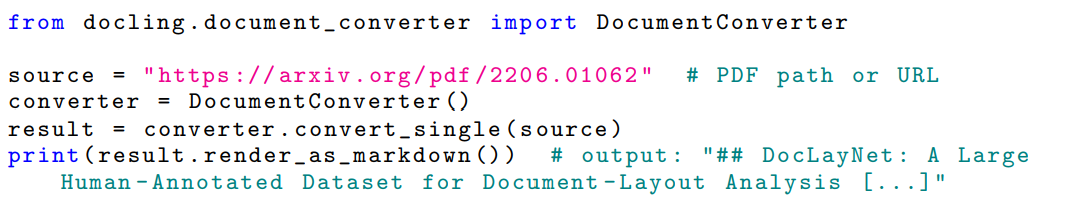
使用 Docling 的代码示例:
2. Docling 结构概述
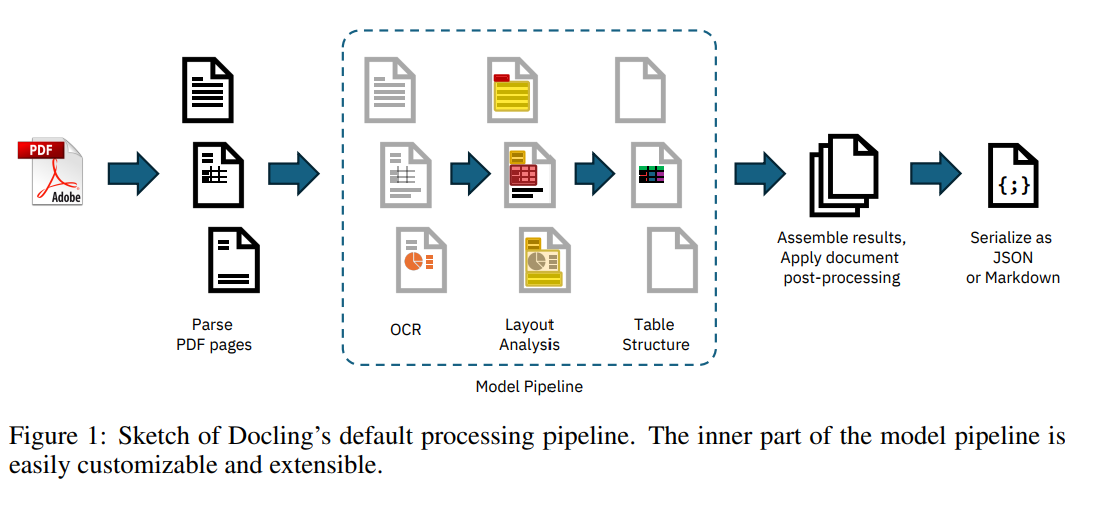
Docling 的处理流水线可以概括为如下形式:
阶段一 - PDF 后端解析:后端不仅抓取文本内容及其在页面上的坐标,还会把每一页渲染成位图图像。
阶段二 - 标准模型流水线:一系列 AI 模型逐页独立运行,抽取版面结构和表格结构等特征与内容
阶段三:聚合与后处理:将每一页各自处理的结果合并到一起,然后做后处理增强:
补充/增强元数据。
检测文档语言。
推断阅读顺序(注意:阅读顺序是在聚合阶段才根据全局/跨页信息推断出来的)。
最终产物:组装成统一的强类型文档对象,最后序列化为 JSON 或 Markdown。
2.1 PDF 后端
Docling 的 PDF 后端接口封装了流水线处理需要的两个最基本能力:
文本与坐标提取:检索每页所有的文本内容及其在页面上的几何坐标。
视觉图像渲染:将每个页面渲染为像在 PDF 阅读器中看到一样的视觉图像。
作者指出,尽管 Python 生态中存在多个开源 PDF 解析库,但它们在实际应用中遇到了无法克服的障碍:
为了解决上述问题,Docling 采用了多后端策略,并自研了全新的解析器:
默认后端:自研 docling-parse
底层基础:基于低层级的 qpdf C++ 库构建。
发布形式:作为一个独立的开源 Python 包发布。
定位:作为 Docling 默认使用的 PDF 后端,兼顾性能与解析质量。
备用后端:基于 pypdfium 的替代接口
定位:作为安全备用方案。
适用场景:当使用默认后端遇到特定字体编码解析异常等边缘问题时使用。
2.2 AI 模型
Docling 流水线中集成了三大 AI 模块(版面分析、表格识别、OCR):
版面分析模型
定位:目标检测器,用于预测页面元素的边界框和类别。
模型架构:衍生自 RT-DETR,基于人类标注数据集 DocLayNet 及其他专有数据集进行了重训练。
推理引擎:使用 onnxruntime 进行推理。
后处理与图文结合逻辑:
依据置信度和尺寸去除重叠的框。
求交集:将预测出的边界框与从 PDF 提取到的文本 Token 进行求交集计算,从而将散落的 Token 组合成段落、章节标题、列表项、图注、插图或表格等完整语义单元。
表格结构识别模型(TableFormer)
定位:基于 Vision-Transformer 的表格结构恢复模型,可预测表格的逻辑行列结构,并判定单元格属于表头(列头/行头)还是表体。
复杂场景应对:能很好地处理无/半边框、空白单元格/行列、跨行跨列(Cell spans)、多层级表头以及对齐/缩进不一致等复杂表格。
推理引擎:使用 PyTorch 进行推理。
核心效率优化:
避开二次 OCR/重转录:将 layout 截取的表格图片与页面原有文本单元一同输入模型,得到结构预测后,直接将结构映射回 PDF 原有的文本单元,避免了对表格图像内容重新识别/转录的高昂开销。
OCR 扩展模块
定位:针对扫描件 PDF 或页面嵌入的位图图像。
默认引擎:集成了第三方库 EasyOCR。
现状:由于使用较高分辨率(216 dpi),虽然保证了小字号的识别质量,但 CPU 运行较慢(每页可能耗时 30 秒以上)。
相关数据对比:
2.3 答案组装阶段
该阶段负责将前面各页面的预测结果整合为一个结构化的文档对象,并通过后处理算法进行增强,最终导出为用户指定的格式。
步骤一 - 页面结果汇总与封装
Docling 在这一步会将各页面预测结果汇总到一个结构良好、类型明确的文档对象数据类型,该数据类型的具体定义封装在辅助 Python 包 docling-core 中。
步骤二 - 后处理模型与算法增强
生成文档对象后,流水线会将其送入后处理模型,利用多种针对性算法完成特征增强工作,例如:
语言检测:识别文档所使用的语言。
阅读顺序纠正:重新梳理并校正文本内容的实际阅读逻辑顺序。
图文配对:将插图与其对应的图注(Captions)进行关联匹配。
元数据打标:提取并标注文档的标题、作者、参考文献等元信息。
经过后处理增强的文档对象,可依据用户指令导出为两种主要格式:
JSON:进行完整的数据结构序列化(适合程序读取与下游 RAG 等开发)。
Markdown:转换为易读的排版文本格式(适合大模型上下文输入与文档预览)。
2.4 可扩展性
开发者可以对 “AI 模型 Pipeline ” 这一部分做灵活的自定义工作。
有两种自定义方式:
继承抽象基类 BaseModelPipeline 进行全新开发。
克隆并修改默认的模型流水线。
可定制内容:
重构模型调用链。
替换已有模型或加入新的 AI 模型。
增加额外的流水线配置参数。
使用方式:在调用 Docling 的主转换方法时,直接将自定义的流水线类作为参数传入即可。
这里作者强调了代码实现上的规范:
Python 接口要求:模型类必须实现 Callable 接口(即定义 __call__ 方法)。
输入/输出范式:
输入:接受一个包含页面对象(page objects)的迭代器(Iterator)。
输出:生成/返回另一个包含页面对象的迭代器。
数据承载方式:模型在预测出新的特征/内容后,通过扩展页面对象中自带的 PagePredictions 数据模型,将结果装载并传递给下游。
3. 实验表现
为了保证实验的可复现性,作者在标准测试集上测试了不同硬件与线程下的性能表现:
测试数据集:包含 3 篇 arXiv 论文 + 2 本 IBM Redbooks,共计 225 页。
测试变量:
两种 PDF 后端:默认自研的 docling-parse 与备用的 pypdfium。
两种硬件平台:
移动端/个人终端:MacBook Pro M3 Max
服务器端:Ubuntu 20.04 LTS Bare-metal 服务器(配备 Intel Xeon E5-2690 CPU)
线程数控制(通过环境变量 OMP_NUM_THREADS 固定):
4 线程:Docling 的默认设置。
16 线程:对应测试硬件的满核数(Full core count)。
实验结果如下表:
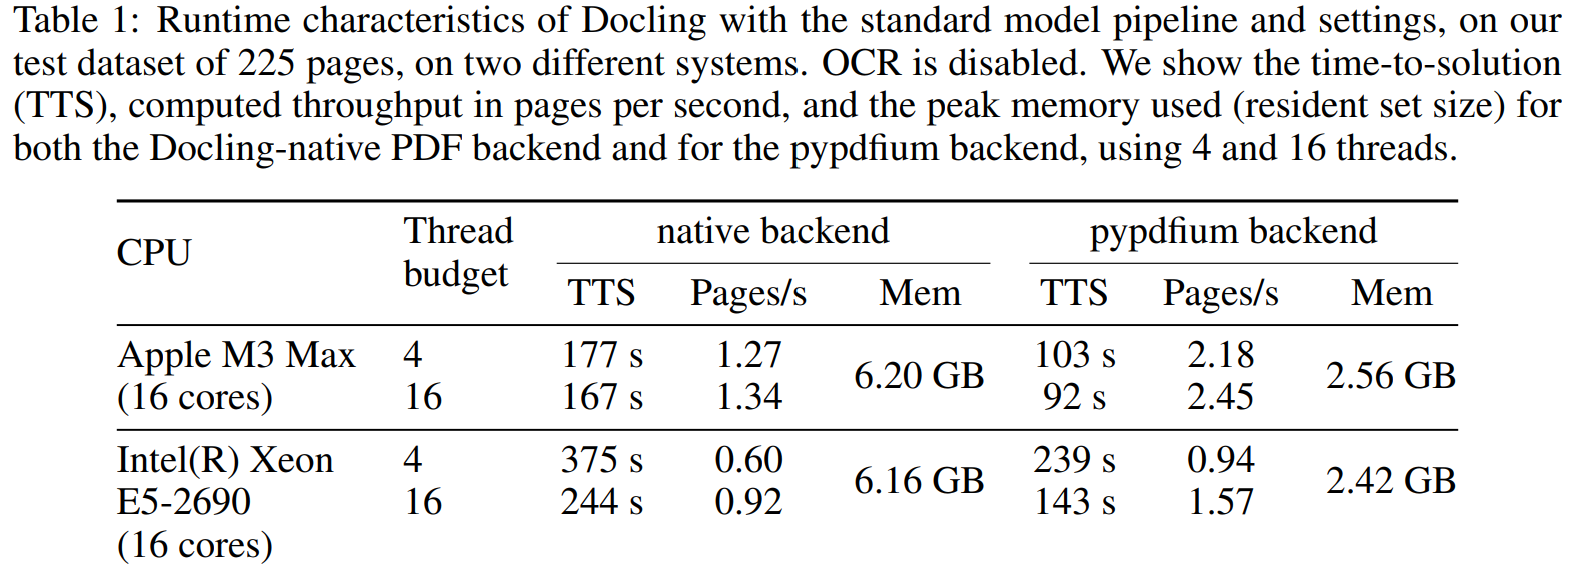
对于资源极其有限的部署环境,作者给出了明确的权衡建议:
推荐方案:切换至 pypdfium 后端。
优势:运行速度更快,且内存占用更低。
代价:解析质量会下降,特别是在表格结构恢复上的效果会有明显折扣。
4. 应用场景
作者提出了以下几种 Docling 的应用场景:
企业级搜索与知识提取
优势:由于 Docling 能识别表格、插图、章节结构和参考文献等不同元素,企业可以对文档中的不同结构进行差异化/针对性处理。
应用:企业级文档搜索、段落检索以及文档分类任务。
生成式 AI 与 RAG 生态
配套工具 quackling:团队推出了配套开源包 quackling,利用 Docling 提取的丰富特征,实现文档原生优化的向量嵌入与文本分块。
框架对接:可无缝集成到主流大模型开发框架中(如 LlamaIndex)。
自动化知识库与数据集构建
成本与效率优势:由于 Docling 运行速度快、稳定性高且运行成本低,非常适合用来批量处理海量文档以构建衍生数据集。
表格识别赋能:强大的表格结构识别能力为自动化知识库构建提供了核心支持。
大规模多模态数据预处理
工程集成:Docling 已集成进开源的 IBM Data Prep Kit 中。
用途:实现可扩展的数据转换,用于构建大规模多模态大模型训练数据集。
5. 未来展望
作者提到了几个未来可以探究的方向:
扩展更多模型,例如插图分类模型、公式识别模型、代码识别模型等。这将有助于提升特定类型内容的转换质量,并利用额外信息丰富所提取的文档元数据。
进一步投入测试与优化 GPU 加速的性能效果。
改进 Docling 原生的 PDF 后端。