

今天研读《Corrective Retrieval-Augmented Generation (CRAG)》
开源实现:CRAG
有关标准 RAG 的内容,可以参考我的分享贴:《RAG 学习专题 Day 1 —— RAG 是怎样诞生的 ?》
有关 Self-RAG 的内容,可以参考我的分享贴:《RAG 学习专题 Day 6 —— RAG 也要“吾日三省吾身”吗?》
1. 为什么要引入 CRAG ?过往的研究有什么不足?
纯粹的 LLM 由于仅仅依赖其参数化记忆,常常产生幻觉。RAG 技术虽然能缓解这一现象,但是传统的 RAG 技术非常依赖检索到的文本的质量。一个低质量的检索器很可能会检索到一大堆和用户问询完全不相关或低相关的文本,从而误导模型,使模型生成低质量甚至带有幻觉的回答。此外,传统的 RAG 技术对于检索到的所有文章一视同仁,并不区分相关性。然而事实上,检索到的文本中有很大一部分对于生成答案并没有太大的帮助,不应当被 RAG 系统同等重要地看待。
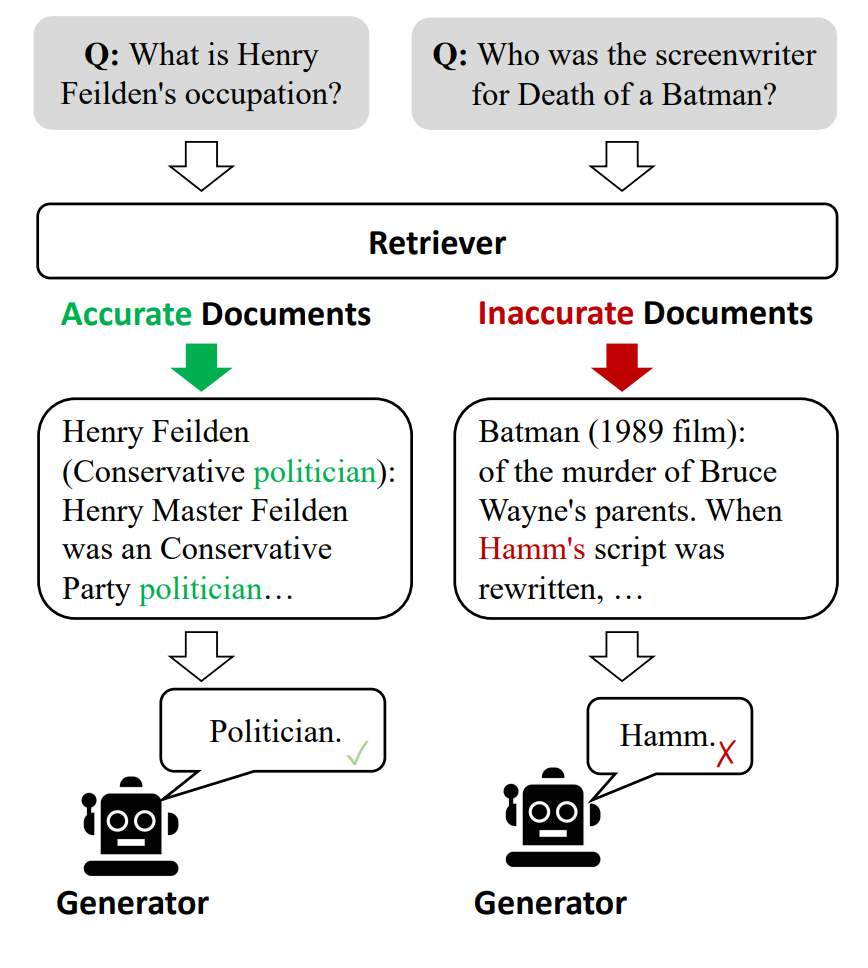
下图展示了一个低质量的检索器对生成器的误导效果:
基于此,作者提出了基于纠错的检索增强生成方法(Corrective Retrieval-Augmented Generation, CRAG),它能够自我纠正检索器返回的检索结果,并提升生成器对检索文本的利用效果。下面介绍其重要组件与流程:
轻量级检索评估器
定位:CRAG 系统中的关键组件,用于审查和评估检索文档的相关性和可靠性。
工作方式:量化出一个置信度,并根据置信度触发三种不同的知识检索动作):
Correct(正确)
Incorrect(错误)
Ambiguous(模糊/不确定)
引入大规模网络搜索
触发条件:当评估器判定动作属于 Incorrect 或 Ambiguous 时触发。
目的:由于静态和有限的本地语料库在覆盖范围和多样性上只能返回次优文档,因此利用网络搜索的广阔性与动态性作为战略扩展,来补充和丰富初始检索到的文档。
“分解-重构”算法
目的:消除检索文档中包含的冗余上下文,提高数据利用率。
工作方式:精细化提炼检索到的信息,最大化提取关键见解,同时最小化非必要元素的引入,避免无用内容污染生成的上下文。
CRAG 作为一种即插即用的方案,实验中被分别集成到了 标准 RAG 和 Self-RAG 中,以展示其对不同 RAG 方法的适应性。
实验在以下 4 个数据集 上开展,涵盖了不同的问答与生成场景:
PopQA — 短文本/事实性问答
Biography — 长文本/人物传记生成
PubHealth — 健康/事实核查任务
Arc-Challenge — 科学常识/推理问答
实验发现,CRAG 显著提升了标准 RAG 和当时 SOTA(最先进)的 Self-RAG 的性能。这展示出了 CRAG 在短文本生成和长文本生成任务上良好的泛化性。
2. CRAG 建模
2.1 任务建模
给定输入 x 以及文本语料库 C = {d1, d2, ..., dN} ,我们期望 RAG 系统给出一个回复 y 。将 RAG 系统拆解为检索器 R 与生成器 G 。检索器 R 的任务是:从文本语料库 C 中检索出 Top-K 个与问询 x 最相关的文章 D = {dr1, dr2, ..., drk} 。基于问询 x 与检索到的文章集 D ,生成器 G 负责生成回复 y 。
2.2 CRAG 框架
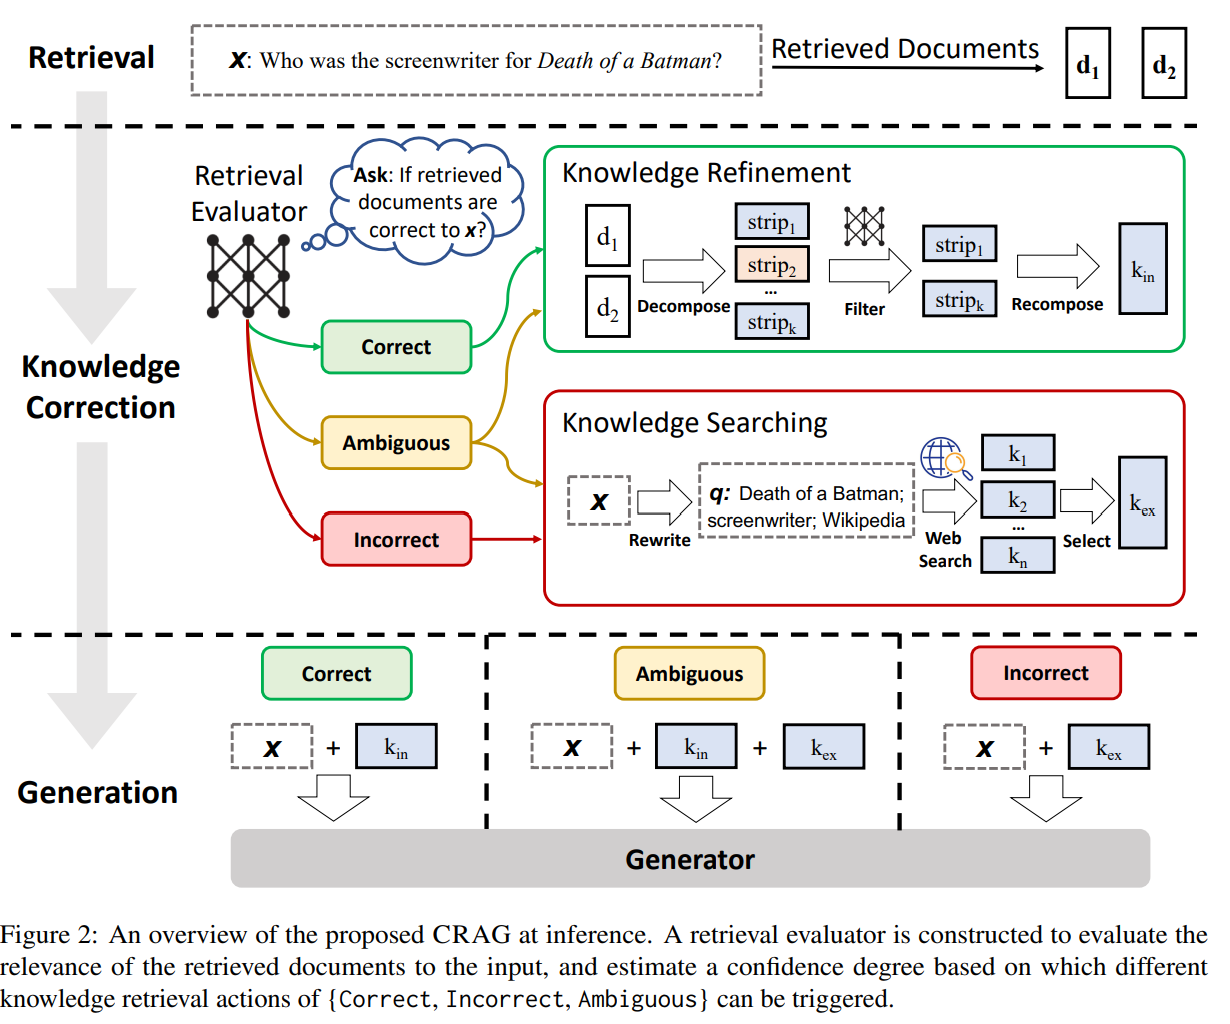
对于任意检索器返回的文档和输入 Query,首先由一个轻量级检索评估器估算检索文档与输入 Query 的相关性得分。
相关性得分被量化为三种置信度,进而触发对应的操作:
动作一:Correct(正确)
适用场景:评估器给出高置信度。
具体处理:认为检索结果可靠,但为了去除冗余,检索到的文档会被精炼为更精确的知识碎片(Knowledge Strips)。精炼过程包含知识分解、过滤和重构三步。
动作二:Incorrect(错误)
适用场景:评估器给出极低置信度(确认检索错误)。
具体处理:直接丢弃所有检索到的本地文档。转而求助于网络搜索,将其作为纠正补充的知识来源。
动作三:Ambiguous(模糊/不确定)
适用场景:评估器无法给出明确的正确或错误判断时(处于中间临界区间)。
具体处理:采用一种软性且平衡的动作,结合上述两者的知识(既保留精炼后的本地文档,也补充网络搜索结果)。
最后,优化后的知识被喂给任意 LLM(如 LLaMA, GPT 等)来生成最终回答。
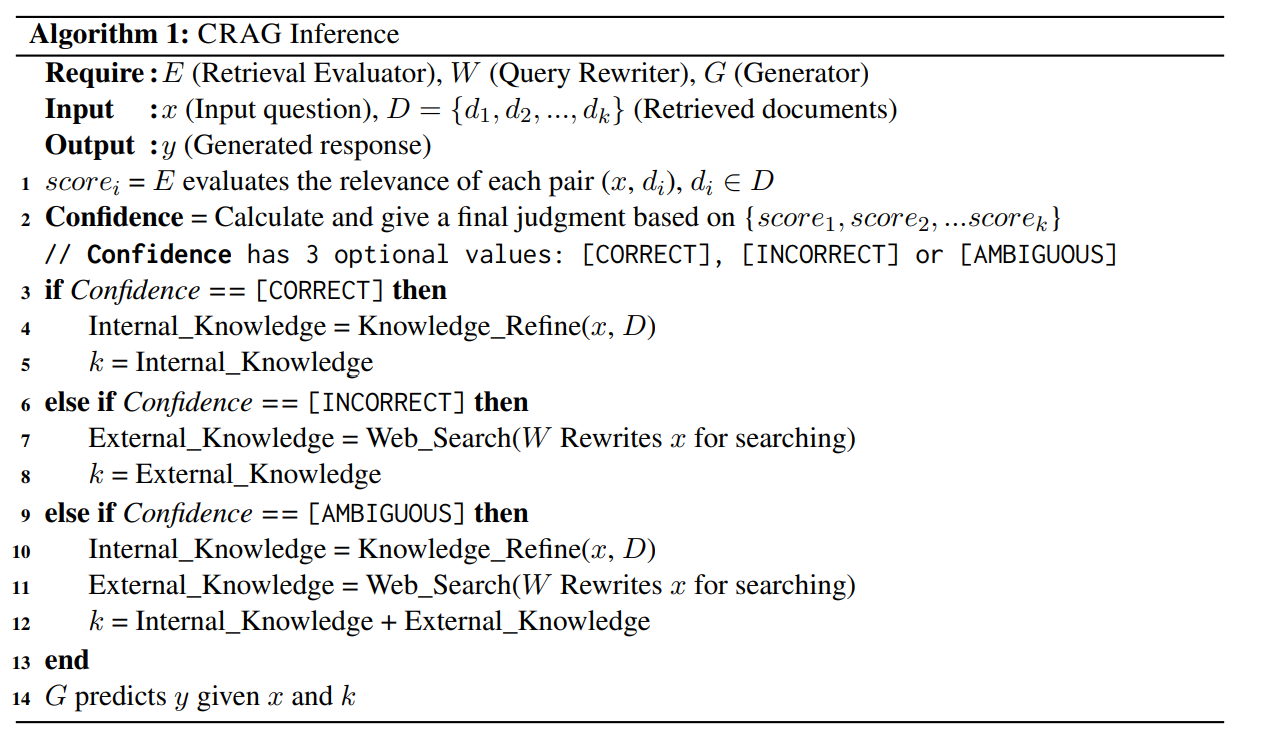
可以参考下面的算法图来深入理解:
2.3 检索评估器
检索评估器采用 T5-large 进行初始化与微调,参数量仅为 0.77B。相比主流大语言模型以及 Self-RAG 所使用的 LLaMA-2 7B Critic 模型,CRAG 的评估器极为轻量,评估成本极低 。此外,为了与 Self-RAG 的结果保持可比性,CRAG 采用了与 Self-RAG 相同的 Contriever 作为检索器。
评估器的微调信号直接从现有数据集中收集,构建了高质量的正负样本:
在推理阶段,针对每个问题检索出 10 篇文档,将问题与单篇文档进行拼接后输入评估器,评估器对每个 “问题-文档” 对逐一、独立地预测一个相关性得分。基于这些计算出的相关性得分,后续进一步判定检索整体是否正确并触发对应 Action。
此外,作者尝试过通过 Prompting ChatGPT 来判断检索相关性,但实验表明其表现不及微调后的 T5-large 评估器。
2.4 动作触发器
评估器会先对 10 篇检索到的文档独立计算相关性得分,并设定一个上阈值和下阈值。
此外,作者讨论了一个重要的消融实验洞察:
早期尝试:最初系统只设计了 Correct 和 Incorrect 两个硬切换动作(Hard Switch)。
遭遇瓶颈:实验发现,仅靠这两个动作时,CRAG 的最终表现非常依赖检索评估器的准确率。一旦评估器偶有误判,系统就会走向完全相反的处理路线。
引入 Ambiguous 这种软性缓冲动作后,系统在评估器“拿不准”时同时融合两种知识,显著降低了 CRAG 对评估器准确率的强依赖性,大幅提升了整个系统的鲁棒性。
2.5 知识精炼
为了避免相关文档中夹杂的冗余或不相关句子对大模型造成干扰,CRAG 采取了细粒度切分与过滤机制,具体包含以下三个步骤:
知识分解:
基本单位:将文档拆分为包含独立信息的内部切片。
切分粒度:
如果检索出的结果本身很短(仅 1 到 2 句话),则直接将其看作一个独立的切片。
如果文档较长,则根据总长度将其拆分为更小的单元(通常由几句话组成)。
设计假设:假设这种细粒度的切片规模足以容纳一个相对独立的完整信息点。
切片过滤:
评估工具:继续使用微调好的轻量级检索评估器。
逐块打分:评估器会对拆分出的每一个知识切片逐一计算相关性得分。
剔除噪音:得分低、与 Query 无关的切片直接被丢弃。
知识重构:
顺序拼接:将所有通过过滤的相关知识切片,按照原文中的原始顺序进行拼接。
产出:重构后得到的精炼上下文被称为内部知识,它将被提供给最终的生成模型。
2.6 网络搜索
作者认为,一个“知道自己不知道”并在必要时主动寻求外部知识补充的系统,比死守有限知识库的系统要聪明得多。而静态且有限的本地语料库在知识覆盖范围和多样性上天生存在瓶颈,因此作者选择将大规模网络搜索作为 RAG 的战略性扩展。
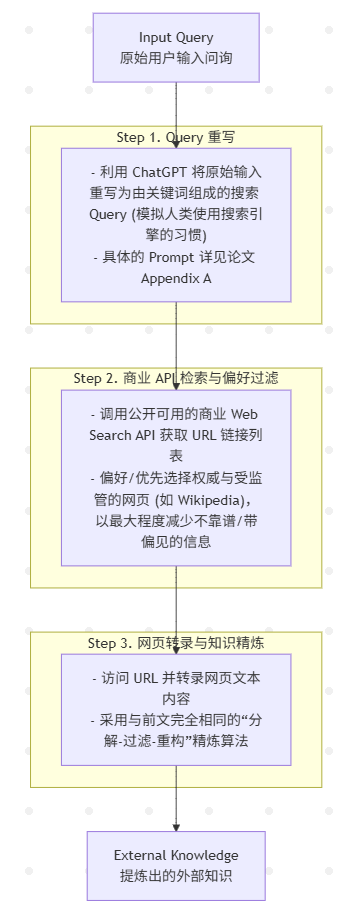
针对触发 Incorrect 或 Ambiguous 的场景,CRAG 采用以下步骤提取外部知识:
3. 实验与数据
3.1 任务、数据集与评估指标
实验采用了与前人研究完全相同的检索结果(即 Contriever 的初始检索结果)和完全相同的评估指标,确保了对比结果的客观与公平。
3.2 Baseline
3.3 实验结果与分析
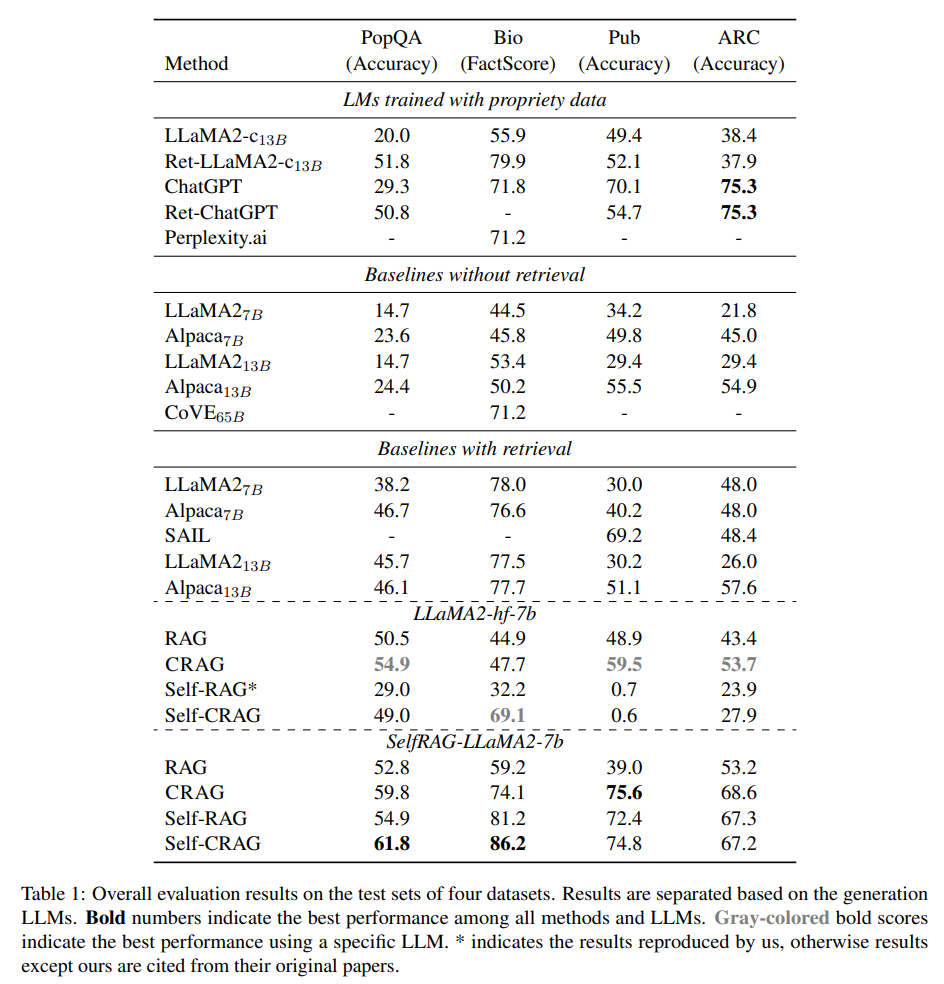
由于 CRAG 是一个对初始检索结果进行处理的框架,因此与经典 RAG 与 Self-RAG 等框架能无缝衔接。上图中,“CRAG” 指的是在经典 RAG 框架上插入 CRAG ,“Self-CRAG” 指的是在 Self-RAG 框架上插入 CRAG 。
结果分析:
CRAG 能显著提升标准 RAG 及 SOTA 模型 Self-RAG 的表现,在不同基座模型(Base LLM)上均展现出很大优势:
CRAG 在涵盖不同实际应用场景的四大数据集上均表现一致且高效,证明了其强大的通用能力与泛化性:
短实体生成:如 PopQA
长文本生成:如 Biography(人物传记)
闭集问答/推理任务:如 PubHealth(真假判断)、Arc-Challenge(多项选择)
底层 LLM 生成器的选择更加灵活:
Self-RAG 的局限:非常依赖专门的指令微调来学会生成特定的反思标记。一旦把底层生成器换成未经过微调的普通模型(如 LLaMA2-hf-7b),性能会发生断崖式下跌,甚至不如标准 RAG。
CRAG 的解耦优势:对底层生成模型没有任何特殊微调要求。从 SelfRAG-LLaMA2-7b 切换为未被微调过的 LLaMA2-hf-7b 时,CRAG 依然保持极高竞争力。
面向未来的兼容性:未来一旦出现更强大的通用 LLM ,CRAG 可以做到零成本直接挂载使用,而 Self-RAG 则必须针对反思标记重新进行昂贵的指令微调。
3.4 消融实验
作者在 PopQA 数据集上,通过“每次扣除/合并一个动作”的方式,验证了 CRAG 中三种 Trigger 动作(Correct, Incorrect, Ambiguous)各自对系统性能的真实贡献:
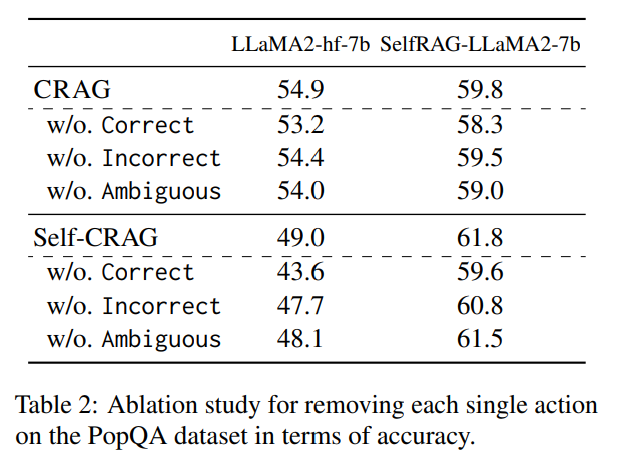
实验组介绍:
实验结果显示,无论移除这三个动作中的哪一个, PopQA 数据集上的生成准确率(Accuracy)都会出现下滑。这证明了 Correct(本地知识精炼)、Incorrect(丢弃+网络搜索)和 Ambiguous(软性结合缓冲)这三个动作中的每一个,都在提升系统最终生成的鲁棒性方面作出了不可替代的贡献。
CRAG 中 3 个关键的知识利用/处理操作对最终生成性能(在 PopQA 数据集上的准确率)的独立贡献:
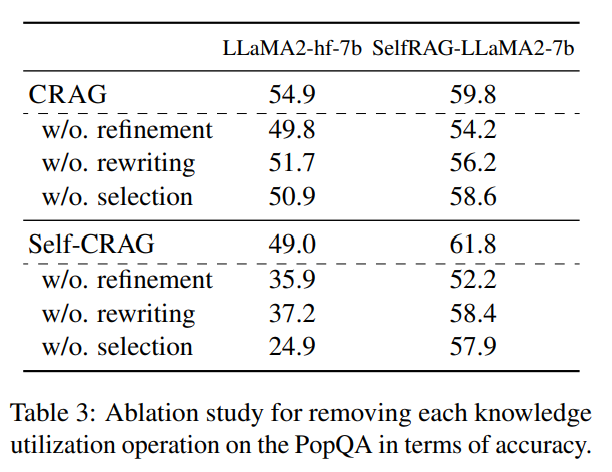
论文通过“逐一剔除”的方式,对比了各个知识处理环节移除后的变体:
实验结果表明,无论移除上述哪一项知识利用操作,系统的最终生成准确率都会发生下降。这证明了“文档精炼(提炼本地知识)”、“Query 重写(优化网络搜索输入)”以及“外部知识筛选(清洗网页文本)”这三个步骤中的每一个,都对提高检索知识的有效利用率作出了实质性贡献。
3.5 检索评估器的准确率
评估器能否准确判定检索文档的整体质量,决定了整个 CRAG 系统的上限。论文在 PopQA 数据集的文档检索结果上,对比了以下评估方案:
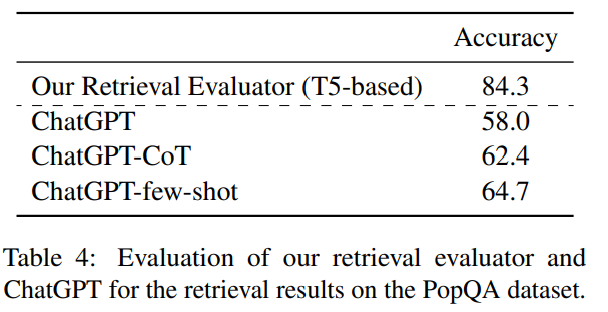
实验结果表明:只有 0.77B 参数量、经过微调的 T5 检索评估器,在所有设定下的评估准确率均显著超越了强大的 ChatGPT(包括 CoT 与 Few-shot 变体)。
3.6 检索性能的鲁棒性
为了测试系统在面对“低质量检索器”时的抗压与纠错能力,作者在研究中采用了如下模拟手段:
模拟低质量检索器:故意随机删除一部分原本准确的检索结果,强制让输入给后续模块的文档质量变差。
对比指标与基线:在 PopQA 数据集上观察并对比 Self-RAG 与 Self-CRAG 随检索性能下降时的生成表现变化曲线。
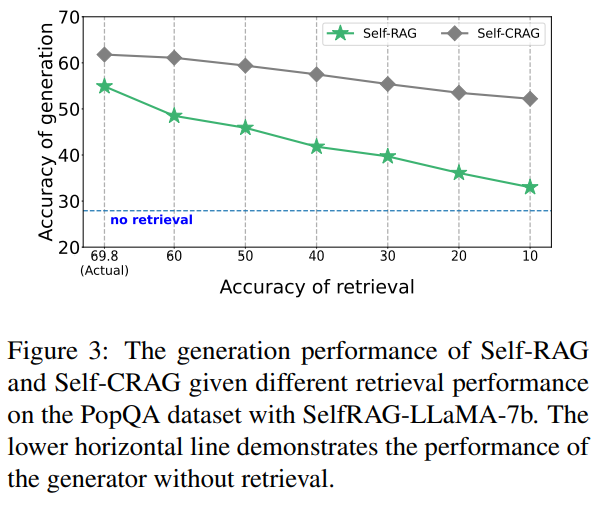
随着检索性能逐步降低,Self-RAG 与 Self-CRAG 的最终生成性能均出现了下滑。这再次证实了生成器的输出质量高度依赖于检索器的质量。
此外,当检索性能不断恶化(准确文档越来越少)时,Self-CRAG 的生成性能下滑幅度远比 Self-RAG 更加平缓。这体现出 CRAG 能够提升 RAG 系统对低质量检索器的容错率与鲁棒性。
3.7 持续补充网络搜索知识的对照实验
作者在本节中回答了一个问题:CRAG 的性能提升,究竟是因为它的自纠错机制,还是单纯因为给它喂了网络搜索的额外数据(占了信息量大的便宜)?
在本节中,作者设计了严谨的等量信息对照实验:
控制变量:给传统的 Standard RAG 和 Self-RAG 也无条件、持续性地补充网络搜索知识。
信息对齐:确保所有对比模型在回答问题时,能够访问到的知识范围一致。
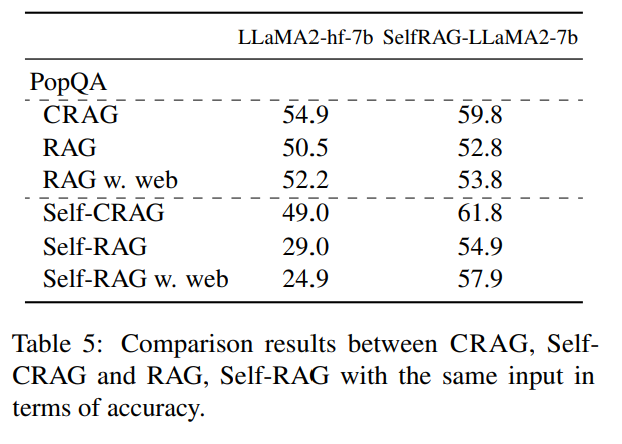
得出了以下两个结论:
单纯叠加网络搜索对基线的提升非常有限
给 RAG 或 Self-RAG 持续补充网络搜索知识,在大多数情况下确实能小幅提升性能,但提升幅度相当有限(Remaining limited)。
在某些特殊情况下(例如使用原始 LLaMA2 基座模型的 Self-RAG),直接塞入网络搜索知识甚至会导致性能不升反降。
动态自纠错机制在所有场景下均显著胜出
在所有测试情况下,引入 CRAG 自纠错机制的模型,表现都显著超越了那些单纯补充网络搜索的基线模型。
3.8 计算开销分析
为了量化开销,作者从理论算力和实际运行耗时两个维度进行了测试:
理论算力消耗:
采用了 Narayanan et al. (2021) 提出的公式,预测在 GPU 上处理每个 Token 所需的 FLOPs(浮点运算次数)。
实际运行耗时:
在 PopQA 数据集上进行了实测,统计并对比了每个样本的平均执行时间。
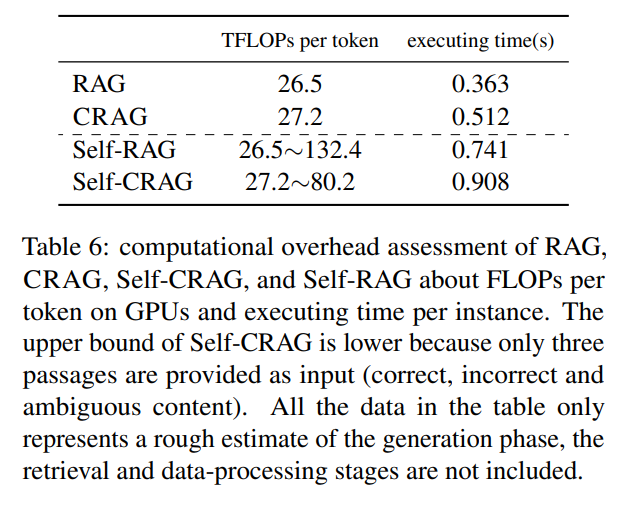
由于 Self-RAG 具有根据输入自适应调整生成策略的特性,其计算开销无法被精确固定计算。因此上表中对 Self-RAG 给出的是一个估计区间。
实测与理论计算均表明,相比于它所带来的巨大性能提升,CRAG 的自纠错机制只增加了较小的计算开销。这进一步验证了 CRAG 作为一种轻量级、即插即用方案的优势——无需重新训练昂贵的大语言模型,仅增加极低开销即可大幅增强 RAG 系统的鲁棒性。
4. 结论与未来展望
作者研究了当检索出错时基于 RAG 的方法所面临的挑战——这种情况会导致生成式语言模型暴露在不准确且具有误导性的知识面前。为此,作者提出了基于纠错的检索增强生成方法(Corrective Retrieval Augmented Generation, CRAG),以提高生成的鲁棒性。
本质上,CRAG 利用一个轻量级的检索评估器来估算相关性,并精准触发三种不同的知识检索动作。结合大规模网络搜索的进一步扩充以及优化的知识利用机制,CRAG 显著提升了系统的自动自纠错能力以及对检索文档的高效利用率。广泛的实验充分证明了 CRAG 对各种基于 RAG 方法的适应性,以及在短文本和长文本生成任务上的强泛化性。
此外,虽然作者主要从“纠错”的角度改进了 RAG 框架,且 CRAG 可以与各种基于 RAG 的方法无缝结合,但微调一个外部检索评估器是不可避免的。如何消除这个外部评估器,并赋予 LLM 自身更好的检索评估能力,是未来值得探究的。