

在 Day 1 中,我们学习了机器学习的任务以及经典的学习流程,并介绍了机器学习的两个要素:数据集和模型。今天继续学习机器学习的学习准则。
1. 学习准则概述
考虑由 𝑁 个样本组成的训练集 𝒟 :
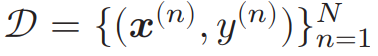
在经典监督学习设定中,通常假设每个样本 (𝒙, 𝑦) ∈ 𝒳 × 𝒴 独立地从某个未知但固定的数据分布 𝑝𝑟(𝒙, 𝑦) 中抽取。这个假设使得我们可以把训练集视为未来测试样本的一个代表性近似,并在此基础上讨论泛化问题。
由于机器学习的目标是学习出能够推广到未见样本的模型,因此,我们通常希望模型 𝑓(𝒙;𝜃) 在真实数据分布 𝑝𝑟(𝒙, 𝑦) 下具有较小的平均损失。可以通过期望风险(期望错误) ℛ(𝜃) 来衡量一个模型的好坏:
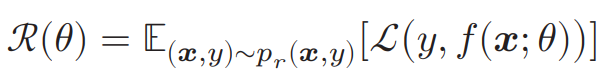
上式中,ℒ(𝑦, 𝑓(𝒙; 𝜃)) 指的是损失函数,用于量化模型预测与真实标签之间的差异。
然而,真实数据分布一般是未知的,因此期望风险往往无法直接计算。在实际训练时,我们通常做的事情是:
选定一个损失函数,例如交叉熵损失(对于分类问题),MSE 损失(对于回归问题)。
用训练数据的分布来近似真实数据分布,在训练数据上近似优化期望风险。
此外,对分类任务而言,经常还会用一个条件概率分布 𝑓𝑦(𝒙;𝜃) 来表示模型对类别 𝑦 的预测概率。
2. 损失函数
损失函数是一个非负实数函数,用来量化模型预测和真实标签之间的差异。有几种机器学习中常用的损失函数:
0-1 损失函数
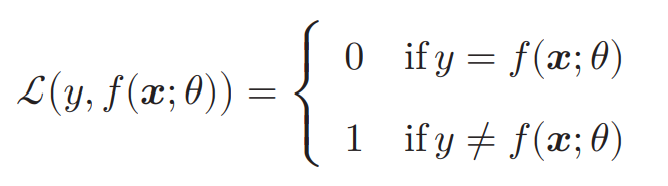
这个函数的设计思路就非常直观了。模型预测对了就不计损失,预测错了就记 1 点损失。它衡量了是模型在训练集上的错误率。
或者也可以用指示函数来表达:
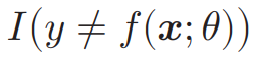
虽然 0-1 损失函数能够客观地评价模型的好坏,不过它有一个显著的缺点:数学性质不好。
0-1 损失函数不连续。
更重要的问题:0-1 损失函数在可导点上处处导数为 0 ,难以优化。
因此,经常用连续可微的损失函数替代 0-1 损失函数。
平方损失函数
平方损失函数通常使用在真值标签为实数的应用场景中,如下定义:
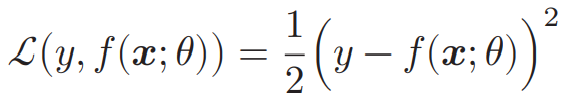
我的补充思考:不难发现,平方损失函数的设计思路是:在平均意义上降低真值标签与模型预测之间的距离。换言之,它要求真值标签与模型预测需要处在一个连续的度量空间之中。对于分类问题,由于单纯的类别标签之间不存在度量关系(即:无所谓 “第 2 类 ”距离 “第 3 类” 更近还是距离 “第 1 类” 更近),所以对于真值标签与模型预测都是类别标签的情形,不适合直接采用平方损失函数。
不过,也存在一种用平方损失函数解决分类问题的方法:将模型预测和真值标签转换为概率测度。这就是前文所述 “用一个条件概率分布 𝑓𝑦(𝒙;𝜃) 来表示模型对类别 𝑦 的预测概率” 。由于转换为概率测度之后,真值标签与模型预测同处一个连续度量空间,因此就可以采用平方损失函数来度量损失。
举一个具体的例子。考虑一个 3 分类问题,对于某一个样本,真值标签为 [0, 1, 0]T ,即该样本属于第 2 类。如果将这个标签视作类别标签,且模型的预测也是类别标签:[1, 0, 0]T ,那么就不适合采用平方损失函数。因为在计算时,(1 - 0)2 并没有任何实际意义。然而,如果将真值标签 [0, 1, 0]T 视作概率测度,即 [0%, 100%, 0%]T ,并且模型的预测也是 “模型对类别 𝑦 的预测概率” :[96%, 2%, 2%]T ,那么这个时候就可以采用平方损失函数。因为 (96% - 0%)2 表示的含义是,模型对 “该样本属于第 1 类” 的把握与实际情况之间的差距。
此外,利用这种概率测度转换方式来训练分类模型还有一个好处:模型不仅学会了 “如何正确分类样本” ,还学会了 “如何更有把握地(以更高概率) 正确分类样本” 。
交叉熵损失函数
交叉熵损失函数一般用于分类问题。假设样本的标签 𝑦 ∈ {1, ⋯ , 𝐶} 为离散的类别,模型 𝑓(𝒙;𝜃) ∈ [0, 1]𝐶 的输出为类别标签的条件概率分布,即
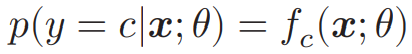
且满足
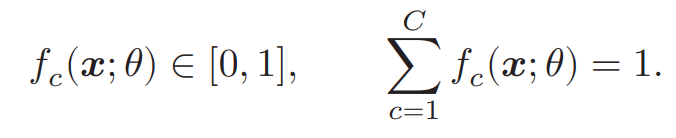
如果我们采用一个 𝐶 维的 one-hot 向量 𝒚 来表示样本标签,那么对于一个标签是 k 的样本,标签向量 𝒚 只有第 𝑘 维的值为 1 ,其余元素的值都为 0 。可以将其视作样本标签的真实条件概率分布 𝑝𝑟(𝒚|𝒙),即第 𝑐 维(记为𝑦𝑐,1 ≤ 𝑐 ≤ 𝐶)是类别为 𝑐 的真实条件概率。假设样本的类别为 𝑘,那么它属于第 𝑘 类的概率为 1,属于其他类的概率为 0 。
对于两个概率分布,一般可以用交叉熵来衡量它们的差异。因此,我们可以计算标签的真实分布 𝒚 和模型预测分布𝑓(𝒙;𝜃)之间的交叉熵:
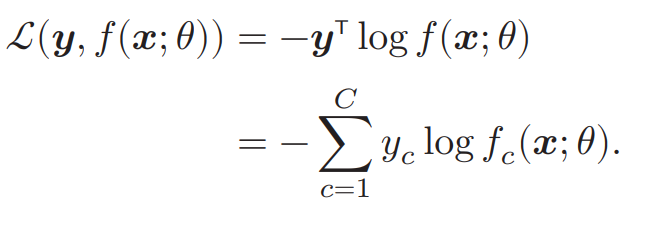
因为 𝒚 为 one-hot 向量,上式也可简化为:
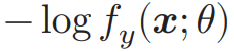
其中 𝑓𝑦(𝒙;𝜃) 可以看作真实类别 𝑦 的似然函数。因此,交叉熵损失函数也就是负对数似然函数。
注:这里书上用不加粗的 𝑦 来表示真实类别,事实上与前文中的样本标签 k 是等价的,不要与 one-hot 标签向量 𝒚 混为一谈。
补充知识:交叉熵与 KL 散度
给定两个概率分布 𝑝 和 𝑞 ,交叉熵定义为:
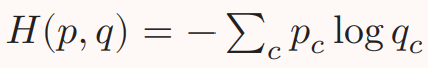
衡量用 𝑞 来编码服从 𝑝 的数据所需的平均信息量。交叉熵可以分解为:
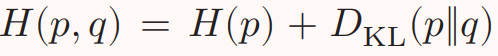
其中 𝐻(𝑝) 是 𝑝 的熵,𝐷KL(𝑝‖𝑞) ≥ 0 是 KL 散度。因此,最小化交叉熵等价于最小化 KL 散度,即让预测分布 𝑞 尽可能接近真实分布 𝑝 。
Hinge 损失函数
对于二分类问题,假设 𝑦 的取值为 {−1, +1},𝑓(𝒙;𝜃) ∈ ℝ ,Hinge 损失函数定义为:
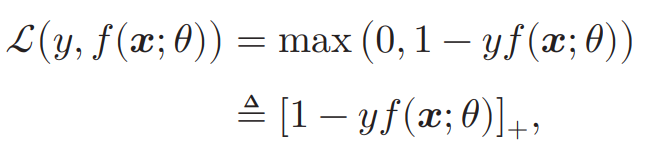
其中 [𝑥]+ = max(0, 𝑥) 。
我们可以如下来快速理解 Hinge 损失函数的设计思路,不妨设 𝑦 = 1 。此时 Hinge 损失函数等价于:max(0, 1 − 𝑓(𝒙;𝜃))
当 𝑓(𝒙;𝜃) ≥ 1 时。此时 Hinge 损失函数取值为 0 。
当 𝑓(𝒙;𝜃) < 1 时。此时 Hinge 损失函数取值为 1 - 𝑓(𝒙;𝜃) 。这是 𝑓(𝒙;𝜃) 的线性函数,随着 𝑓(𝒙;𝜃) 的减小而不断增大。
我们可以这样解读 Hinge 损失:
如果模型预测错误(𝑦𝑓(𝒙;𝜃) < 0)或者模型预测正确但是置信度不够高(把握不够大)(0 ≤ 𝑦𝑓(𝒙;𝜃) < 1), Hinge 损失函数将给予损失惩罚。且模型预测的越错误,损失惩罚越重。
如果模型以高置信度正确预测(𝑦𝑓(𝒙;𝜃) ≥ 1),Hinge 损失函数将不给予任何损失惩罚。
3. 风险最小化准则
由于真实的数据分布未知,实际训练时通常只能在训练集上计算模型的平均损失,即经验风险(经验错误):
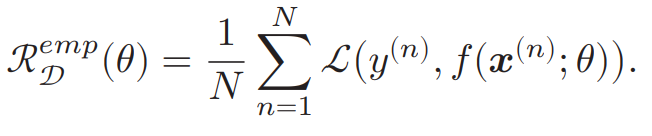
于是,一个切实可行的学习准则是寻找一组参数 𝜃* ,使经验风险最小,即:
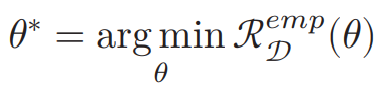
这就是经验风险最小化准则。
过拟合与欠拟合
然而,仅仅最小化训练集上的经验风险并不能保证模型具有良好的泛化能力。当模型复杂度过高时,即使训练误差很低,也可能在未见样本上性能较差,这就是过拟合现象。
过拟合:给定一个假设空间 ℱ ,一个假设 𝑓 属于 ℱ,如果存在其他的假设 𝑓′ 也属于 ℱ,使得在训练集上 𝑓 的损失比 𝑓′ 的损失小,但在整个样本空间上 𝑓′ 的损失比 𝑓 的损失小,那么就说假设 𝑓 过度拟合训练数据。
欠拟合:模型不能很好地拟合训练数据,在训练集上的错误率比较高。一般是由于模型能力不足造成的。
下图给出了一些示例:
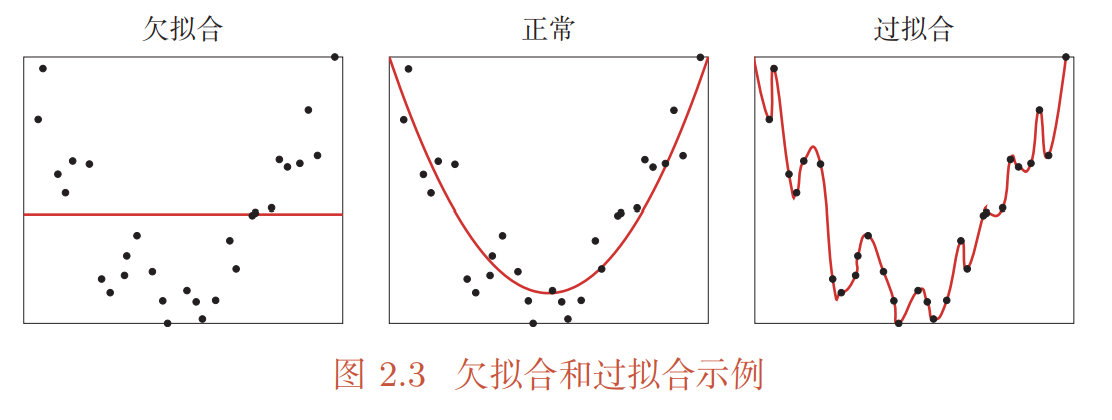
上图很好的展示了模型在数据上的拟合状态。当模型欠拟合时,几乎没有学习到任何有用知识;当模型过拟合时,过度学习了训练集,甚至复杂地拟合了噪声;对于一个正常的模型,则能在学习到一般的知识规律的同时,不过度复杂地学习噪声。
为了在拟合训练数据和控制模型复杂度之间取得平衡,常在经验风险最小化的基础上加入一个复杂度惩罚项,从而得到结构风险最小化准则:
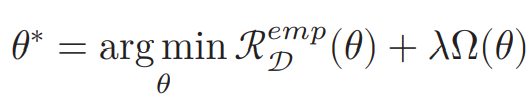
其中 Ω(𝜃) 用来衡量模型复杂度,𝜆 ≥ 0 为权衡系数。在线性模型和神经网络中,最常见的复杂度惩罚项是正则化项,如 L2 正则化,L1 正则化等。从贝叶斯学习的角度来讲,正则化是引入了参数的先验分布,使其不完全依赖训练数据。
在实际机器学习流程中,以上两个准则通常应用在训练阶段。模型选择、正则化强度和其他超参数的确定,则依赖验证集上的性能。当训练数据较少时,也可以采用交叉验证来近似完成模型选择与性能估计。
交叉验证
交叉验证用于在数据量较少时更稳定地评价模型。常见的 𝐾 折交叉验证做法是:
把原始数据集划分为 𝐾 个互不重叠的子集,一般 𝐾 > 3 。
每次选 𝐾 − 1 个子集作为训练集,剩下的一个子集作为验证集,共进行 𝐾 轮训练与验证,并将 𝐾 次验证结果取平均。
注意:交叉验证通常用于模型选择和超参数调整。如果有独立测试集,最终结果仍应在测试集上评测。
补充说明:这里需要注意,不要将“交叉验证”的训练-验证 K 轮与“一个模型单独串行训练-验证 K 轮”混为一谈。
交叉验证的目标是:寻找出一组最优的学习策略(包括超参配置、学习算法、优化器等)。在交叉验证中,我们独立地初始化 K 个模型,每一个模型使用的训练集和验证集互不相同。在训练若干轮后,K 个模型分别在各自的验证集上得到了 K 个评分。我们对这 K 个评分做平均,就得到了对当前使用的这个学习策略的评分。
在交叉验证阶段后,我们就寻找出了一套目前发现的最优学习策略以及在这个最优学习策略下训练若干轮后得到的 K 个模型。一般有两种处理方式:
直接废弃这 K 个模型,在最优学习策略下,用全量数据从头重训模型,并应用于推理任务。
有时候训练模型代价比较高,我们不想从头重训一遍模型。这个时候可以将这 K 个模型各自独立地对测试数据进行推理,并对 K 个推理结果做推理期融合(ensemble),得到最终的推理结果。
By the way,如果我们的理解是,按照交叉验证划分数据集的方式,将一个模型单独串行训练-验证 K 轮,会怎样呢?
这种情况下,由于验证的数据早在前一轮训练时就被模型学习过,因此会发生很严重的数据泄露问题。验证集上的表现将不具备足够的可信度,不应当用于指导学习策略的选择。因此,这种理解方式是不对的。
下一节,我们继续学习优化算法与评价指标的相关内容。