

今天研读 ToG 家族的最后一篇研究《Think-on-Graph 3.0: Efficient and Adaptive LLM Reasoning on Heterogeneous Graphs via Multi-Agent Dual-Evolving Context Retrieval》
开源实现:ToG-3
1. 为什么要引入 ToG-3 ?
目前,商业模型与开源大语言模型的快速演进,降低了生成式 AI 能力的使用门槛。而 RAG 技术成为利用外部知识为 LLM 提供依据的重要方法,能够缓解模型固有的知识截断与幻觉问题。
ToG(Think-on-Graph)早期工作开创了将文本检索与知识图谱(KG)检索紧密结合的迭代混合 RAG 框架。然而该方法高度依赖预先存在的结构化知识图谱(如 Freebase 和 Wikidata),在缺乏现成图谱的垂直或私有场景中难以直接应用。
为了摆脱对预构建知识图谱的依赖,GraphRAG 与 LightRAG 提出了从输入文档中直接构建图结构的方案,但仍存在以下不足:
抽取能力的瓶颈:
这类方法直接从输入文档中构建基于实体的图,以增强信息检索与摘要能力。
但生成图谱的质量高度依赖 LLM 准确抽取实体和关系的能力。
当在私有或离线环境中部署参数量较小的轻量级模型(如 Qwen2.5-7B 至 72B)时,模型的抽取表现容易成为制约图谱质量的关键瓶颈。
问题处理方式的割裂:
这些现有方法往往将局部问题与全局问题的处理逻辑相互分离,缺乏统一的处理机制。
下图展示了现有图增强 RAG 主要遇到的问题:
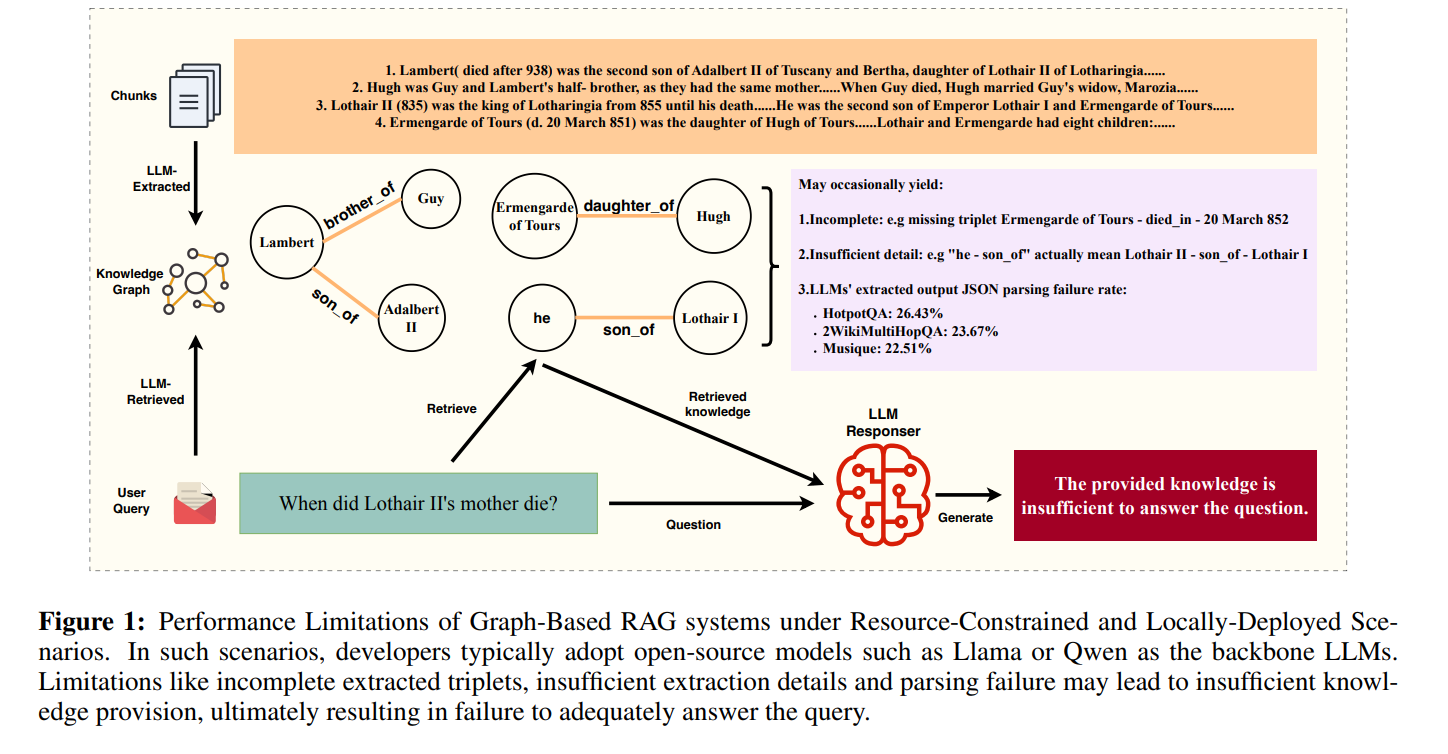
为了解决这些问题,作者提出了 ToG-3 ,它结合了前代依赖外部知识图谱与文档直接建图两类方法的优势,提出
Chunk-Triplets-Community(文本块-三元组-社群)异构图架构
多智能体上下文演化与检索机制(Multi-Agent Context Evolution and Retrieval ,MACER 机制)
双重演化机制(包含查询演化与子图演化,两者以迭代方式协同运行,实现精准的证据检索)。
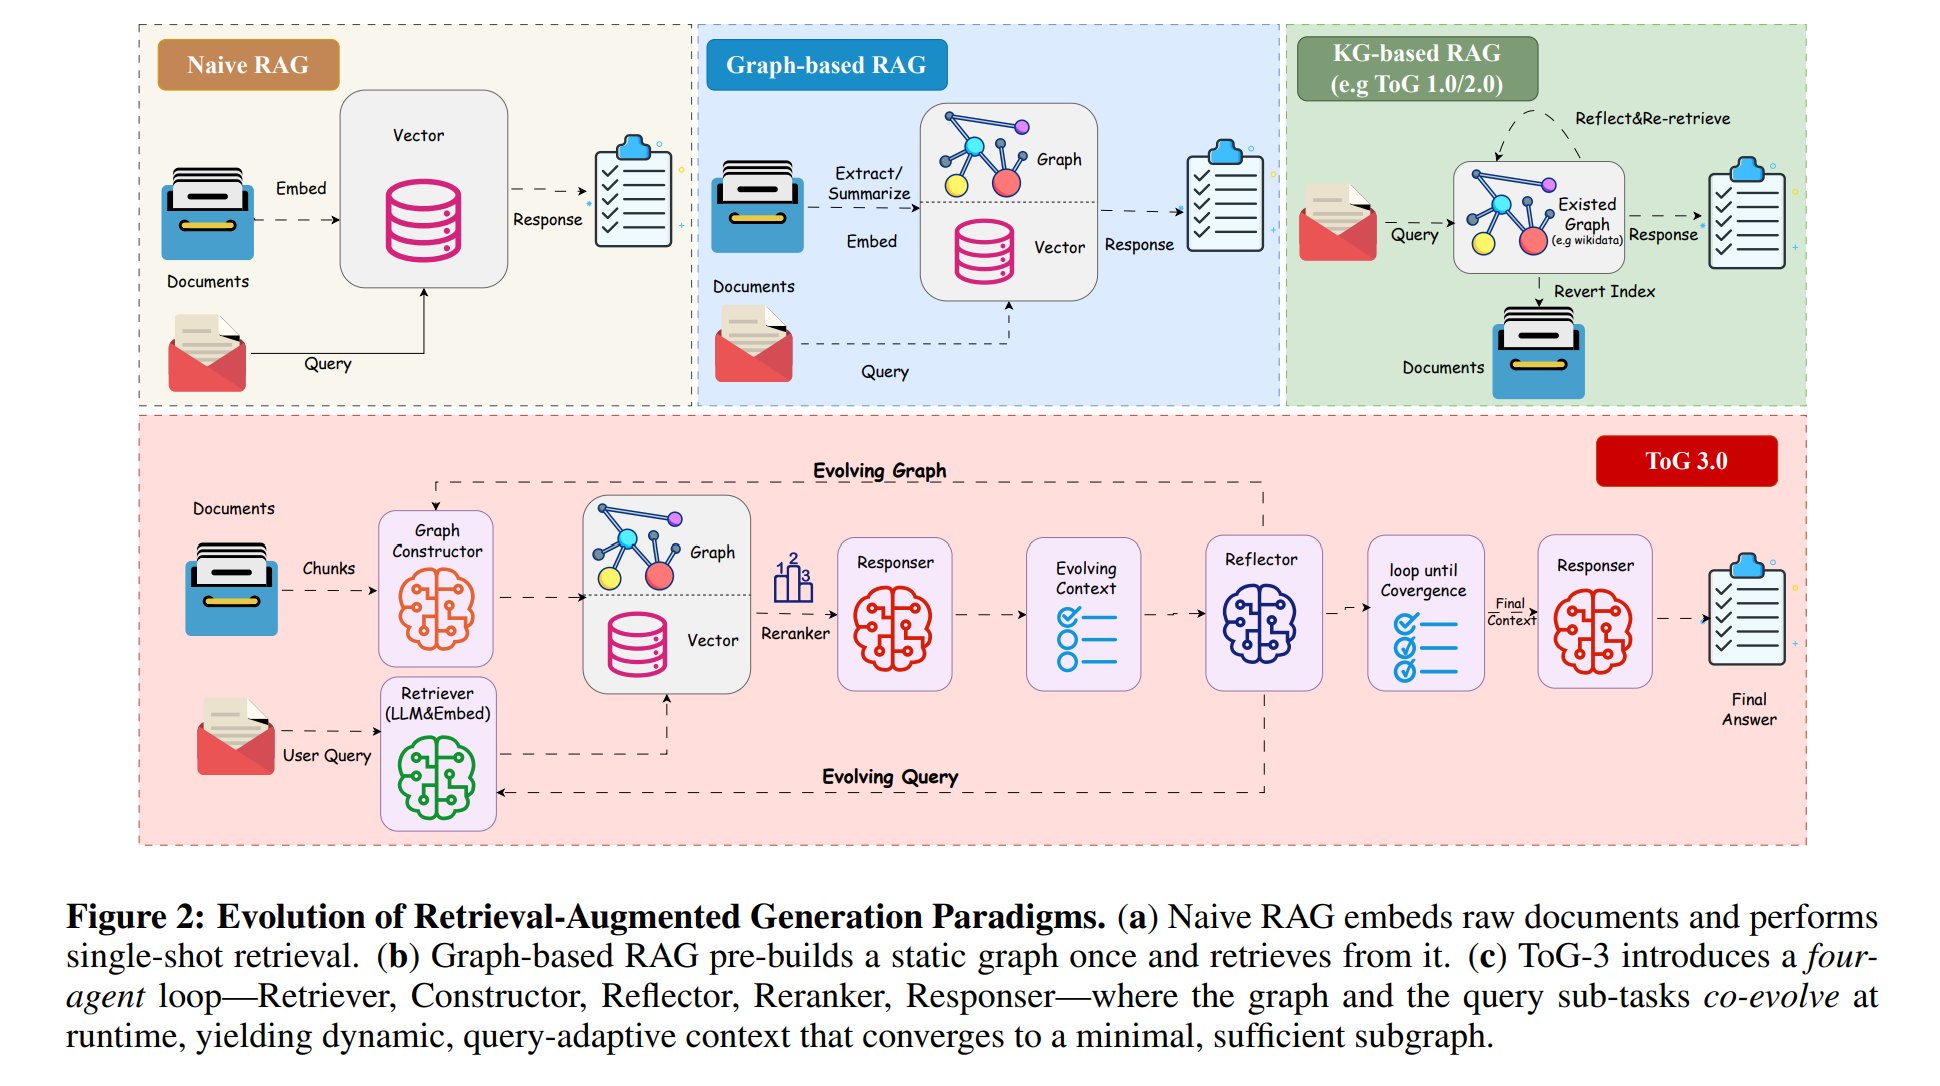
传统的图增强 RAG 方法通常采用单次扫描构建静态图索引,无法根据实际的具体查询进行针对性调整。而 ToG-3 通过迭代机制,动态细化查询表示与图结构,使检索过程根据当前推理需求自适应变化。
此外,该框架特别面向资源受限环境以及私有化本地部署场景,针对以 Llama、Qwen 等轻量级开源大模型为底座的系统,降低对其单次抽取能力的强依赖,保障检索与推理质量。
作者指出本研究的贡献:
提出 MACER 多智能体框架与双重演化机制
提出新型多智能体框架 MACER 。
将查询演化与子图演化整合为双重演化机制引入图检索范式中。
重点改善了基于图的 RAG 检索性能与复杂推理能力,特别是在以轻量级开源大模型作为系统底座的运行环境下。
构建 ToG-3 统一推理系统与异构图架构
提出了统一推理系统 ToG-3,融合了以往基于图的方法与早期 ToG 方法的互补优势。
核心构建依赖两项协同设计:
Chunk–Triplet–Community 异构图索引:提供多层次的图谱结构表示。
双重演化上下文检索循环流程:实现动态迭代的上下文获取。
覆盖深度与广度推理任务的全面实验验证
在深度推理与广度推理两类任务上完成了系统性实验。
实验结果表明,该方法能够支持多跳推理与大规模上下文整合,在多种基准测试中展现出良好的推理与检索性能。
可以参考下图以直观了解 ToG-3 与传统方法的对比:
2. ToG-3 建模
2.1 问题定义
考虑文本语料库
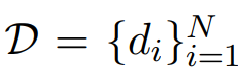
任务目标是用答案 a* 回答用户问询 q 。其中 a* 是从由语料库 D 中抽取出来的异构图谱 G 的极小充分子图 G*q 产出的。形式化表述如下:
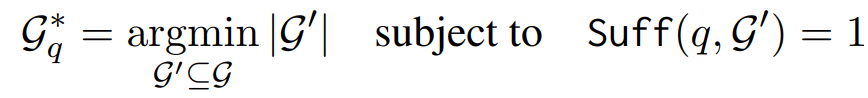
Suff(·, ·) ∈ {0, 1} 是一个判别子图能否充分回答问询 q 的函数。
2.2 异构图谱索引
节点模式
由 Constructor Agent 负责构建异构图 G = (V, E) ,其中节点集合 V 包含三种类型:
Chunks(文本块 C ):语料库中句子级别的文本段落。
Triplets(三元组 T ):从文本块中抽取的语义三元组 (s, p, o) ,带有实体类型与关系类型标注 (types, typep, typeo) 。
Communities(社群 M ):在实体共现图上运行 Leiden 聚类算法获得的实体簇摘要,每个社群均被压缩提炼为一段摘要文本。
边关系模式
边集合 E 包含三种类型的关系:
OPENREL(s, p, o):通过大语言模型抽取的谓词 p 连接头实体 s 与尾实体 o,构成开放域语义三元组。
MENTIONEDIN(t, c):将三元组 t 连接至其被抽取来源的文本块 c 。
SUMMARYFOR(m, e):将社群摘要节点 m 连接到属于该社群的实体 e 。
离线索引构建
一次性构建:通用图索引 G 在离线阶段完成一次性构建。
统一向量空间编码:采用单一冻结参数的编码器 Eθ(例如 jina-embeddings-v3),将所有类型的节点(无论文本块、三元组还是社群摘要)统一映射至 1024 维的稠密向量空间。
检索优化:通过该统一向量空间,检索阶段可以在所有节点类型之间进行统一、高效的向量检索。该机制使细粒度信息(文本块与三元组)与宏观高层信息(社群摘要)能够在同一个向量空间中无缝检索,消除了局部问答与全局问答的割裂处理。
图谱索引的构建算法如下:
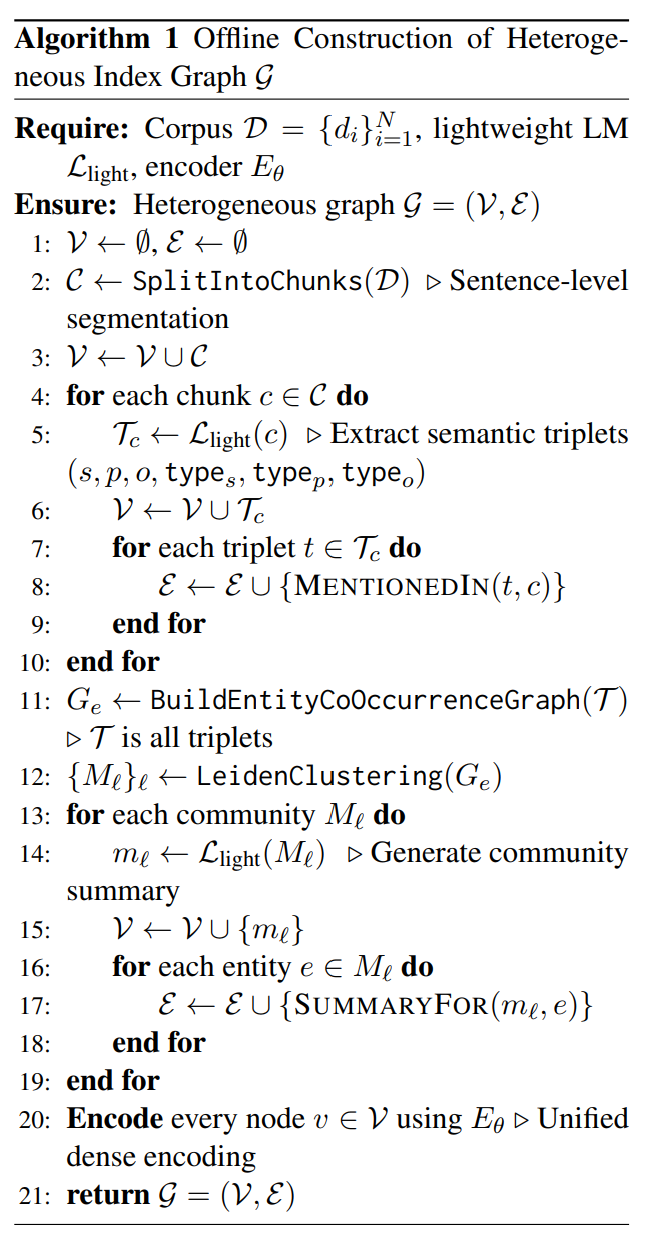
算法流程解读:
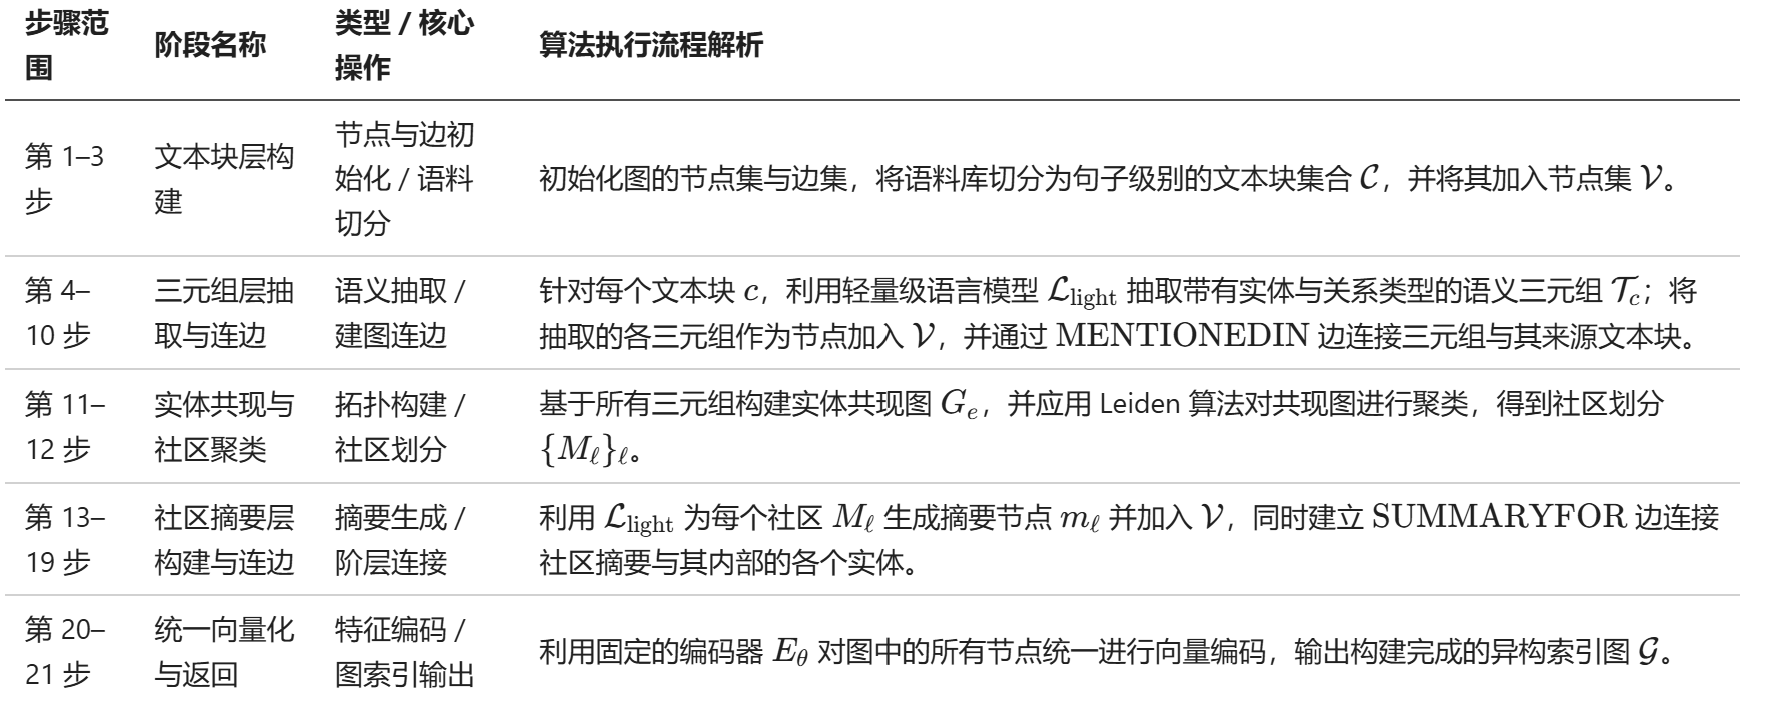
2.3 MACER 机制:多智能体上下文演化与检索
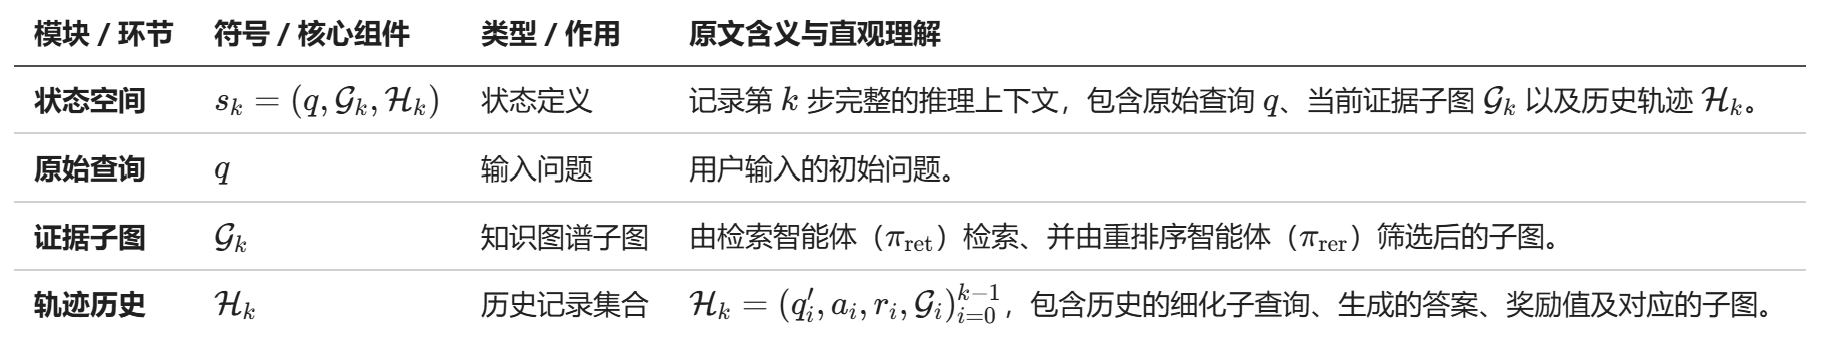
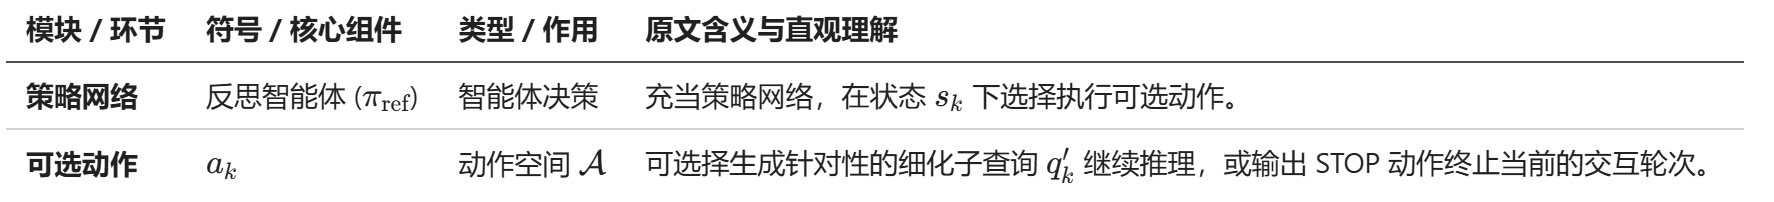
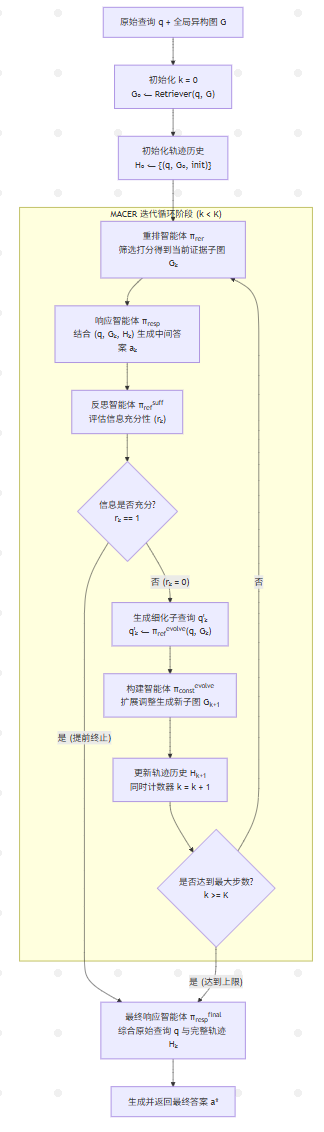
ToG-3 系统的核心就是 MACER 在线循环,一个结合了检索、生成与反思的迭代过程。其目标是在推理过程中动态演化上下文子图 Gk 。作者将这一过程建模为了分段马尔可夫决策过程,其形式化定义为 M = (S, A, P, r) 。
状态空间(State Space, S)
动作空间(Action Space, A)与策略网络
奖励函数(Reward Function, r)
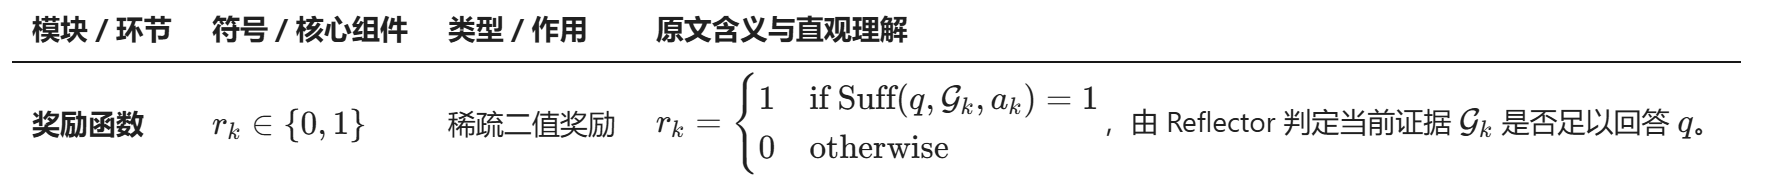
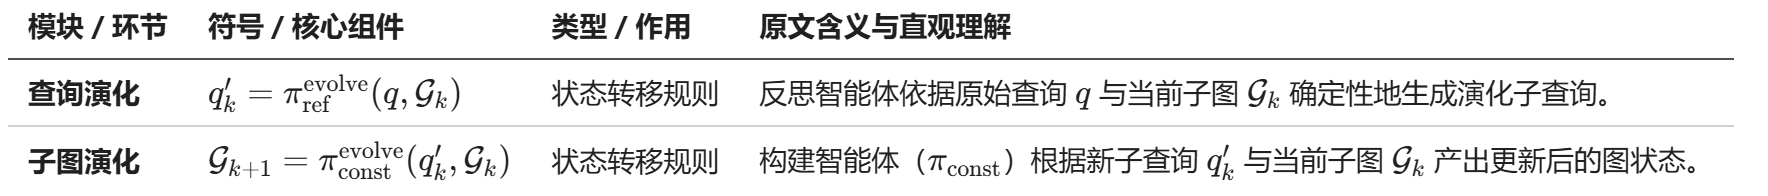
状态转移机制(Transition Dynamics, P)
在当前状态 sk 和执行动作 ak(对应发出细化子查询 q'k )的前提下,状态向 sk+1 的转移是确定性进行的:
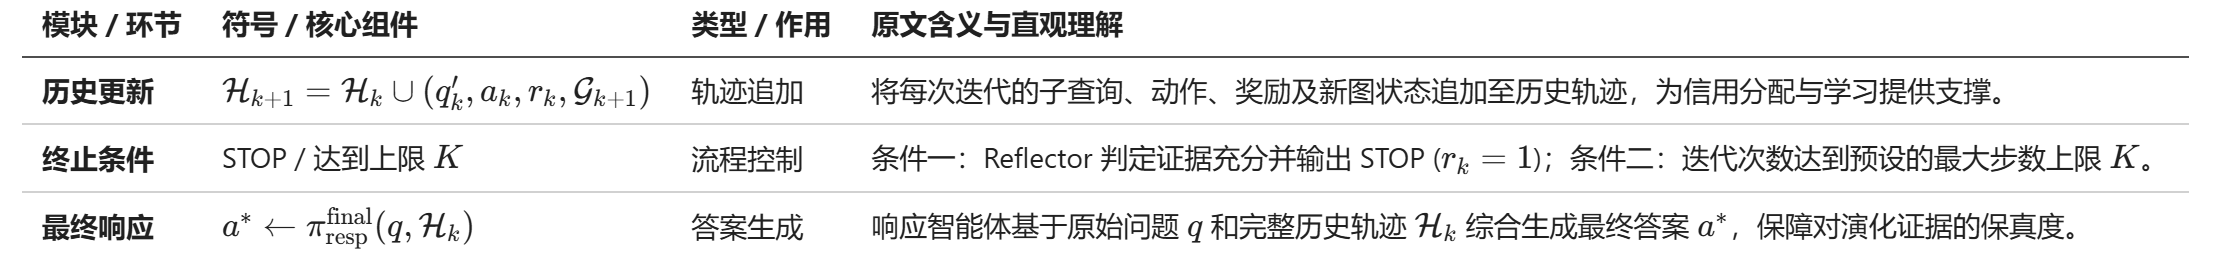
轨迹历史记录与最终响应生成
MACER 机制的优点:
向特定查询子图收敛:
理论上在温和假设下具备收敛性。
即使初始构建的图结构较弱,系统也能通过迭代精炼将其特化至特定查询的推理路径上,最终收敛至高质量的证据子图 G*q 。
缓解小模型在静态 GraphRAG 中的三大固有缺陷:
三元组召回不完整。
知识细节不足。
模型输出解析失败率高。
具体算法如下所述:
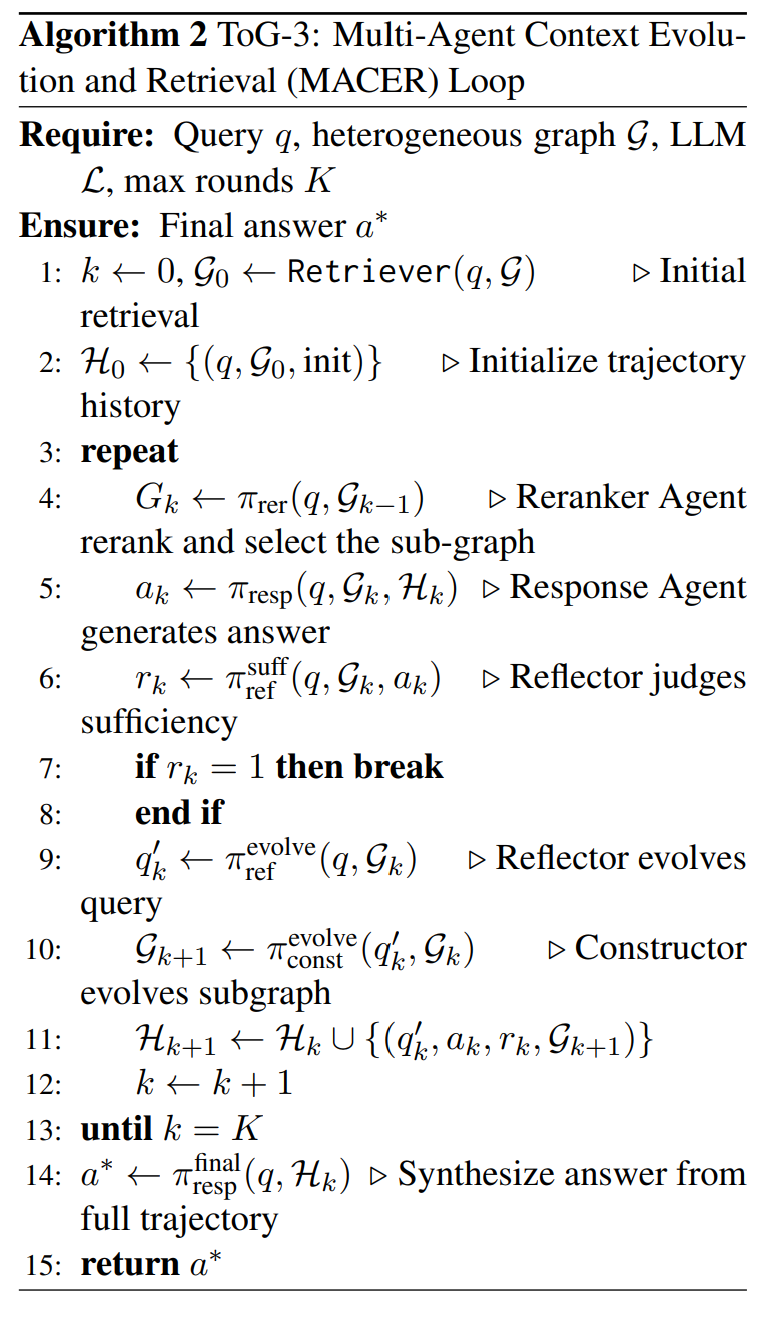
可以参考以下流程图以直观了解 MACER 算法:
此外,下图给出了 ToG-3 的主要流程:
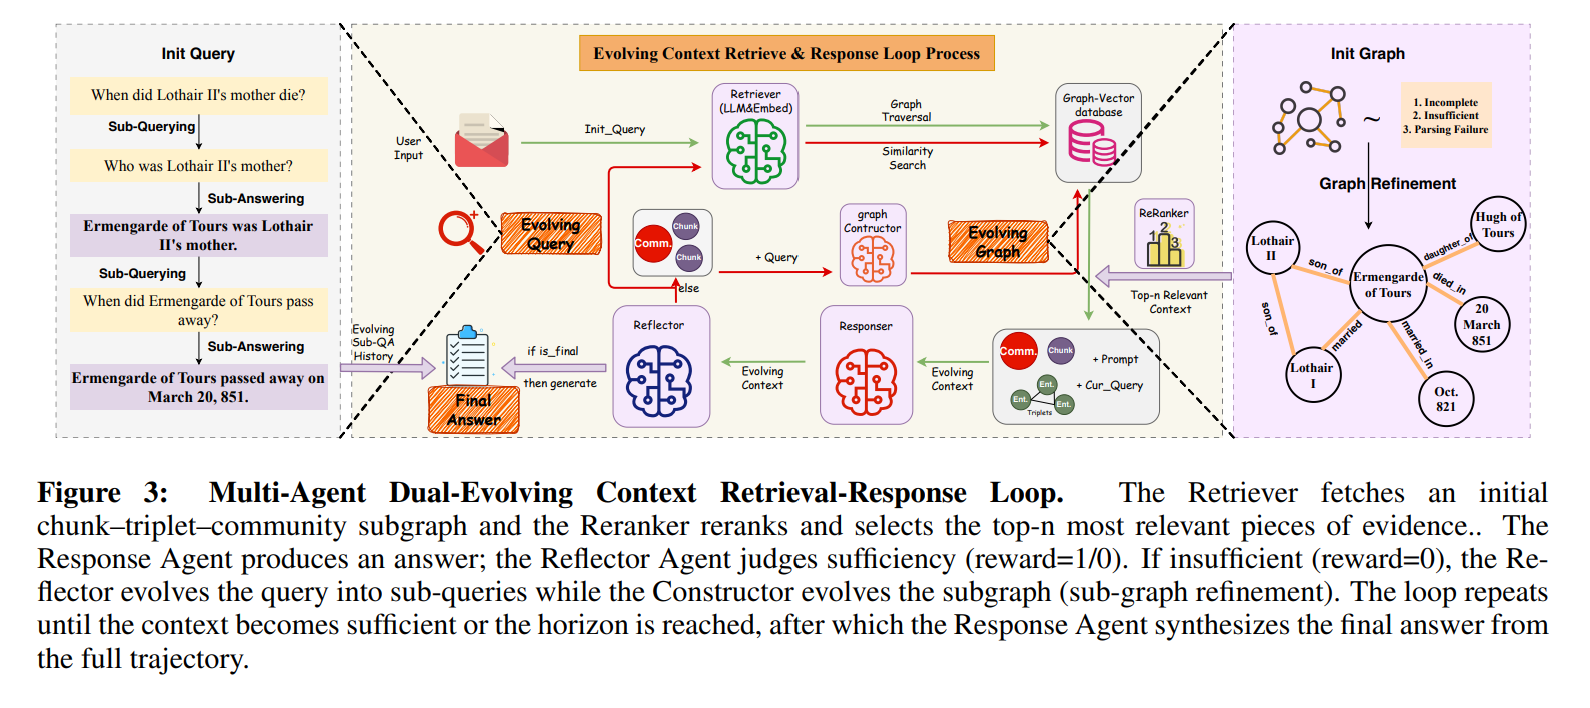
我的理解:ToG-3 的核心思想
宏观推理闭环的延续:
ToG-3 继承了 Think-on-Graph 的经典范式,形成“检索图谱 -> 获取上下文 -> 评估证据充分性(二值奖励信号) -> 继续演化检索 / 综合生成最终响应”的闭环决策流程。
核心改进:查询与子图的双重演化紧耦合:
相较于早期在静态图结构上的路径搜索,ToG-3 通过 MACER 将演化推进至“图结构”与“子查询”的协同演进:
查询演化(q'k):反思智能体(Reflector Agent)根据当前上下文与问题差距,自主拆解并生成针对性的细化子查询。
子图演化(Gk+1):构建智能体(Constructor Agent)依据新的子查询动态更新图结构,使证据子图逐步向当前查询所需的推理路径收敛。
轨迹历史(Hk)的本质定义:
将多轮推理过程形式化为马尔可夫决策过程(MDP)的轨迹,该历史记录由 子查询(q'k)、阶段动作/答案(ak)、充分性奖励(rk) 与 结构化子图证据(Gk+1) 共同构成,既为每一步的状态转移与信用分配提供依据,也是最终生成保真答案(a*)的完整上下文支撑。
3. 实验与结果
3.1 基础配置
3.2 深度推理任务实验结果
以下结果均为 3 次独立推理实验的平均值。
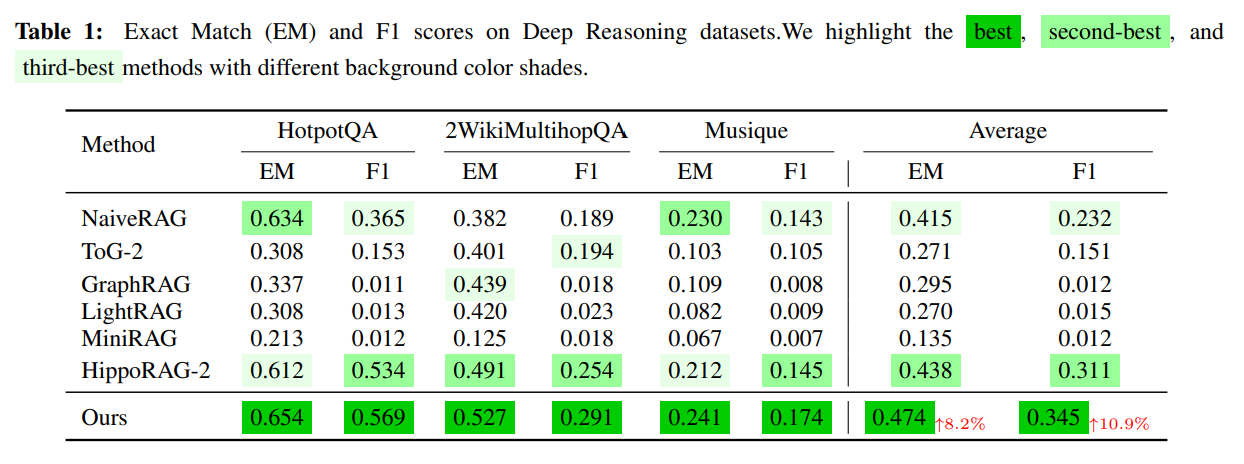
方法视角的对比分析
GraphRAG 等基于大模型建图的方法:
表现情况:在对比中表现处于最低水平,尤其在 F1 分数上最低。
原因归结:缺乏对深层事实推理的针对性关注,且倾向于生成冗长回复,从而导致 token 级别的召回率偏低。
ToG-2:
表现情况:在没有 Freebase 和 Wikidata 等高质量人工构建知识图谱支持的开放域环境下,表现处于中等水平。
NaiveRAG:
表现情况:取得了排在第三位的表现。
优势原因:避开了大模型建图质量受限的问题,仅依靠检索到的文档块来生成回答。
HippoRAG-2:
表现情况:是表现最强的基准模型(排名第二)。
核心技术:结合了高效的 Embedding 模型、Personalized PageRank (PPR)算法以及基于 LLM 的三元组过滤机制。
ToG-3(本文提出的方法):
表现情况:在所有对比方法中表现最佳,在三个基准测试上的平均 EM 为 0.474,平均 F1 为 0.345。
优势归因:
采用了 Chunk-Triplets-Community 异构图架构。
MACER 框架支持面向复杂推理任务的自适应子图精炼与演化查询分解。
克服了其他基于图的 RAG 系统在图构建阶段所面临的质量瓶颈。
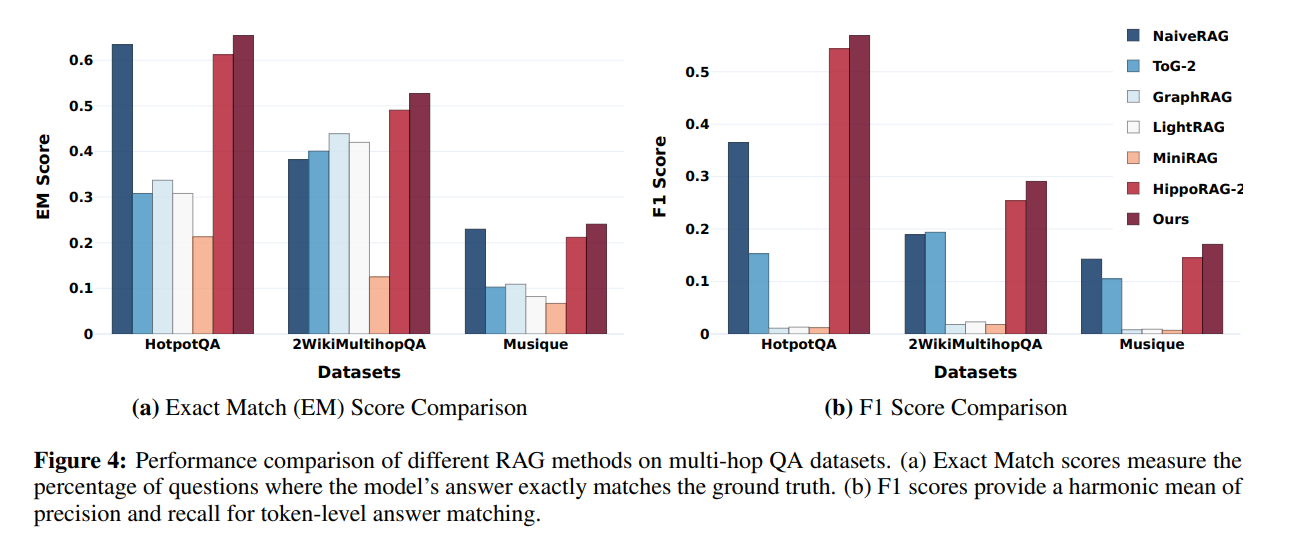
数据集视角的对比分析
整体表现趋势:
各基准模型与 ToG-3 的平均性能在 HotpotQA -> 2WikiMultiHopQA -> Musique 数据集上整体呈现逐步递减的趋势。
各数据集的特性与难度差异:
HotpotQA:虽然被广泛使用,但文献表明该数据集中存在较多的虚假线索与捷径信号,对多跳推理能力的测试相对较弱,因此整体得分相对最高。
Musique:难度较高,主要涵盖约 2–4 跳的推理需求,强调对多步推理能力的全面评估;其设计具备多样且复杂的推理路径,必须通过整合多跳信息才能得出正确答案,因此在三个数据集中得分普遍最低。
3.3 广度推理任务实验结果
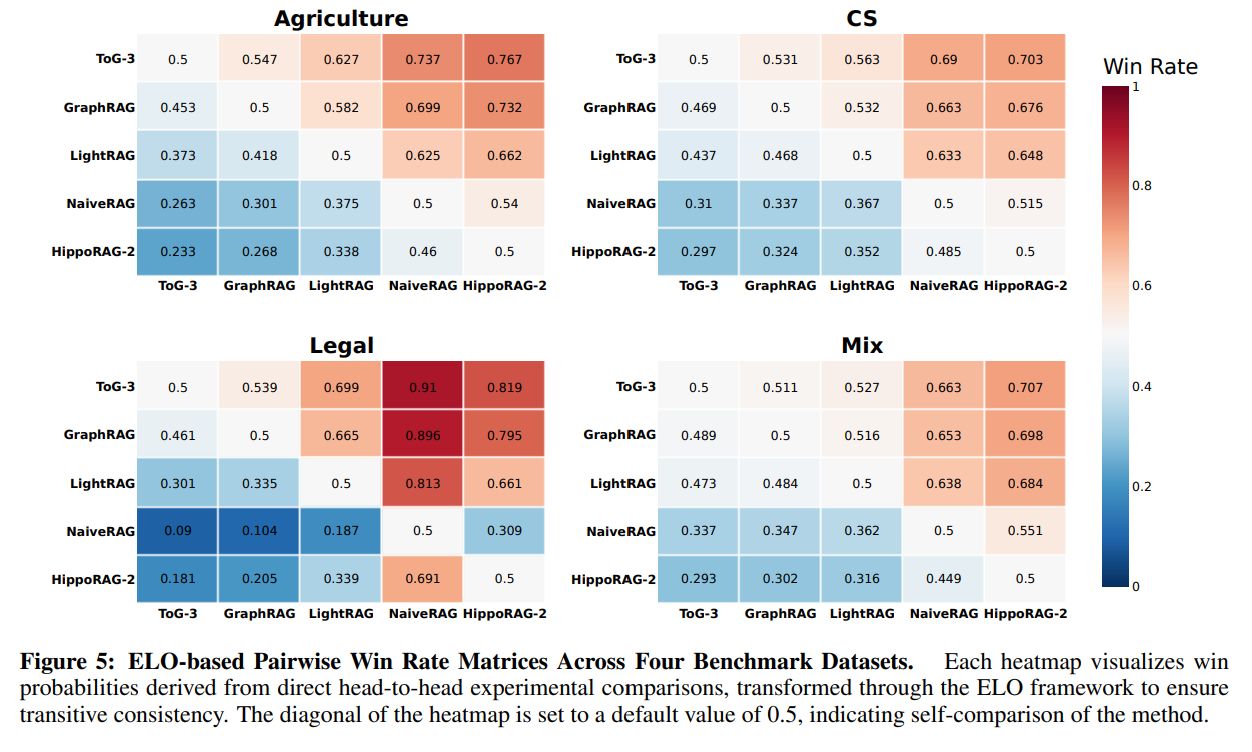
性能聚类与胜率表现
对比方法呈现明显的两个层级聚类:
优异表现梯队(右上区域):ToG-3、GraphRAG 与 LightRAG,其整体胜率显著高于其他方法。
较低表现梯队(左下区域):NaiveRAG 与 HippoRAG-2。
此外,ToG-3 在全部 4 个数据集上对 NaiveRAG 的平均胜率达到 75.0%,表明纯文本块检索在处理宏观复杂查询时存在局限性。
评估维度的细化对比
Comprehensiveness(完整性):
GraphRAG 依托大范围的社群摘要与检索,在完整性指标上表现出较强的竞争力。
Diversity(多样性)与 Empowerment(启发性):
ToG-3 在各项指标之间取得了更优的平衡,在多样性与启发性维度上表现更为突出。
优势归因:得益于其异构图架构融合了文本块、三元组与社群三层不同粒度的信息。
推理能力的双重覆盖
MACER 的多智能体双重演化检索机制同时兼顾了两种推理需求:
深度知识推理:通过实体-关系路径探索实现。
广度上下文推理:通过多层级社群摘要聚合实现。
演化迭代轮次统计分布
作者对样本在演化上下文检索循环中所消耗的迭代次数进行了统计:
1 轮迭代:占测试样本的 20%
2 轮迭代:占测试样本的 32%
3 轮迭代:占测试样本的 48%
该分布表明,接近一半的样本需要经过 3 轮迭代演化来获取充足的证据支持。
3.4 消融实验
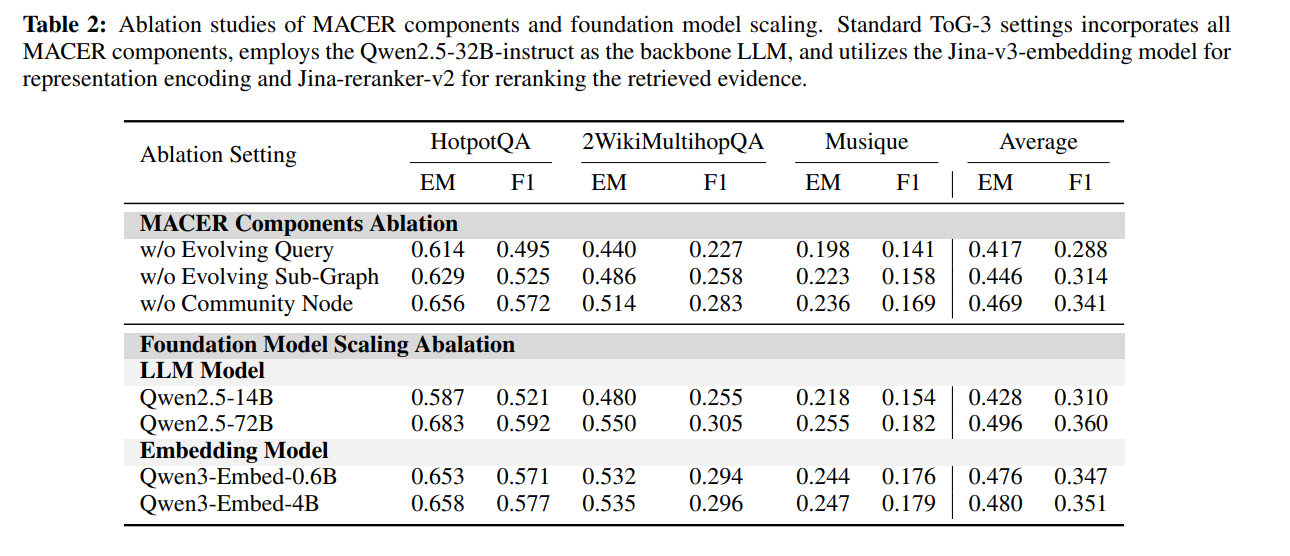
对 MACER 组件的消融
1. 查询演化机制 —— 贡献最显著
性能变化:移除查询演化机制后,模型性能出现最大幅度的下降,平均 EM 下降 12.0%,平均 F1 下降 16.5%。
作用分析:证明了查询演化在复杂问答中的核心作用,特别是在搭配小规模 LLM 作为底座时,该机制对推理性能的支撑尤为关键。
2. 子图精炼机制 —— 中等幅度影响
性能变化:移除子图演化精炼机制后,平均 EM 下降 6.0%,平均 F1 下降 9.0%。
作用分析:表明该机制能够使图谱知识结构更好地适应当前的特定推理上下文。
3. 社群节点 —— 粒度互补
在深度推理任务中:移除社群节点对深度推理任务的影响最小(EM 与 F1 仅轻微下降)。这是因为在精准答案生成任务中,文本块与三元组层级的表征承载了绝大部分关键信息。
在广度推理任务中:社群节点对于提供全面的覆盖度与多样性不可或缺。这体现了异构图架构中不同粒度节点之间的互补性。
4. 重排智能体——降噪与质量控制
性能提升:引入重排智能体为系统带来了 EM 提升 4.6%、F1 提升 10.6% 的增益。
机理分析:在多轮 RAG 交互过程中,过量检索出的证据可能会干扰响应智能体(Response Agent)的输出质量,重排智能体有效控制并筛选了证据输入。
对基座模型的消融
1. LLM 容量对性能的影响更为显著
扩展收益:底座 LLM 的参数规模从 Qwen2.5-14B 扩展至 Qwen2.5-72B 时,平均 EM(精确匹配)分数提升了 15.9%。
原因分析:大模型容量对最终效果的影响明显大于嵌入模型的尺寸,反映出推理能力在复杂问答任务中起到了决定性作用。
2. 嵌入模型提供持续但相对平缓的增益
模型对比表现:
Qwen3-Embed-0.6B 相比 jina-embeddings-v3 展现出轻微的平均 EM 提升。
Qwen3-Embed-4B 则带来了 1.7% 的 EM 提升。
增益特征:更大的嵌入模型能带来稳定且持续的性能增益,但提升幅度相对温和。
3. 核心结论与工程落地指导
主要瓶颈定位:虽然检索质量至关重要且更大的嵌入模型有助于提升表现,但在复杂推理任务中,大语言模型的推理能力依然是核心的性能瓶颈。
资源分配指导:在实际业务部署与资源受限的环境中,应优先将算力资源分配给推理能力更强的 LLM 底座,以实现更高的收益产出比。
4. 结论
作者在这项工作中提出了 Think-on-Graph 3.0,这是一个从根本上重新审视面向复杂推理的 RAG 范式的新型框架。通过提出多智能体上下文演化检索(MACER)机制以及动态的“文本块-三元组-社群”(Chunk-Triplets-Community)异构图架构,作者解决了现有基于图的 RAG 方法以及依赖预建知识图谱方法中所存在的关键局限。全面的实验评估表明,ToG-3 在多个具有挑战性的基准测试中均取得了前沿的表现。事实证明,这种自适应能力在克服静态图构建的质量约束以及既有知识库的领域局限方面具有重要价值。此外,该框架适配轻量级大语言模型的能力,也为构建更高效率、更易落地部署的 AI 系统提供了可能。