

继研读 HippoRAG 之后,继续研读其续作 HippoRAG-2 :《From RAG to Memory: Non-Parametric Continual Learning for Large Language Models》
开源实现:HippoRAG-2
1. 为什么要引入 HippoRAG-2 ?
持续吸收、整合与运用知识的能力是人类智能的重要特征。AI 系统若要成为达到人类水平的实用助手,必须具备逼近这种持续学习的能力。虽然 LLM 在多项人类智能任务中取得了进展,但由于其参数化知识具有复杂的分布特性,在赋予其演进的长期记忆能力时面临两项主要挑战:
难以完全吸收新知识。
难以避免灾难性遗忘。
RAG 系统通过非参数化方式使模型获取新信息,无需修改大语言模型本身的参数表征,从而规避了上述参数层面的难题。基于其简洁性与鲁棒性,RAG 已成为实际生产环境中大模型系统实际上采用的持续学习解决方案。然而,由于传统 RAG 系统依赖于简单的向量检索,导致其无法捕捉人类互联长期记忆系统中的两个关键维度:
意义构建:解释规模更大、更复杂或存在不确定性的语境的能力。
联想能力:在彼此分散的知识片段之间建立多跳连接的能力。
为了解决前述局限,近期部分方法利用大语言模型显式构建检索语料的结构:
针对意义构建:利用大模型生成文本摘要(如 RAPTOR 等工作)或构建知识图谱结构,将分散但相关的段落连接起来,以提升系统理解长篇、复杂语境(如长故事)的能力。
针对联想能力:HippoRAG 结合了 Personalized PageRank 算法(PPR 算法)与大模型自动构建知识图谱的能力,赋予检索过程多跳推理能力。
要使 RAG 真正逼近人类长期记忆,系统必须在基础记忆任务上也具备稳健性。因此,作者设计了综合评测,同时覆盖三类任务:
联想能力:通过多跳问答进行评估。
意义构建:通过大规模篇章理解进行评估。
事实性记忆:通过简单问答进行评估(这类任务是标准 RAG 本身擅长处理的)。
实验结果如下图展示:
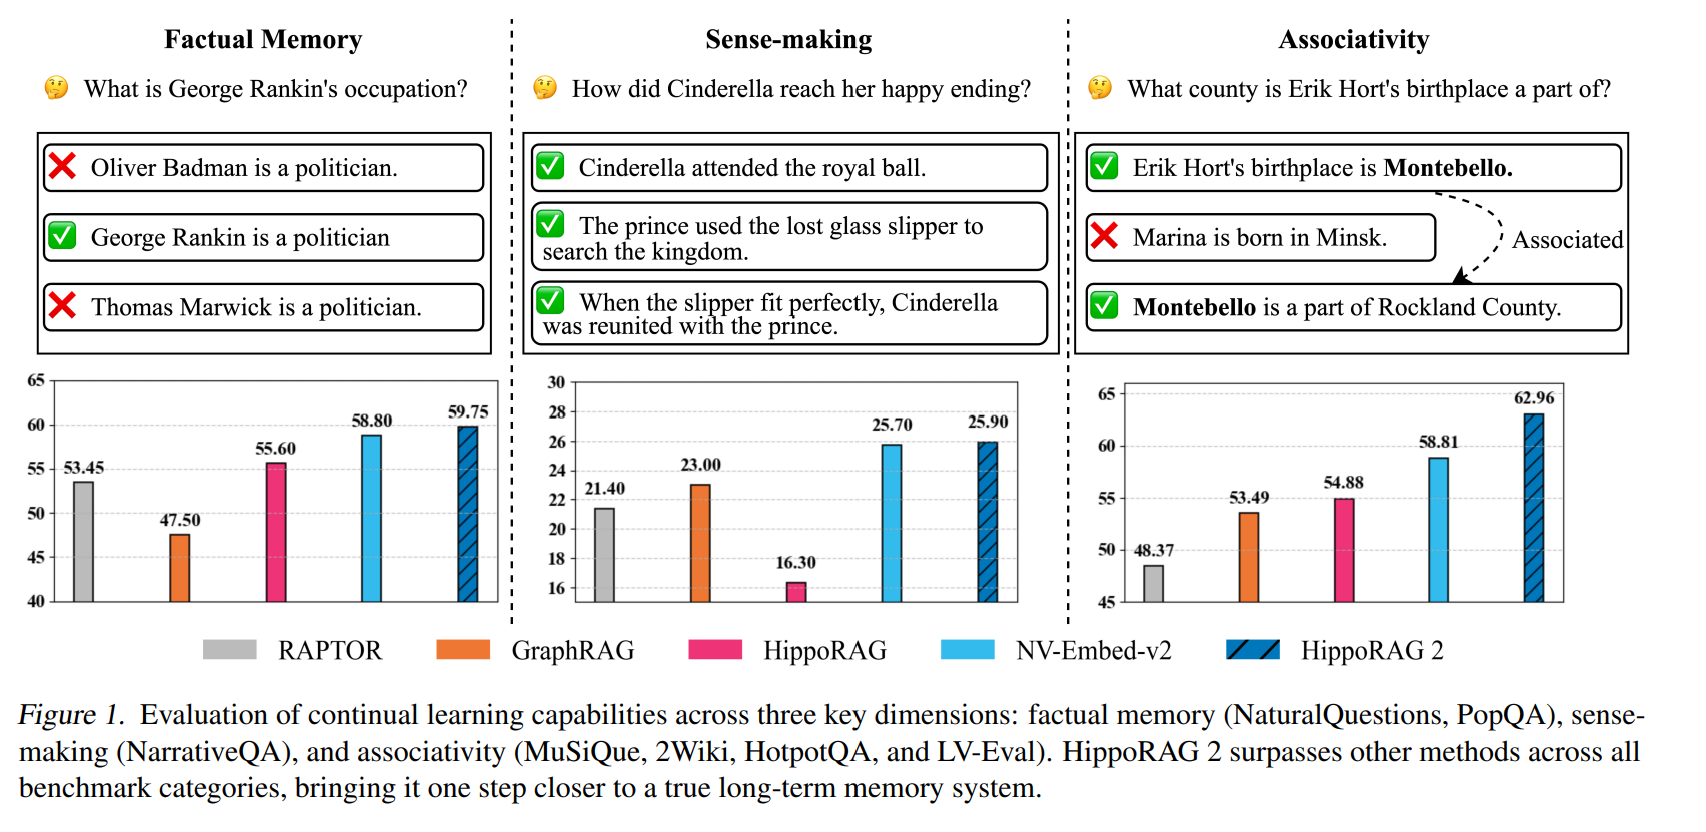
先前所有的结构增强方法在全部三类基准测试中,表现均逊于当前最强的嵌入式 RAG 方法:
任务外性能衰退:各类方法在自身原始实验设定之外的任务上,均出现了最显著的性能衰退。
HippoRAG 的不足:在大规模篇章理解任务上表现下降最为明显,原因在于其缺乏基于查询的上下文关联。
RAPTOR 的不足:在简单问答与多跳问答任务上性能显著受损,原因在于其大模型摘要机制向检索语料库中引入了噪声。
基于此,作者引入了 HippoRAG-2 。HippoRAG-2 继承了前作中的开放信息抽取与 PPR 算法,并针对“缺乏基于查询的上下文关联”这一缺陷提出了三项关键改进:
段落融入图搜索:将文本段落直接整合进 PPR 图搜索过程中。
深化查询引导:让查询更深地参与到知识图谱三元组的筛选过程中。
在线大模型过滤:在在线检索阶段引入大语言模型,用于识别并过滤不相关的检索三元组。
在全面的实验评估中,HippoRAG-2 相比最强的标准 RAG 方法展现出全面的优势:
联想记忆任务:相比标准 RAG 取得了平均 7 个百分点的提升。
事实记忆与意义构建任务:未出现其他结构化方法中常见的性能退化,甚至取得了小幅提升。
此外,该框架对不同的检索器具有稳健性,且兼容强力开源模型与闭源商业大模型,具备广泛的应用灵活性。这些结果表明 HippoRAG 2 为大语言模型构建更贴近人类特性的“非参数化持续学习系统”提供了可行的演进方向。
2. HippoRAG-2 建模
2.1 概述
从 HippoRAG 到 HippoRAG-2
HippoRAG 框架由三个主要组件协同工作,模拟人类长期记忆的交互机制:
LLM :对应人工新皮层,负责高级语言理解与信息抽取。
知识图谱(KG)与 PPR 算法:对应人工海马体,模拟海马体的自联想特性,负责拓扑关联与多跳图搜索。
检索编码器:对应海马旁区,连接大模型与知识图谱,并在图构建中负责同义词检测以实现信息互联。
此外,HippoRAG 系统包含离线索引与在线检索两个阶段:
离线索引:LLM 将文本段落处理为知识图谱三元组存入图谱;检索编码器识别同义实体建立语义边连接。
在线检索:LLM 从用户查询中抽取查询命名实体;检索编码器在图谱中找到语义最相近的节点作为种子节点;将种子节点赋予重置概率运行 PPR 算法,使概率向种子节点及其邻域扩散,实现上下文检索。
核心缺陷:v1 采用了以实体为中心的处理方式。该设计使得系统在索引与推理阶段都会产生上下文丢失,并造成语义匹配上的困难。
HippoRAG-2 延续了离线索引与在线检索的两阶段框架,但引入了三项对齐人类记忆机制的关键改进:
概念与上下文信息的无缝融合:在知识图谱中同时整合概念信息与上下文信息,提升所构建索引的完备性与原子性。
超越孤立节点的上下文感知检索:不再局限于孤立的图节点,而是利用更丰富的图结构实现更具上下文感知的检索过程。
引入再认记忆机制:引入再认记忆,优化图搜索中种子节点的选择与过滤。
离线索引阶段
离线阶段将原始文本转换为同时包含结构化概念与完整上下文的异构知识图谱,分为三个步骤:
第一步:无模式三元组抽取
使用大语言模型通过开放信息抽取(OpenIE)从每个段落中提取三元组,抽取过程不受预设 Schema 或实体关系类型的限制。
三元组中的主语与宾语被称为短语,连接两者的边称为关系边,共同构成无模式知识图谱。
第二步:同义词之间的语义边连接
检索编码器评估图谱中所有短语对的向量相似度。
当相似度超过预设阈值时,在短语对之间建立同义词边,从而跨越不同段落连接同义概念,支持新旧知识的持续整合。
第三步:融合原始段落
将上述基于短语的知识图谱与原始文本段落结合,使最终构建的开放图谱同时囊括概念信息与语境信息。
在线检索阶段
在线阶段利用查询引导图搜索,经过四个步骤最终召回相关文本:
第一步:候选种子节点关联
检索编码器将用户查询与图中的相关三元组及段落进行语义关联,识别出可作为图搜索的候选种子节点。
第二步:再认记忆过滤
引入再认记忆机制作为过滤器,对召回的三元组进行相关性甄别,仅保留与查询相关的三元组作为最终的种子节点。
第三步:PPR 传播
将筛选出的最终种子节点分配重置概率,运行 PPR 算法在异构图中传播概率,细化关联结果并对最相关的段落进行排序与检索。
第四步:生成问答
将最终检索出的相关段落作为上下文输入给 LLM ,完成问答任务。
2.2 核心机制一:稠密-稀疏融合
HippoRAG 的图节点主要由描述概念的“短语节点”构成。这一图结构的局限性源自以下概念-语境权衡:
概念:简洁且易于泛化,但抽离后会带来信息损失。
语境:提供塑造概念理解和应用的具体情境,语义丰富但复杂度较高。
事实上,人类大脑通过稠密编码与稀疏编码理论在不同粒度上表征信息:
稀疏编码(Sparse Coding):仅激活极少数神经元,具备高效率与存储紧凑性。
稠密编码(Dense Coding):通过大量神经元的同时激活,形成分布式且具有冗余度的表征。
HippoRAG-2 将上述脑科学编码机制映射到了知识图谱的设计中:
稀疏编码:对应图谱中抽取的短语节点,承载高层抽象概念。
稠密编码:对应概念所来源的原始段落,通过嵌入模型进行向量编码,承载具体语境。
在离线索引阶段,图构建的拓扑结构进行了如下扩充:
段落节点:语料库中的每一个文本段落都被作为一个独立的段落节点加入知识图谱。
语境边:在段落节点与其抽取出的所有短语节点之间,建立一条标记为 contains 的关联边。
该方法保留了与 HippoRAG 相同的离线信息抽取流程,仅在构图阶段扩充了段落节点与语境边。
2.3 核心机制二:更深层次的语境化关联
HippoRAG 依赖命名实体识别解析查询,这种实体抽取方式主要聚焦于“概念”,忽略了查询与知识图谱内部的语境对齐。单纯抽取孤立实体使得许多潜在的语境信号未被充分利用,导致图搜索的初始入口缺乏对完整语义环境的把握。
为了更有效地将查询语义与图搜索的起始节点对齐,作者探索并评估了三种不同的映射方式:
NER to Node(原始 HippoRAG 方案):
先从查询中抽取实体,再使用文本嵌入将这些实体与知识图谱中的节点进行向量匹配。
Query to Node(整体查询对齐节点):
不提取单独的实体,而是直接使用文本嵌入将整个查询语句与知识图谱中的节点进行匹配。
Query to Triple(整体查询对齐三元组):
使用文本嵌入将整个查询语句直接与知识图谱中的三元组(Triples)进行匹配。
HippoRAG-2 默认采用 Query to Triple 方案作为图搜索的起点,因为三元组本身封装了概念之间的基础关系与语境,因此将整句 Query 映射到三元组能够更全面地理解用户的查询意图。当然,作者也在实验中对上述三种方法进行了对比评测。
2.4 核心机制三:再认记忆机制
人类记忆检索包含两个互补的过程:
回忆(Recall):在没有外部提示的情况下主动检索信息。
再认(Recognition):借助外部刺激的帮助来识别并确认信息。
基于上述理论,HippoRAG-2 将 “Query to Triple” 细化为两步操作:
第一步:向量粗筛
使用嵌入模型(Embedding Model)根据整句查询计算向量相似度,从知识图谱中检索出得分最高的 Top-k 个候选三元组集合 T 。
第二步:三元组过滤
利用 LLM 充当再认过滤器,对候选集合 T 进行相关性甄别与去噪,输出过滤后的高质量三元组子集 T' ⊆ T。
2.5 在线检索
在线检索的核心任务是:确定图中的种子节点,并为这些种子节点赋予初始的重置概率,以驱动 PPR 算法的图搜索。
种子节点的选取
种子节点由两部分组成:短语节点与段落节点。
短语节点选取:
从前文经过“Query-to-Triple 粗筛 + 再认记忆过滤”后保留的三元组中提取短语节点。
若筛选后的三元组有效,系统根据短语节点在其来源三元组中的平均排序得分,最多选取前 k 个短语节点作为种子节点。
回退机制:如果没有可用的三元组,系统将直接通过嵌入模型检索排名靠前的段落作为结果。
段落节点选取:
所有段落节点也会被作为种子节点纳入初始化。
原因:更广泛的初始激活范围有助于提升多跳推理能力。
重置概率的分配
为了让 PPR 算法合理传播概率,系统对两类种子节点采用了不同的概率赋值与平衡策略:
短语节点概率:依据其在过滤三元组中的排序得分进行分配。
段落节点概率:赋予与该节点和用户查询之间的向量嵌入相似度成正比的得分。
权重因子调节:通过引入一个权重因子,动态调节并平衡短语节点与段落节点对整体图传播的影响力。
图搜索与下游输出
执行 PPR 搜索:以分配好概率的短语节点和段落节点为起点运行 PPR 算法。
段落排序与输出:算法根据最终收敛的 PageRank 得分对所有段落进行排序,得分最高的段落将被提取并作为上下文,送入 LLM 完成最终的问答任务。
3. 实验与结果
3.1 实验配置
Baselines
数据集与评测指标
数据集
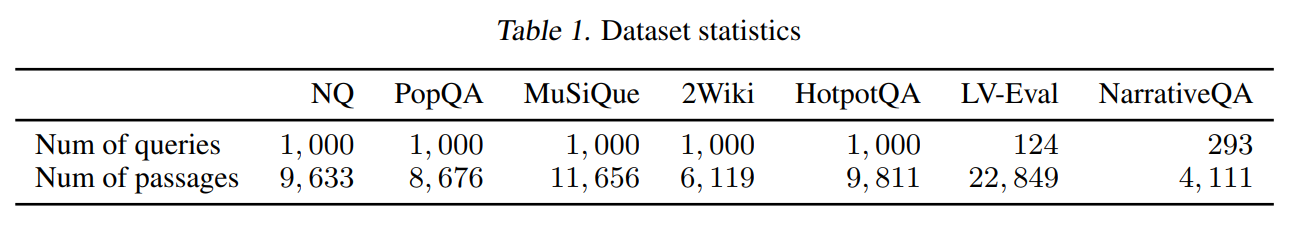
评估指标
检索阶段指标:采用 Passage Recall@5(即检索出的前 5 个文本段落中命中标准答案支撑段落的比例),沿用 HippoRAG 的评估规范。
问答生成阶段指标:采用基于词级别的 Token-based F1 分数,沿用 MuSiQue 的评估标准。
实施细节
3.2 对比实验结果
问答实验结果
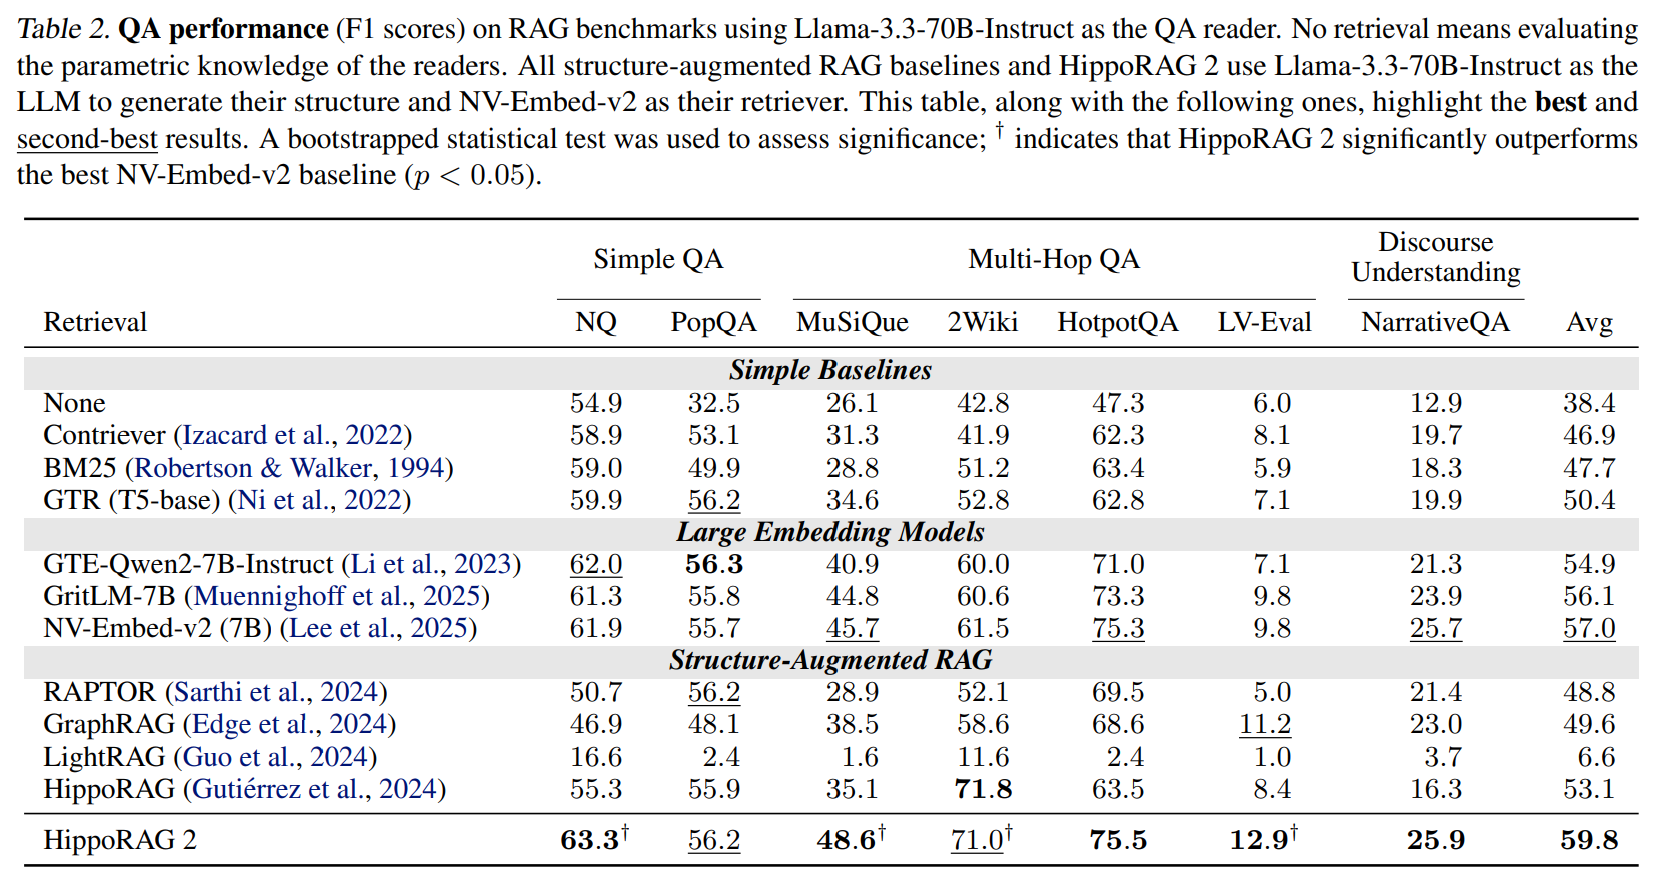
实验结论:
在以 Llama-3.3-70B-Instruct 作为下游问答阅读器(QA reader)的测试中,HippoRAG-2 取得了最高的平均 F1 分数,在各类基准测试中展现出跨场景的稳健性。系统在主要环节(抽取、过滤、问答)完全采用开源模型(Llama-3.3-70B-Instruct)驱动,达到了 SOTA 的表现。
大型嵌入模型明显优于小型模型,其中 7B 参数的 NV-Embed-v2 平均 F1 分数比基于 T5-base 的 GTR 高出 6.6% 。这表明,大型嵌入模型以更低的计算成本超过了先前的结构增强型 RAG 方法,但它们的优势主要集中在简单问答任务上,面对复杂推理任务时表现受限。
相较于当前最强的单模型嵌入基线 NV-Embed-v2,HippoRAG-2 在复杂任务上取得了显著优势:
在 2Wiki 数据集上,F1 分数提升了 9.5% 。
在极具挑战性且降低了数据泄漏风险的 LV-Eval 数据集上,F1 分数提升了 3.1% 。
相比前作 HippoRAG,HippoRAG-2 的提升幅度更为明显。
检索实验结果
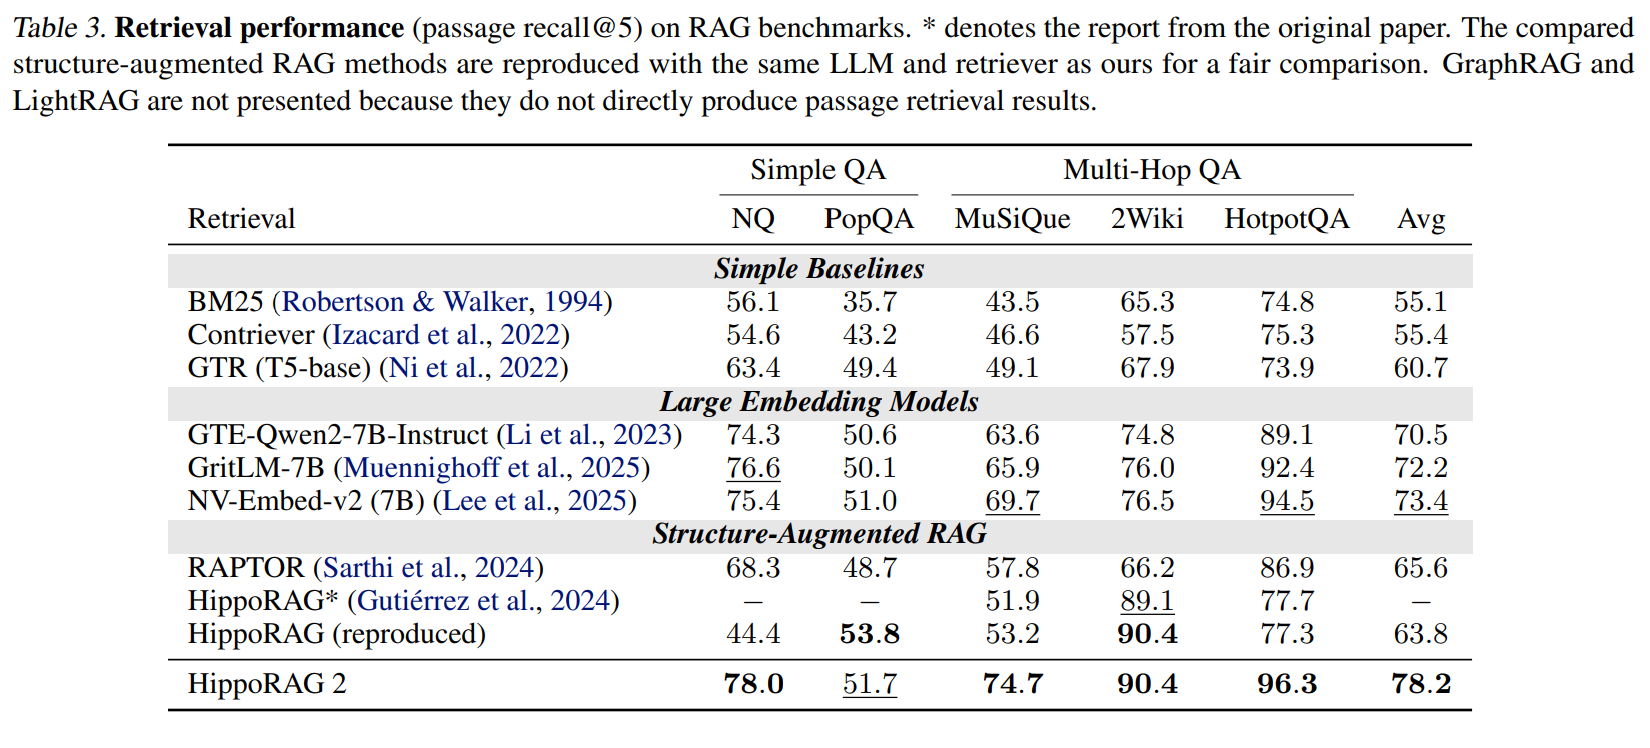
实验结论:
7B 参数规模的大型嵌入模型表现优于 Contriever 与 GTR 等早期小型模型,在相关指标上至少高出 9.8% 。
使用 Llama-3.3-70B-Instruct 与 NV-Embed-v2 对原版 HippoRAG 进行复现后,相较原论文仅获得微幅提升。不过,原始 HippoRAG 在以实体为中心的检索中表现突出,在 PopQA 上取得了最高的 Recall@5,但在多数综合任务中仍落后于前沿的稠密检索器及 HippoRAG-2 。
HippoRAG-2 在绝大多数数据集上均取得了最高的召回率指标。此外,相比当前最强的稠密检索基线 NV-Embed-v2,HippoRAG 2 在多跳推理数据集上的 Recall@5 表现出显著增益:
在 MuSiQue 上 Recall@5 提升了 5.0% 。
在 2Wiki 上 Recall@5 提升了 13.9% 。
3.3 补充实验
消融实验
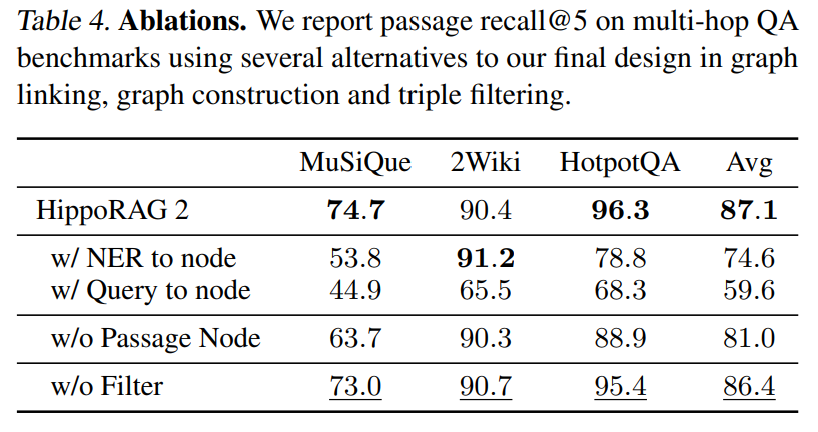
实验结果:
针对连接方式、图构建方式与三元组过滤机制的消融结果表明,HippoRAG-2 引入的各项机制均对系统性能构成了正向支撑。
在实验中,NER-to-Node 与 Query-to-Node 均未施加过滤步骤;但无论是否使用过滤,Query-to-Triple 的表现均优于另外两种连接策略。相较于原版的 NER-to-Node,Query-to-Triple 使得 Recall@5 平均提升了 12.5% 。
将整句 Query 直接匹配到单个图节点(Query-to-Node)相比 NER-to-Node 并没有体现出优势。
归因分析:整句 Query 与知识图谱中的单个节点处于不同的语义粒度层级;相比之下,NER 抽取出的实体与图节点同属于短语级别表征,而三元组则包含关系与结构,更能承接完整 Query 的语义。
重置概率的控制
在图搜索初始化阶段,系统中同时存在短语节点与段落节点两类种子节点。实验发现,必须平衡这两类节点在 PPR 过程中的重要性,以保证图传播的合理性。具体而言,系统将所有段落节点的重置概率乘以一个权重因子,以此调节段落节点相对于短语节点的影响权重。
以下是实验结果:
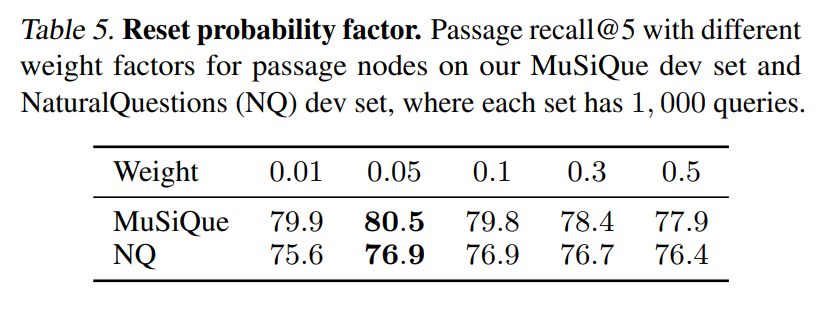
综合考虑模型在不同测试场景下的表现,作者将该权重因子的默认值设定为 0.05 。
持续学习场景
本实验探讨了在语料库持续扩充(持续学习场景)下,HippoRAG-2 与最强向量基线(NV-Embed-v2)的鲁棒性表现。
实验设计方式:
现实需求:在实际落地场景中,RAG 系统的外部知识库是持续增长的,系统需要具备在非参数化持续学习下的适应能力。
数据切分:将 NQ(简单事实) 与 MuSiQue(多跳联想) 数据集分别均分为 4 个等份,每个分段包含约 250 个问题对应的正确文档和干扰文档。
动态评测流程:固定选取其中一个分段作为测试集,随后逐步增量加入其余三个分段的语料,通过监测知识规模扩大时的 F1 分数变化,模拟真实的持续学习过程。
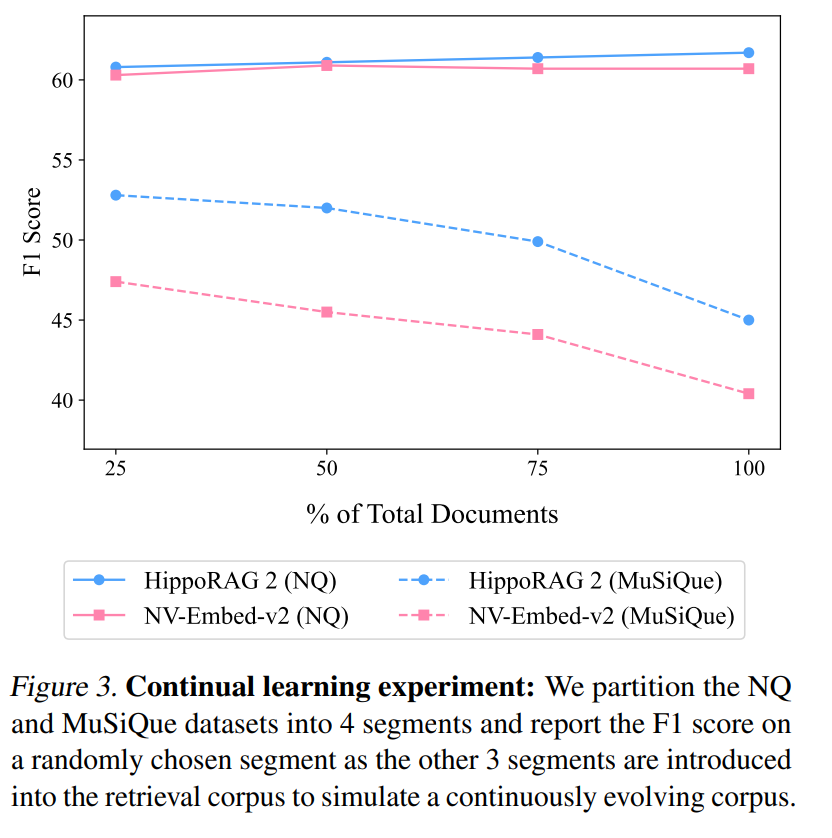
随着语料库规模逐级递增,在简单任务(NQ)与多跳任务(MuSiQue)中,HippoRAG 2 相较于 NV-Embed-v2 的性能提升幅度均保持稳定。然而,任务复杂度的不同导致出现了分化现象:
简单事实问答(NQ):随着更多文档与干扰信息的引入,两种方法均能保持较为稳健的性能。
复杂多跳联想(MuSiQue):随着语料库扩大,两种方法在多跳推理上的性能均出现了一定程度的同步衰退。
该实验表明,语料库扩充对简单单跳事实检索与跨文档多跳推理的影响程度并不相同。作者指出,未来的持续学习评测基准必须涵盖多样化的任务复杂度,仅依赖简单事实问答无法全面反映检索系统在持续扩展场景下的真实能力。
不同的稠密检索器
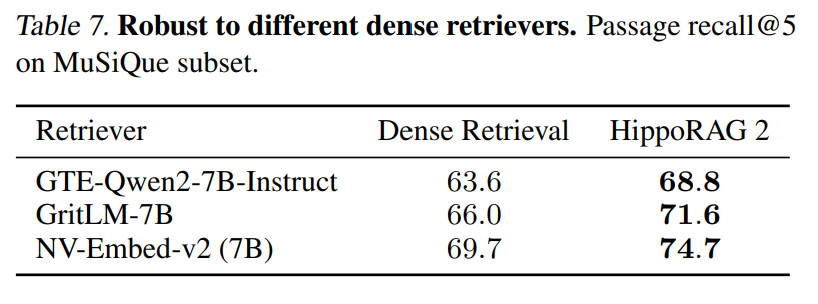
实验结果:
对纯稠密检索的持续超越:在接入不同类型的稠密检索器时,HippoRAG 2 的检索表现均持续优于对应的直接稠密向量检索。
对底层模型的稳健性:HippoRAG 2 带来的性能提升并不依赖于某一款特定的稠密检索器,表明该框架具备良好的适配灵活性与跨检索器泛化能力。
定性分析
作者用两个案例直观展示了纯向量检索与 HippoRAG 2 在不同推理深度任务上的检索机制差异。
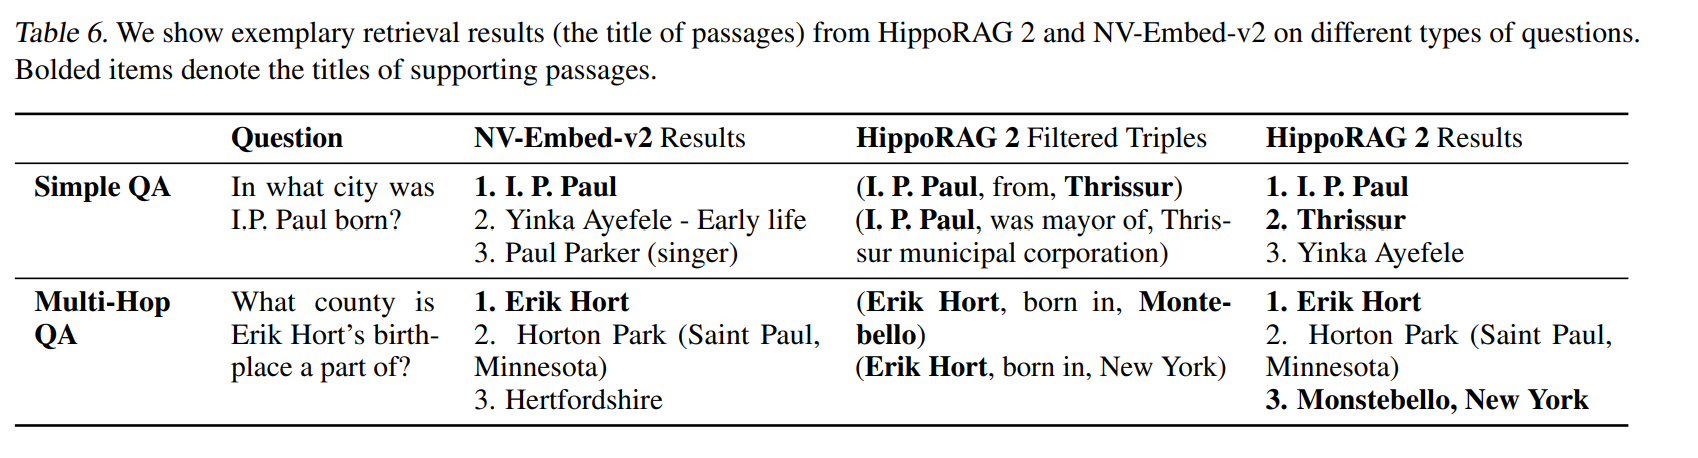
简单事实问答案例
测试问题:“I. P. Paul 出生在哪个城市?”
NV-Embed-v2 表现:将包含查询实体 “I. P. Paul” 的段落排在第 1 位,该段落的信息已足以回答问题。
HippoRAG 2 表现:在三元组连接阶段直接定位到了答案实体 “Thrissur”,并在后续图搜索中将对应的实体段落排在第 2 位,实现了精确命中。
多跳联想问答案例
测试问题:“Erik Hort 的出生地属于哪个县?”
NV-Embed-v2 的局限:能够定位到问题中提及的人物 “Erik Hort”,但由于该问题需要两步关联推理(先获知出生地地名,再推导该地名属于哪个县),仅靠单步匹配人物段落无法完整回答问题。
HippoRAG 2 的优势:在 Query-to-Triple 阶段即检索到了题为 “Montebello” 的段落(该段落包含回答问题所需的地理层级从属信息),并在随后的图搜索中将该段落排在首位,完成了跨跳跃实体的信息关联。
4. 结论
作者在这项研究中提出了 HippoRAG-2 ,这是一个新颖的框架,旨在解决现有 RAG 系统在模拟人类长期记忆的动态与互联特性时所存在的局限。它结合了 PPR 算法的优势、更深度的段落整合,以及在在线阶段对 LLM 的有效运用。通过在事实性记忆、意义构建和联想记忆任务上相较于标准 RAG 方法取得全面提升,HippoRAG 2 展现了以往方法在全面评估中所忽视或未能实现的能力,为大语言模型的持续学习与长期记忆研究开辟了新途径。未来的工作可以考虑利用基于图的检索方法,进一步增强大语言模型在长对话中的情景记忆能力。